Phân cụm vector của các truy vấn tìm kiếm: xây dựng hệ thống của riêng bạn với ChromaDB, embeddings và Python


Markus_automation
Expert in data parsing and automation
Phân nhóm (clustering) là một trong những giai đoạn tốn nhiều công sức nhất khi làm việc với dữ liệu ngữ nghĩa. Việc thu thập và làm sạch một nhóm các truy vấn tương đối đơn giản, nhưng việc phân phối chính xác hàng nghìn từ khóa vào các nhóm có cùng ý định tìm kiếm lại khó khăn hơn nhiều.
Các công cụ phân nhóm như Rush Analytics, Key.so và Key Collector giúp đơn giản hóa nhiệm vụ này, nhưng chúng có những hạn chế về khối lượng, cài đặt và chất lượng kết quả. Điều này đặc biệt đáng chú ý trong các phân khúc phức tạp, nơi các thuật toán tự động có thể kết hợp các truy vấn có ý định khác nhau hoặc chia tách các cụm từ rất gần nhau về mặt ý nghĩa.
Phương pháp tiếp cận bằng mạng thần kinh nhân tạo giúp giải quyết nhiệm vụ này theo một cách khác. Thay vì so sánh các từ riêng lẻ và các điểm trùng khớp về mặt từ vựng, các truy vấn được chuyển đổi thành các vectơ đa chiều gọi là embedding. Chúng có thể được so sánh bằng sự tương đồng về mặt ngữ nghĩa và được sử dụng để tự động hình thành các nhóm.
Trong bài viết này, chúng ta sẽ tìm hiểu cách xây dựng quy trình phân nhóm có thể mở rộng của riêng bạn trên máy tính cục bộ hoặc máy chủ—từ việc thu thập tự động dữ liệu ngữ nghĩa và SERP bằng cách sử dụng trình duyệt chống phát hiện đến việc vectơ hóa, nhóm và hậu xử lý kết quả.
Nội dung
Duy trì danh tính ẩn trực tuyến của bạn với Octo Browser. Dấu vân tay số thật của bạn sẽ không thể bị truy vết.
Bạn có muốn thử trải nghiệm Octo Browser với giá ưu đãi không?
Sử dụng mã khuyến mại OCTOBLOG để được giảm giá 30% cho bất kỳ gói đăng ký nào. Ưu đãi này chỉ dành riêng cho người dùng mới.
Thu thập dữ liệu ngữ nghĩa
Có một vài cách tiếp cận để thu thập dữ liệu ngữ nghĩa, nhưng quy trình cơ bản thường được xây dựng xung quanh cùng một mô hình: trước tiên, một nhóm truy vấn ban đầu được tạo bằng các dịch vụ như Google Ads Keyword Planner và các công cụ khác cung cấp dữ liệu lượng tìm kiếm cho chủ đề liên quan.
Nhóm ban đầu sau đó được mở rộng bằng các truy vấn liên quan, gợi ý tìm kiếm và các nguồn ngữ nghĩa bổ sung. Key Collector thường được sử dụng cho các tác vụ tương tự trong quá khứ, nhưng ngày nay thường cần phải kết hợp nhiều công cụ hoặc sử dụng các tập lệnh tùy chỉnh để thu thập dữ liệu cần thiết.
Sử dụng các công cụ tự động hóa để thu thập dữ liệu ngữ nghĩa
Nếu các giải pháp thương mại không phù hợp với ngân sách, yêu cầu chức năng hoặc các hạn chế của bạn, bạn có thể tự mình tự động hóa một phần quy trình thu thập ngữ nghĩa. Ví dụ: để lấy các gợi ý tìm kiếm và dữ liệu khác từ giao diện web, bạn có thể sử dụng các trình duyệt không đầu dựa trên Puppeteer hoặc Playwright.
Nếu bạn đang thu thập dữ liệu ngữ nghĩa trên một số lượng lớn các phiên song song, bạn cần quản lý các hồ sơ trình duyệt và môi trường của chúng một cách an toàn. Tại đây, bạn có thể sử dụng một trình duyệt chống phát hiện như Octo Browser để cô lập các phiên, quản lý cài đặt hồ sơ và kết nối các proxy khác nhau. Điều này đơn giản hóa cơ sở hạ tầng cào dữ liệu và giảm bớt lượng cấu hình thủ công cần thiết cho mỗi phiên bản trình duyệt riêng lẻ.
Thách thức chính khi thu thập dữ liệu ở quy mô lớn là các hạn chế do các công cụ tìm kiếm áp đặt. Các yêu cầu tự động có thể kích hoạt giới hạn tần suất, CAPTCHA hoặc các cơ chế bảo vệ khác, vì vậy khi thiết kế một quy trình như vậy, bạn cần tính đến tính ổn định của phiên, tần suất yêu cầu và các lệnh chặn tạm thời.
Khi làm việc với tự động hóa trình duyệt, việc kiểm soát các thông số môi trường như User-Agent, kích thước cửa sổ, ngôn ngữ vùng, WebGL và các đặc điểm phiên trình duyệt khác cũng rất quan trọng. Bạn có thể thực hiện việc này bằng cách sử dụng cấu hình Puppeteer hoặc Playwright của riêng bạn hoặc các giải pháp trình duyệt chuyên dụng cho phép bạn tạo các hồ sơ cô lập với các thông số môi trường khác nhau.
Một tác vụ riêng biệt khác là tổ chức cơ sở hạ tầng mạng. Bạn có thể sử dụng các loại proxy khác nhau để thu thập dữ liệu phân tán: trung tâm dữ liệu (datacenter), dân cư (residential) hoặc di động (mobile). Sự lựa chọn phụ thuộc vào lượng yêu cầu và các yêu cầu về tính ổn định, tốc độ và chi phí. Proxy trung tâm dữ liệu thường rẻ hơn và nhanh hơn, nhưng trong một số trường hợp nhất định, chúng có nhiều khả năng bị hạn chế hơn. Các địa chỉ dân cư và di động nhìn chung có khả năng phục hồi tốt hơn, nhưng chúng có chi phí cao hơn và cung cấp thông lượng thấp hơn.
Sau khi việc thu thập dữ liệu chính hoàn tất, bạn có thể bổ sung vào danh sách truy vấn cuối cùng bằng dữ liệu từ các cơ sở dữ liệu ngữ nghĩa bên ngoài. Kết quả thu được phải là một tập hợp các truy vấn đầy đủ nhất có thể, sau đó có thể được chuyển sang các giai đoạn làm sạch, chuẩn hóa và phân cụm sâu hơn.
Làm sạch dữ liệu trước khi vector hóa
Sau khi thu thập dữ liệu ngữ nghĩa, bạn sẽ có một tệp chứa hàng chục nghìn truy vấn tìm kiếm. Thoạt nhìn, nó có vẻ đã sẵn sàng cho việc vector hóa và phân cụm, nhưng chất lượng của kết quả phụ thuộc rất nhiều vào mức độ dữ liệu được chuẩn bị tốt trước đó.
Ở giai đoạn này, các thư viện Pandas và NumPy rất tiện lợi để làm sạch và chuẩn hóa tập dữ liệu đầu vào. Một danh sách truy vấn thô hầu như luôn chứa các bản trùng lặp, các ký tự không cần thiết, rác kỹ thuật, các cụm từ không liên quan và các thành phần giả khác xuất hiện trong quá trình phân tích cú pháp và hợp nhất nhiều nguồn dữ liệu.
Mô hình nhúng dù sao cũng sẽ chuyển đổi các chuỗi này thành các vector, nhưng điều này tạo ra chi phí tính toán không cần thiết và có thể làm giảm chất lượng cấu hình của các cụm kết quả. Đó là lý do tại sao bạn nên đưa dữ liệu về một định dạng nhất quán và dễ đoán trước khi thực hiện vector hóa.
Các giai đoạn chuẩn bị chính như sau:
Loại bỏ rác kỹ thuật. Các thẻ HTML, khoảng trắng thừa, ký tự ẩn, biểu tượng cảm xúc và các yếu tố khác có thể đã lọt vào dữ liệu trong quá trình cào dữ liệu sẽ bị loại bỏ.
Loại bỏ trùng lặp toàn cục. Khi kết hợp các truy vấn từ nhiều nguồn, việc trùng lặp là gần như không thể tránh khỏi. Việc vector hóa các chuỗi giống hệt nhau nhiều hơn một lần là không có ý nghĩa, vì vậy các bản trùng lặp hoàn toàn nên được loại bỏ trước.
Lọc từ dừng (Stop-word). Ở giai đoạn này, bạn có thể loại trừ các truy vấn chứa tên địa danh không liên quan, các nhãn không mong muốn hoặc các từ không phù hợp với yêu cầu của dự án. Ví dụ: dữ liệu ngữ nghĩa thương mại có thể loại trừ các truy vấn có các từ như “miễn phí”, “torrent” và các từ sửa đổi tương tự.
Đưa các từ về dạng từ điển (lemmatization) là tùy chọn. Các mô hình hiện đại hiểu rất tốt các dạng khác nhau của cùng một từ và các cụm từ tương đương. Ví dụ, chúng có thể nhận biết rằng “mua iPhone” và “tôi muốn mua một chiếc iPhone” gần như là cùng một truy vấn. Vì vậy, không cần thiết phải cố ý thay đổi từ trước khi xử lý. Tuy nhiên, việc tiền xử lý đơn giản có thể giúp xác định các truy vấn tương tự và giảm lượng dữ liệu.
Kết quả thu được phải là một tập hợp các truy vấn duy nhất sạch sẽ và đã được lọc, không có nhiễu kỹ thuật rõ ràng. Dữ liệu sau đó có thể được chuyển sang giai đoạn tiếp theo—chuyển đổi văn bản thành các biểu diễn vector.
Vector hóa các truy vấn tìm kiếm
Phân cụm vector khác với so sánh chuỗi truyền thống vì nó không hoạt động với các khớp từ chính xác, mà hoạt động với các biểu diễn ngữ nghĩa của chúng. Mỗi truy vấn tìm kiếm được chuyển đổi thành một vector số—một vector nhúng (embedding)—mã hóa các đặc điểm ngữ nghĩa của nó.
Các mô hình nhúng chuyên dụng được sử dụng cho việc này. Văn bản trước tiên được chia thành các token, sau đó mô hình sẽ tạo ra một vector có số chiều cố định. Kết quả là, các truy vấn tương tự nhau về mặt ngữ nghĩa được định vị gần nhau hơn trong không gian vector.
Ví dụ, các cụm từ “mua iPhone 15” và “giá iPhone 15 Pro” sẽ có các vector tương tự nhau hơn là “mua iPhone 15” và “sửa chữa điện thoại Apple”. Đặc tính này giúp có thể sử dụng các thuật toán phân cụm để nhóm các truy vấn lại với nhau.
Các giải pháp thương mại (OpenAI, Claude)
Để vector hóa, bạn có thể sử dụng cả API đám mây và các mô hình cục bộ. Sự lựa chọn phụ thuộc vào lượng dữ liệu, yêu cầu chất lượng, cơ sở hạ tầng sẵn có và chi phí xử lý có thể chấp nhận được.
Các API thương mại rất tiện lợi vì chúng không yêu cầu triển khai mô hình cục bộ và cho phép bạn bắt đầu nhanh chóng. Nhà cung cấp sẽ chăm sóc cơ sở hạ tầng, cập nhật mô hình và mở rộng quy mô tính toán.
Đối với các tập dữ liệu vừa và nhỏ, đây là một trong những giải pháp đơn giản nhất. Tuy nhiên, khi xử lý hàng trăm nghìn hoặc hàng triệu truy vấn, bạn cần xem xét chi phí API, giới hạn yêu cầu và thông lượng.
Ngoài ra, làm việc với các API đòi hỏi một kiến trúc có khả năng chịu lỗi (vượt qua các giới hạn API bằng cách sử dụng nhiều tài khoản, xoay vòng khóa và các yêu cầu không đồng bộ thông qua aiohttp).
Bạn có thể tự mình kiểm tra cách các mạng thần kinh thương mại hoạt động với các truy vấn của bạn bằng cách sử dụng mã sau:
import os
from openai import OpenAI

# Khởi tạo client
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Tập dữ liệu thô của chúng tôi
queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

# 1. Vector hóa các truy vấn thông qua OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# Kết quả là một tập hợp các vector đa chiều đã sẵn sàng
embeddings = [data.embedding for data in response.data]
import os
from openai import OpenAI

# Khởi tạo client
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Tập dữ liệu thô của chúng tôi
queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

# 1. Vector hóa các truy vấn thông qua OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# Kết quả là một tập hợp các vector đa chiều đã sẵn sàng
embeddings = [data.embedding for data in response.data]
Các mô hình cục bộ từ hệ sinh thái Hugging Face
Một giải pháp thay thế cho các API thương mại là các mô hình nhúng mở chạy cục bộ. Ví dụ: đối với các tác vụ đa ngôn ngữ, bạn có thể sử dụng jinaai/jina-embeddings-v3 hoặc Alibaba-NLP/gte-multilingual-large, những mô hình này không phát sinh chi phí cho mỗi lần tạo.
from sentence_transformers import SentenceTransformer

print("⏳ 1. Đang tải mô hình BGE-m3 ổn định...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

print(f"⏳ 2. Đang vector hóa {len(queries)} truy vấn...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Đã xong! Hãy xem kết quả:")
print(f"📊 Kích thước dữ liệu: {embeddings.shape}")
print("🔍 Vector cho cụm từ 'buy iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... và thêm {len(embeddings[0]) - 5} số khác.")
from sentence_transformers import SentenceTransformer

print("⏳ 1. Đang tải mô hình BGE-m3 ổn định...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

print(f"⏳ 2. Đang vector hóa {len(queries)} truy vấn...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Đã xong! Hãy xem kết quả:")
print(f"📊 Kích thước dữ liệu: {embeddings.shape}")
print("🔍 Vector cho cụm từ 'buy iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... và thêm {len(embeddings[0]) - 5} số khác.")
Ưu điểm chính của các mô hình cục bộ là toàn bộ quy trình xử lý nằm trong cơ sở hạ tầng của riêng bạn. Bạn xử lý các truy vấn tìm kiếm mà không cần gửi chúng đến API của bên thứ ba, và một khi mô hình được tải, bạn có thể vector hóa chúng mà không phải trả phí cho từng yêu cầu riêng lẻ.
Làm việc với các mô hình cục bộ thường hiệu quả hơn về mặt chi phí: chúng cho phép bạn thực hiện vector hóa mà không phải trả tiền cho mỗi cuộc gọi API. Đồng thời, chúng đòi hỏi một lượng không gian đĩa đáng kể: cùng với trọng số mô hình và bộ nhớ đệm, chúng có thể chiếm tới vài gigabyte. Nếu bạn không còn cần một mô hình nữa, bạn nên xóa các tệp cục bộ của nó và xóa bộ nhớ đệm sau khi hoàn tất công việc.
Lưu trữ và tìm kiếm các biểu diễn vector
Sau khi vector hóa, mỗi truy vấn tìm kiếm được biểu diễn dưới dạng một vector nhúng. Câu hỏi tiếp theo là lưu trữ dữ liệu này ở đâu và làm thế nào để tìm kiếm các truy vấn tương tự về mặt ngữ nghĩa một cách hiệu quả.
Đối với các tập dữ liệu nhỏ, các vector có thể nằm trong bộ nhớ, ví dụ như trong các mảng NumPy hoặc các cấu trúc Pandas. Nếu chỉ có vài nghìn truy vấn, điều này thường là đủ cho các thử nghiệm và xử lý cục bộ.
Khi tập dữ liệu lớn dần, tình hình sẽ thay đổi. Nếu mỗi vector được so sánh trực tiếp với tất cả các vector khác, số lượng thao tác sẽ tăng theo hàm mũ bậc hai. Đối với hàng chục hoặc hàng trăm nghìn truy vấn, việc này sẽ nhanh chóng trở nên tốn tài nguyên về cả thời gian tính toán và mức sử dụng bộ nhớ.
Vấn đề này được giải quyết bằng các cơ sở dữ liệu vector. Chúng được tối ưu hóa đặc biệt cho các tác vụ như vậy và hỗ trợ các thuật toán tìm kiếm láng giềng gần nhất xấp xỉ (đặc biệt là HNSW). Các chỉ mục tích hợp sẵn giúp tránh việc so sánh trực tiếp mọi vector với nhau và cung cấp các tìm kiếm gần như tức thì cho các cụm từ tương tự nhất ngay cả trong hàng triệu bản ghi.
Có một số giải pháp phổ biến cho các tác vụ này: Pinecone, Qdrant, PostgreSQL với phần mở rộng pgvector, và các giải pháp khác. Trong ví dụ của mình, chúng tôi sẽ sử dụng ChromaDB. Nó rất phù hợp cho các thử nghiệm cục bộ: hoạt động mà không cần máy chủ riêng biệt, lưu trữ dữ liệu trên đĩa và dễ dàng tích hợp với mã Python.
Hãy lưu các vector nhúng thu được ở giai đoạn trước và kiểm tra xem tìm kiếm ngữ nghĩa hoạt động như thế nào:
import chromadb

# 1. Khởi tạo cơ sở dữ liệu cục bộ (tạo thư mục semantic_db)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Tạo collection
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Tải các vector và văn bản truy vấn của chúng tôi lên
collection.add(
    embeddings=embeddings.tolist(), # các vector từ mô hình BGE-m3 cục bộ của chúng tôi
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Dữ liệu đã được lưu vào cơ sở dữ liệu!\n")

# ==========================================
# PHÉP THUẬT TÌM KIẾM: hãy kiểm tra cách cơ sở dữ liệu hiểu ý nghĩa
# ==========================================
test_phrase = "how much does the new iphone cost"
print(f"Đang tìm kiếm trong cơ sở dữ liệu cho cụm từ: '{test_phrase}'")

# Chuyển đổi cụm từ kiểm tra thành vector bằng cùng một mô hình
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Yêu cầu cơ sở dữ liệu tìm hai tùy chọn tương tự nhất
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Truy vấn gần nhất: {results['documents'][0][0]} (Khoảng cách: {results['distances'][0][0]:.4f})")
print(f"Gần thứ hai: {results['documents'][0][1]} (Khoảng cách: {results['distances'][0][1]:.4f})")
import chromadb

# 1. Khởi tạo cơ sở dữ liệu cục bộ (tạo thư mục semantic_db)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Tạo collection
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Tải các vector và văn bản truy vấn của chúng tôi lên
collection.add(
    embeddings=embeddings.tolist(), # các vector từ mô hình BGE-m3 cục bộ của chúng tôi
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Dữ liệu đã được lưu vào cơ sở dữ liệu!\n")

# ==========================================
# PHÉP THUẬT TÌM KIẾM: hãy kiểm tra cách cơ sở dữ liệu hiểu ý nghĩa
# ==========================================
test_phrase = "how much does the new iphone cost"
print(f"Đang tìm kiếm trong cơ sở dữ liệu cho cụm từ: '{test_phrase}'")

# Chuyển đổi cụm từ kiểm tra thành vector bằng cùng một mô hình
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Yêu cầu cơ sở dữ liệu tìm hai tùy chọn tương tự nhất
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Truy vấn gần nhất: {results['documents'][0][0]} (Khoảng cách: {results['distances'][0][0]:.4f})")
print(f"Gần thứ hai: {results['documents'][0][1]} (Khoảng cách: {results['distances'][0][1]:.4f})")
Chọn một thuật toán phân cụm
Khi các vector nhúng đã được thu thập, bạn có thể chuyển sang giai đoạn tiếp theo—nhóm các truy vấn tìm kiếm. Ở giai đoạn này, điều quan trọng là chọn một thuật toán phù hợp với cấu trúc dữ liệu và không đòi hỏi các giả định quá cứng nhắc về số lượng cụm trong tương lai.
Tại sao K-Means không phải lúc nào cũng phù hợp cho phân cụm SEO
K-Means là một thuật toán phân cụm cổ điển chia dữ liệu thành một số lượng nhóm được xác định trước. Số lượng cụm được chỉ định bằng tham số k.
Ví dụ: nếu chúng ta có 10.000 truy vấn tìm kiếm và chỉ định k=500, thuật toán sẽ tạo ra 500 tâm cụm (centroids) và gán mỗi truy vấn cho tâm cụm gần nhất trong không gian vector.
Hạn chế chính của phương pháp này là số lượng cụm phải được xác định trước. Điều này không phải lúc nào cũng thuận tiện cho một cấu trúc ngữ nghĩa cốt lõi: trước khi quá trình xử lý bắt đầu, rất khó để biết tập dữ liệu chứa bao nhiêu nhóm ý định độc lập—50, 500, hay 1.200.
Nếu k được chọn không tốt, các truy vấn liên quan có thể bị chia tách thành nhiều nhóm khác nhau. Điều ngược lại cũng có thể xảy ra: các truy vấn có chủ đề gần giống nhau nhưng khác nhau về ý định có thể bị gộp lại với nhau chỉ vì thuật toán phải tạo ra đúng số lượng cụm đã chỉ định.
Phân cụm với DBSCAN
Nếu số lượng nhóm không được biết trước, bạn có thể sử dụng các thuật toán phân cụm dựa trên mật độ. Một trong những giải pháp nổi tiếng nhất là DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
Không giống như K-Means, DBSCAN không yêu cầu bạn chỉ định trước số lượng cụm. Thuật toán sẽ tìm kiếm các vùng trong không gian vector nơi các đối tượng đủ gần nhau và tạo thành các nhóm từ chúng.
Hành vi của DBSCAN được xác định bởi hai thông số chính:
eps(epsilon/khoảng cách): khoảng cách tối đa giữa các điểm mà tại đó chúng được coi là láng giềng của nhau. Trong trường hợp của chúng tôi, đây là ngưỡng tương đồng cosine của các vector.min_samples: số lượng láng giềng tối thiểu cần thiết để tạo thành một cụm hoàn chỉnh.
DBSCAN lấy một truy vấn ngẫu nhiên đầu tiên. Nếu có min_samples các truy vấn khác trong bán kính eps của nó, một lõi cụm sẽ được hình thành. Thuật toán sau đó mở rộng theo mọi hướng, thêm các láng giềng mới cho đến khi mật độ không còn nữa.
Tham số eps có thể được so sánh một cách đại khái với mức độ nghiêm ngặt của việc phân cụm:
Một giá trị
epsnhỏ hơn tương ứng với việc nhóm nghiêm ngặt hơn. Chỉ các truy vấn có biểu diễn vector rất giống nhau mới nằm trong cùng một cụm, vì vậy bạn thường có nhiều nhóm hơn và chúng trở nên gọn gàng hơn.Một giá trị
epslớn hơn giúp các điều kiện gộp lỏng lẻo hơn. Các cụm trở nên lớn hơn và có thể bao gồm các ngữ nghĩa rộng hơn, nhưng nguy cơ kết hợp các truy vấn có ý định khác nhau cũng tăng lên.
Một đặc tính hữu ích khác của DBSCAN là khả năng xác định nhiễu. Nếu một truy vấn không nằm trong một vùng có mật độ đủ lớn của không gian vector, thuật toán sẽ không cố gắng ép nó vào một trong các cụm hiện có. Thay vào đó, nó đánh dấu truy vấn đó là một Điểm ngoại lai (Outlier). Bạn có thể xuất các truy vấn này sang một tệp riêng để xem xét thủ công thay vì làm ảnh hưởng đến các trang đích sạch sẽ khác.
Đồng thời, DBSCAN nhạy cảm với việc chọn eps: một ngưỡng duy nhất không phải lúc nào cũng hoạt động tốt với dữ liệu trong đó có một số nhóm rất dày đặc và những nhóm khác lại thưa thớt hơn nhiều.
Trong những trường hợp như vậy, hãy cân nhắc sử dụng HDBSCAN, một phần mở rộng phân cấp của phương pháp dựa trên mật độ. Nó có thể tìm thấy các cụm có mật độ khác nhau, tự động điều chỉnh tham số eps ở những nơi các truy vấn được xếp chặt chẽ hơn hoặc ngược lại, phân tán hơn.
Kịch bản phân cụm
Hãy trích xuất các vector của chúng ta từ cơ sở dữ liệu ChromaDB cục bộ và chạy chúng qua DBSCAN bằng thư viện scikit-learn:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Đang kết nối tới cơ sở dữ liệu vector...")
client = chromadb.PersistentClient(path="./semantic_db")

# Trích xuất collection chứa các vector (sử dụng tên của riêng bạn)
collection = client.get_collection(name="search_queries")

# Trích xuất tất cả các văn bản truy vấn và các vector toán học của chúng
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Đã trích xuất các truy vấn từ cơ sở dữ liệu: {len(documents)}")

# ==========================================
# PHÂN CỤM (DBSCAN)
# ==========================================
print("⏳ 2. Bắt đầu thuật toán DBSCAN...")

# CÀI ĐẶT:
# eps = 0.15 (Khoảng cách cosine được phép. Càng nhỏ, các cụm càng nghiêm ngặt);
# min_samples = 2 (Tối thiểu 2 truy vấn để tạo một nhóm);
# metric="cosine" (Chúng tôi chỉ định rõ ràng rằng chúng tôi đo góc giữa các vector, không phải khoảng cách tuyến tính).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Chạy phân nhóm
labels = dbscan.fit_predict(embeddings)

# ==========================================
# KẾT QUẢ ĐẦU RA
# ==========================================
# Thuật toán đã gán cho mỗi truy vấn một số nhóm (0, 1, 2...).
# Nếu một truy vấn được nhận dạng là nhiễu (Outlier), nó sẽ nhận nhãn -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== KẾT QUẢ PHÂN NHÓM ===")
for cluster_id, docs in clusters.items():
    print(f"\n Cụm #{cluster_id} (Truy vấn: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Điểm ngoại lai/Nhiễu (Truy vấn: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Đang kết nối tới cơ sở dữ liệu vector...")
client = chromadb.PersistentClient(path="./semantic_db")

# Trích xuất collection chứa các vector (sử dụng tên của riêng bạn)
collection = client.get_collection(name="search_queries")

# Trích xuất tất cả các văn bản truy vấn và các vector toán học của chúng
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Đã trích xuất các truy vấn từ cơ sở dữ liệu: {len(documents)}")

# ==========================================
# PHÂN CỤM (DBSCAN)
# ==========================================
print("⏳ 2. Bắt đầu thuật toán DBSCAN...")

# CÀI ĐẶT:
# eps = 0.15 (Khoảng cách cosine được phép. Càng nhỏ, các cụm càng nghiêm ngặt);
# min_samples = 2 (Tối thiểu 2 truy vấn để tạo một nhóm);
# metric="cosine" (Chúng tôi chỉ định rõ ràng rằng chúng tôi đo góc giữa các vector, không phải khoảng cách tuyến tính).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Chạy phân nhóm
labels = dbscan.fit_predict(embeddings)

# ==========================================
# KẾT QUẢ ĐẦU RA
# ==========================================
# Thuật toán đã gán cho mỗi truy vấn một số nhóm (0, 1, 2...).
# Nếu một truy vấn được nhận dạng là nhiễu (Outlier), nó sẽ nhận nhãn -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== KẾT QUẢ PHÂN NHÓM ===")
for cluster_id, docs in clusters.items():
    print(f"\n Cụm #{cluster_id} (Truy vấn: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Điểm ngoại lai/Nhiễu (Truy vấn: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
Ví dụ trên sử dụng mô hình cục bộ, nhưng khi làm việc với các mô hình nhúng thương mại, giá trị eps có thể cần điều chỉnh bổ sung. Cụ thể, ngưỡng 0.15 hoạt động tốt cho mô hình này có thể, với cấu hình khác, khiến một phần đáng kể các truy vấn gộp lại thành một cụm lớn hoặc bị phân loại sai thành nhiễu.
Do đó, bất cứ khi nào bạn chuyển đổi mô hình, bạn nên điều chỉnh riêng eps dựa trên sự phân bố khoảng cách giữa các vector và chất lượng thực tế của các nhóm kết quả.
Phân cụm kết hợp để tách biệt các ý định tìm kiếm
Phân cụm có thể được thực hiện chỉ bằng các vector nhúng, nhưng trên thực tế điều này thường là không đủ. Sự tương đồng về mặt ngữ nghĩa không phải lúc nào cũng có nghĩa là ý định tìm kiếm giống nhau.
Ví dụ: các truy vấn “mua trình duyệt chống phát hiện” và “trình duyệt chống phát hiện là gì” có chủ đề rất gần nhau. Mô hình nhúng nhận dạng chính xác rằng cả hai cụm từ đều đề cập đến cùng một đối tượng, vì vậy khoảng cách giữa các vector của chúng sẽ nhỏ. Kết quả là DBSCAN rất có thể sẽ xếp các truy vấn đó vào một cụm.
Đứng từ góc độ SEO, điều này không mong muốn vì ý định là khác nhau. Ý định thứ nhất ngụ ý một trang đích thương mại, trong khi ý định thứ hai ngụ ý nội dung thông tin.
Hãy chứng minh điều này bằng một tập dữ liệu thử nghiệm nhỏ:
queries = [
    # Thông tin
    "what are antidetect browsers for",
    "what is an antidetect browser",
    "how antidetect browsers work",
    "antidetect browsers comparison",

    # Thương mại
    "buy an anti-detect browser",
    "buy proxies for an anti-detect browser",
    "anti-detect browser trial",

    # Tải về
    "download anti-detect browser octo browser",
    "octo browser anti-detect browser download",
    "octo anti-detect browser download",

    # Các truy vấn về một chủ đề khác
    "ford everest 2024 review",
    "buy used ford everest",

    # Nhiễu
    "weather in pattaya in May",
    "tom yum soup recipe"
]
queries = [
    # Thông tin
    "what are antidetect browsers for",
    "what is an antidetect browser",
    "how antidetect browsers work",
    "antidetect browsers comparison",

    # Thương mại
    "buy an anti-detect browser",
    "buy proxies for an anti-detect browser",
    "anti-detect browser trial",

    # Tải về
    "download anti-detect browser octo browser",
    "octo browser anti-detect browser download",
    "octo anti-detect browser download",

    # Các truy vấn về một chủ đề khác
    "ford everest 2024 review",
    "buy used ford everest",

    # Nhiễu
    "weather in pattaya in May",
    "tom yum soup recipe"
]
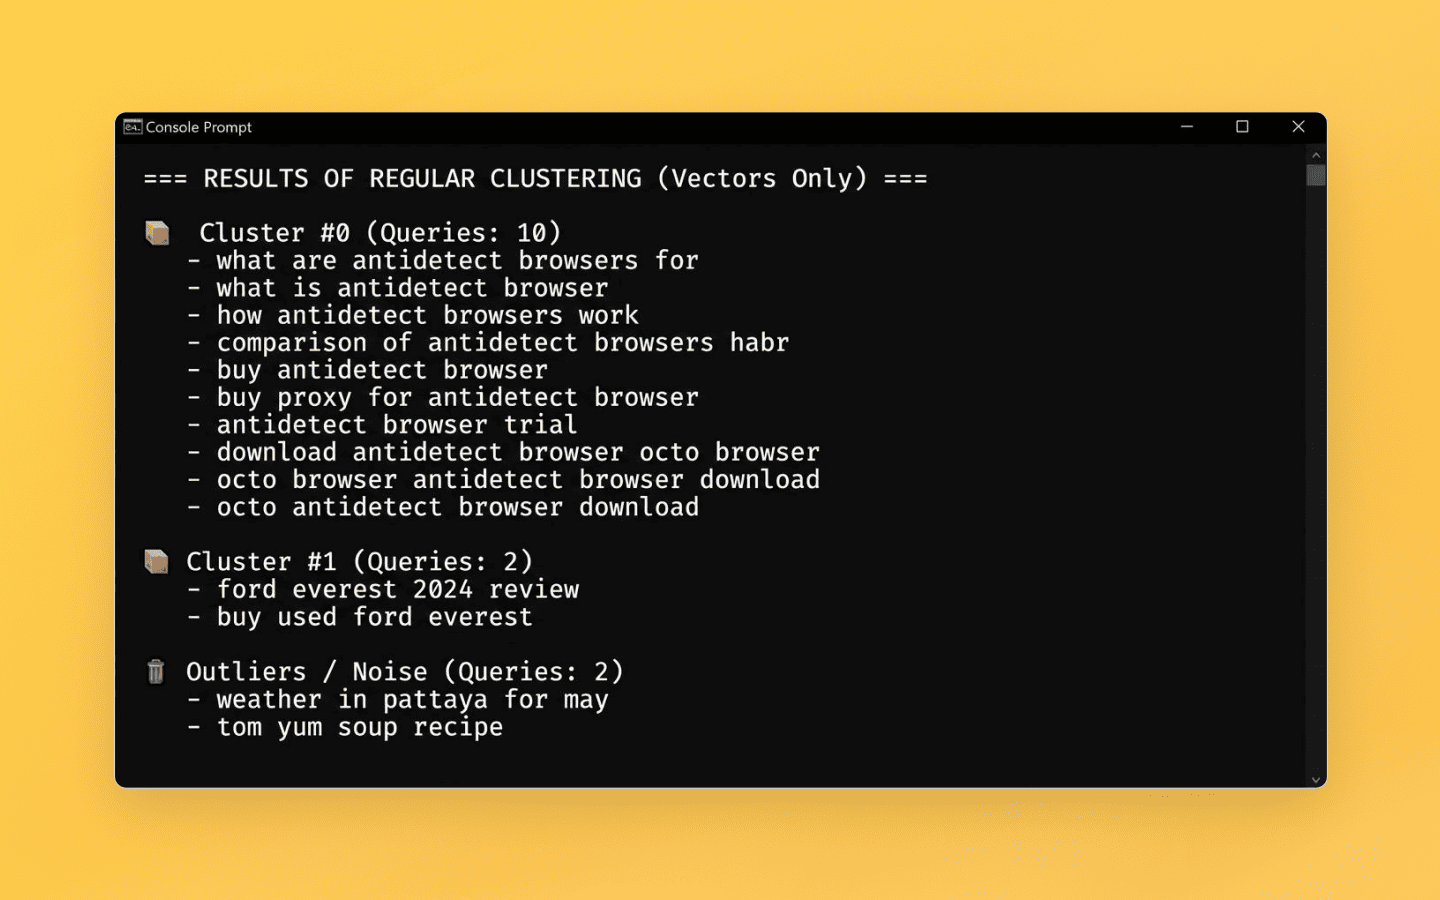
Khi chỉ phân cụm theo độ tương đồng vector, các truy vấn liên quan đến trình duyệt chống phát hiện có thể nằm trong cùng một nhóm bất kể sự khác biệt về ý định.
Ở giai đoạn này, trình duyệt chống phát hiện một lần nữa trở thành một phần của quy trình, nhưng không phải để thu thập dữ liệu ngữ nghĩa. Thay vào đó, nó được sử dụng để thu thập dữ liệu SERP. Đối với mỗi truy vấn, bạn cần thu thập kết quả tìm kiếm và sau đó sử dụng sự trùng lặp URL làm tín hiệu phân cụm bổ sung.
Với số lượng truy vấn lớn, việc thu thập này có thể được phân phối thuận tiện trên các hồ sơ trình duyệt cô lập, ví dụ như bằng cách sử dụng Octo Browser cùng với Playwright hoặc Puppeteer.

Đối với mỗi truy vấn, hãy thu thập 10 URL hàng đầu từ kết quả tìm kiếm. Sau đó, trước khi chạy DBSCAN, hãy so sánh kết quả của các cụm từ tương tự về mặt ngữ nghĩa. Nếu hai truy vấn không có URL chung hoặc số lượng của chúng dưới một ngưỡng xác định, khoảng cách giữa các vector tương ứng sẽ được tăng lên một cách nhân tạo.
Do đó, các vector nhúng được sử dụng để tìm các truy vấn tương tự về mặt ngữ nghĩa, trong khi phân tích SERP đóng vai trò như một ràng buộc bổ sung và giúp ngăn chặn các cụm từ có ý định tìm kiếm khác nhau bị gộp lại.
Sau khi thêm dữ liệu kết quả tìm kiếm, tập dữ liệu thử nghiệm được thảo luận trước đó trong bài viết được phân bổ khác đi:
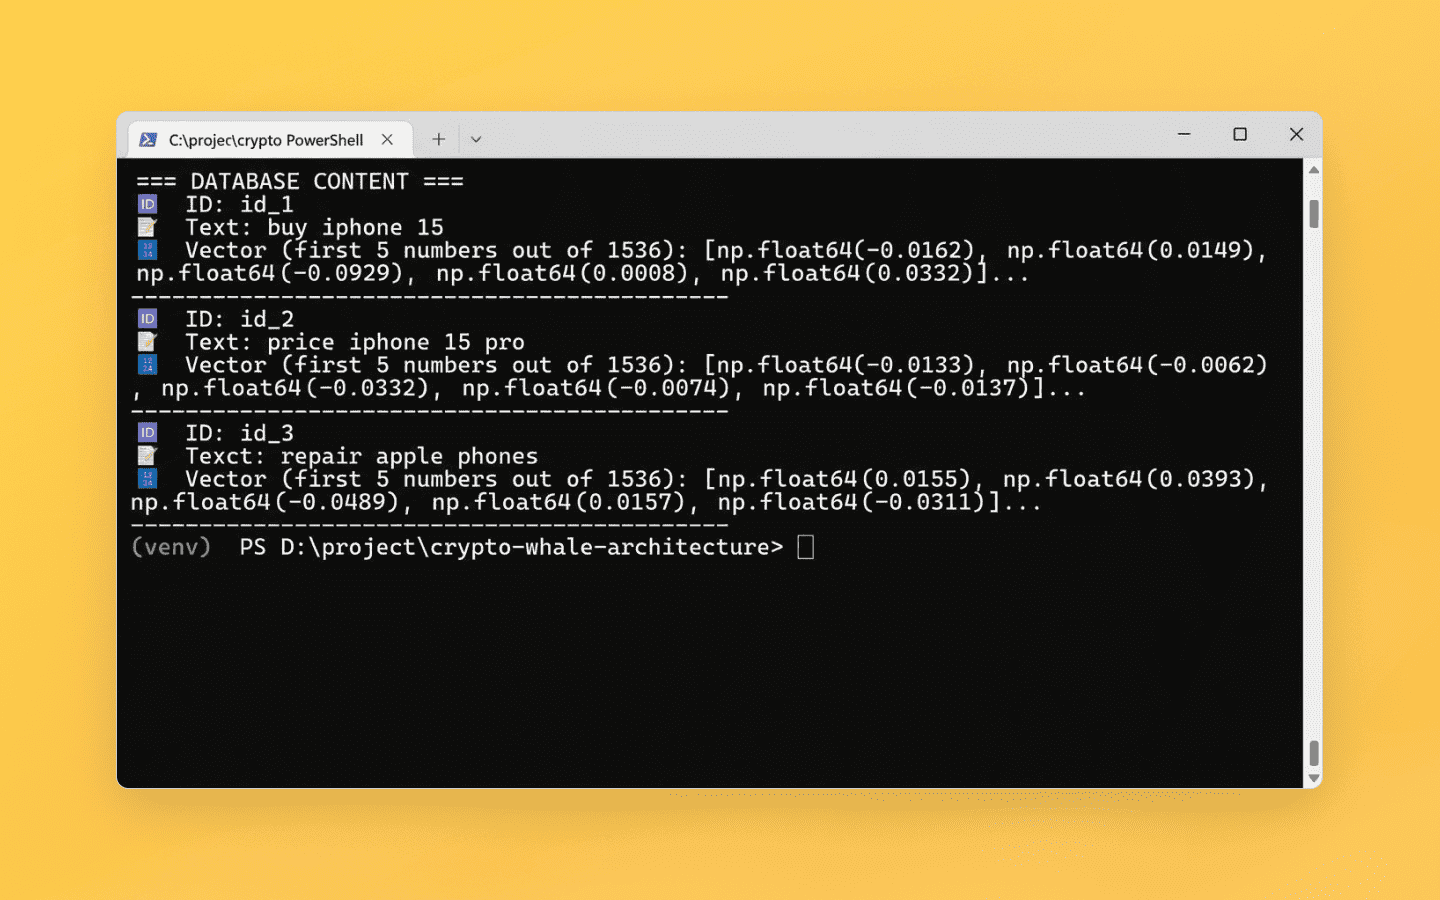
Số lượng cụm tăng lên, và bản thân các nhóm phù hợp hơn với ý định tìm kiếm mong muốn của các truy vấn.
Xử lý hậu kỳ kết quả và cập nhật dữ liệu
Sau khi tạo thành các cụm, có một tác vụ thực tế nữa—gán một cái tên rõ ràng cho mỗi nhóm. Những con số như “Cụm #42” rất thuận tiện cho thuật toán nhưng lại nói lên rất ít điều với một chuyên gia SEO, biên tập viên hoặc người viết nội dung.
Đặt tên cụm tự động bằng LLM
Khi làm việc thủ công, chuyên gia phải xem xét nội dung của từng nhóm, xác định ý định chính và nghĩ ra một cái tên cho trang hoặc mẩu nội dung tương lai. Nếu có hàng trăm cụm, giai đoạn này sẽ tốn một lượng thời gian đáng kể.
Tuy nhiên, phần này của quy trình có thể được tự động hóa bằng LLM. Mô hình nhận một danh sách các truy vấn từ một cụm, xác định ý định tổng thể và tạo ra một tiêu đề thích hợp. Bạn có thể sử dụng các mô hình dựa trên đám mây hoặc các giải pháp cục bộ, ví dụ: Ollama.
Điều quan trọng là phải xác định một định dạng đầu ra nghiêm ngặt trước. Nếu bạn chỉ đơn giản yêu cầu mô hình nghĩ ra một cái tên, bạn có thể nhận được các giải thích và nhận xét bổ sung cùng với tiêu đề. Đó là lý do tại sao tốt hơn hết là nêu rõ ràng trong câu lệnh hệ thống (system prompt) rằng kết quả đầu ra chỉ nên chứa tiêu đề và không có văn bản bổ sung nào khác:
from openai import OpenAI

# 1. KHỞI TẠO VÀ KHÓA
# Chèn khóa API thực tế của bạn vào đây
client_ai = OpenAI(api_key="sk-YOUR_OPENAI_KEY")

# 2. DỮ LIỆU CỦA CHÚNG TÔI (Kết quả của phân cụm kết hợp)
clusters = {
    0: [
       "what are anti-detect browsers for",
       "what is an anti-detect browser",
       "how anti-detect browsers work",
       "anti-detect browsers comparison",
    ],
    1: [
        "buy an anti-detect browser",
        "buy proxies for an anti-detect browser",
        "anti-detect browser trial"
    ],
    2: [
        "download anti-detect browser octo browser",
        "octo browser anti-detect browser download",
        "octo anti-detect browser download"
    ]
}

# System prompt (thiết lập các quy tắc cho mô hình)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Đang gửi các cụm tới GPT-4o-mini để tự động đặt tên...\n")

# 3. Lặp qua tất cả các cụm
for cluster_id, queries in clusters.items():
    # Gửi các truy vấn từ cụm hiện tại tới API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Kết hợp các truy vấn thành một văn bản duy nhất
        ],
        temperature=0.3
    )

    # Nhận phản hồi
    h1_title = response.choices[0].message.content

    # In kết quả ra màn hình điều khiển
    print(f"Cụm #{cluster_id}")
    print(f"Các cụm từ: {', '.join(queries)}")
    print(f"H1 được tạo: {h1_title}\n")
from openai import OpenAI

# 1. KHỞI TẠO VÀ KHÓA
# Chèn khóa API thực tế của bạn vào đây
client_ai = OpenAI(api_key="sk-YOUR_OPENAI_KEY")

# 2. DỮ LIỆU CỦA CHÚNG TÔI (Kết quả của phân cụm kết hợp)
clusters = {
    0: [
       "what are anti-detect browsers for",
       "what is an anti-detect browser",
       "how anti-detect browsers work",
       "anti-detect browsers comparison",
    ],
    1: [
        "buy an anti-detect browser",
        "buy proxies for an anti-detect browser",
        "anti-detect browser trial"
    ],
    2: [
        "download anti-detect browser octo browser",
        "octo browser anti-detect browser download",
        "octo anti-detect browser download"
    ]
}

# System prompt (thiết lập các quy tắc cho mô hình)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Đang gửi các cụm tới GPT-4o-mini để tự động đặt tên...\n")

# 3. Lặp qua tất cả các cụm
for cluster_id, queries in clusters.items():
    # Gửi các truy vấn từ cụm hiện tại tới API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Kết hợp các truy vấn thành một văn bản duy nhất
        ],
        temperature=0.3
    )

    # Nhận phản hồi
    h1_title = response.choices[0].message.content

    # In kết quả ra màn hình điều khiển
    print(f"Cụm #{cluster_id}")
    print(f"Các cụm từ: {', '.join(queries)}")
    print(f"H1 được tạo: {h1_title}\n")
Đối với tập dữ liệu thử nghiệm, kết quả có thể trông như thế này:
Cụm #0
   Các cụm từ: what are anti-detect browsers for, what is an anti-detect browser, how anti-detect browsers work
   H1 được tạo: What are anti-detect browsers used for

Cụm #1
   Các cụm từ: buy an anti-detect browser, buy proxies for an anti-detect browser, anti-detect browser trial
   H1 được tạo: Best anti-detect browsers and proxies for safe browsing

Cụm #2
   Các cụm từ: download anti-detect browser octo browser, octo browser anti-detect browser download, octo anti-detect browser download
   H1 được tạo: Download anti-detect browser Octo Browser
Cụm #0
   Các cụm từ: what are anti-detect browsers for, what is an anti-detect browser, how anti-detect browsers work
   H1 được tạo: What are anti-detect browsers used for

Cụm #1
   Các cụm từ: buy an anti-detect browser, buy proxies for an anti-detect browser, anti-detect browser trial
   H1 được tạo: Best anti-detect browsers and proxies for safe browsing

Cụm #2
   Các cụm từ: download anti-detect browser octo browser, octo browser anti-detect browser download, octo anti-detect browser download
   H1 được tạo: Download anti-detect browser Octo Browser
Trong một dự án thực tế, số lượng cụm sẽ lớn hơn nhiều, vì vậy việc lưu trữ trực tiếp dữ liệu nguồn trong mã là không thực tế. Thông thường, các cụm được tải từ một tệp hoặc cơ sở dữ liệu, và các tên được tạo sẽ được ghi lại vào bảng để làm việc tiếp.
Ở giai đoạn này, LLM không tham gia vào việc phân cụm; nó chỉ được sử dụng để xử lý hậu kỳ các nhóm đã được tạo thành. Điều này tự động hóa phần việc thủ công lặp đi lặp lại và mang lại cho bạn một cấu trúc ngữ nghĩa cốt lõi rõ ràng mà không cần phải đặt tên thủ công cho từng cụm.
Thêm các truy vấn mới
Một ưu điểm khác của việc lưu trữ các vector nhúng trong ChromaDB là khả năng làm việc với dữ liệu mới mà không cần phải thực hiện lại tìm kiếm láng giềng gần nhất trên toàn bộ tập dữ liệu một cách thủ công.
Sau khi nhận được một đợt dữ liệu ngữ nghĩa mới, các truy vấn sẽ đi qua cùng một quy trình: làm sạch, vector hóa và thêm chúng vào ChromaDB. Với mỗi vector nhúng mới, bạn có thể tìm thấy các truy vấn hiện có gần nhất và đánh giá khoảng cách tới chúng.
Nếu các láng giềng gần nhất thuộc về một cụm hiện có ổn định và đáp ứng ngưỡng tương đồng đã xác định, truy vấn mới có thể được thêm vào nhóm đó. Nếu không có cụm nào phù hợp, truy vấn sẽ tiếp tục là ứng cử viên để tạo thành một nhóm mới hoặc được gửi đi để xử lý bổ sung.
Phương pháp này cho phép bạn sử dụng cơ sở dữ liệu vector tích lũy được làm chỉ mục để xử lý các truy vấn mới và tránh việc phải thực hiện tìm kiếm cặp đầy đủ trên toàn bộ cấu trúc ngữ nghĩa cốt lõi mỗi khi nó được cập nhật.
Kết luận
Xây dựng quy trình xử lý của riêng bạn dựa trên các mô hình nhúng, lưu trữ vector và các thuật toán phân cụm sẽ tốn thời gian, vì bạn cần định cấu hình, thử nghiệm và tinh chỉnh nó. Tuy nhiên, một khi việc này hoàn tất, bạn sẽ có được một hệ thống có thể điều chỉnh phù hợp với một chủ đề cụ thể, khối lượng dữ liệu và các yêu cầu của dự án.
Những ưu điểm chính của phương pháp này là:
Giảm sự phụ thuộc vào các dịch vụ chuyên dụng. Bạn không cần một dịch vụ SEO riêng biệt với các gói cố định và giới hạn dung lượng để phân cụm. Các hạn chế chính chuyển sang cơ sở hạ tầng của riêng bạn: tài nguyên tính toán, bộ nhớ và không gian đĩa.
Kiểm soát logic phân cụm. Bạn có thể tự chọn mô hình nhúng, định cấu hình
eps, sử dụng dữ liệu SERP và thay đổi các quy tắc kết hợp truy vấn tùy thuộc vào tác vụ.Kiểm soát dữ liệu. Khi sử dụng các mô hình cục bộ và lưu trữ cục bộ, dữ liệu ngữ nghĩa vẫn nằm trong cơ sở hạ tầng của riêng bạn và không bị gửi đến các API của bên thứ ba.
Giá trị chính của phương pháp này không phải là thay thế hoàn toàn các công cụ SEO có sẵn, mà là khả năng xây dựng quy trình kiểm soát được của riêng bạn. Hãy sử dụng Octo Browser để tự động hóa việc cào dữ liệu ngữ nghĩa và dữ liệu SERP, đồng thời thực hiện phần xử lý còn lại tại cục bộ bằng các vector nhúng, ChromaDB và thuật toán phân cụm.
Một khi bạn xây dựng quy trình này và tinh chỉnh nó cẩn thận bằng dữ liệu thực tế, nó sẽ trở nên giá trị hơn nhiều so với một tập lệnh chạy một lần. Nó biến thành một công cụ làm việc thực sự mà bạn có thể tái sử dụng và mở rộng quy mô khi cấu trúc ngữ nghĩa cốt lõi của bạn phát triển.
Duy trì danh tính ẩn trực tuyến của bạn với Octo Browser. Dấu vân tay số thật của bạn sẽ không thể bị truy vết.
Bạn có muốn thử trải nghiệm Octo Browser với giá ưu đãi không?
Sử dụng mã khuyến mại OCTOBLOG để được giảm giá 30% cho bất kỳ gói đăng ký nào. Ưu đãi này chỉ dành riêng cho người dùng mới.
Thu thập dữ liệu ngữ nghĩa
Có một vài cách tiếp cận để thu thập dữ liệu ngữ nghĩa, nhưng quy trình cơ bản thường được xây dựng xung quanh cùng một mô hình: trước tiên, một nhóm truy vấn ban đầu được tạo bằng các dịch vụ như Google Ads Keyword Planner và các công cụ khác cung cấp dữ liệu lượng tìm kiếm cho chủ đề liên quan.
Nhóm ban đầu sau đó được mở rộng bằng các truy vấn liên quan, gợi ý tìm kiếm và các nguồn ngữ nghĩa bổ sung. Key Collector thường được sử dụng cho các tác vụ tương tự trong quá khứ, nhưng ngày nay thường cần phải kết hợp nhiều công cụ hoặc sử dụng các tập lệnh tùy chỉnh để thu thập dữ liệu cần thiết.
Sử dụng các công cụ tự động hóa để thu thập dữ liệu ngữ nghĩa
Nếu các giải pháp thương mại không phù hợp với ngân sách, yêu cầu chức năng hoặc các hạn chế của bạn, bạn có thể tự mình tự động hóa một phần quy trình thu thập ngữ nghĩa. Ví dụ: để lấy các gợi ý tìm kiếm và dữ liệu khác từ giao diện web, bạn có thể sử dụng các trình duyệt không đầu dựa trên Puppeteer hoặc Playwright.
Nếu bạn đang thu thập dữ liệu ngữ nghĩa trên một số lượng lớn các phiên song song, bạn cần quản lý các hồ sơ trình duyệt và môi trường của chúng một cách an toàn. Tại đây, bạn có thể sử dụng một trình duyệt chống phát hiện như Octo Browser để cô lập các phiên, quản lý cài đặt hồ sơ và kết nối các proxy khác nhau. Điều này đơn giản hóa cơ sở hạ tầng cào dữ liệu và giảm bớt lượng cấu hình thủ công cần thiết cho mỗi phiên bản trình duyệt riêng lẻ.
Thách thức chính khi thu thập dữ liệu ở quy mô lớn là các hạn chế do các công cụ tìm kiếm áp đặt. Các yêu cầu tự động có thể kích hoạt giới hạn tần suất, CAPTCHA hoặc các cơ chế bảo vệ khác, vì vậy khi thiết kế một quy trình như vậy, bạn cần tính đến tính ổn định của phiên, tần suất yêu cầu và các lệnh chặn tạm thời.
Khi làm việc với tự động hóa trình duyệt, việc kiểm soát các thông số môi trường như User-Agent, kích thước cửa sổ, ngôn ngữ vùng, WebGL và các đặc điểm phiên trình duyệt khác cũng rất quan trọng. Bạn có thể thực hiện việc này bằng cách sử dụng cấu hình Puppeteer hoặc Playwright của riêng bạn hoặc các giải pháp trình duyệt chuyên dụng cho phép bạn tạo các hồ sơ cô lập với các thông số môi trường khác nhau.
Một tác vụ riêng biệt khác là tổ chức cơ sở hạ tầng mạng. Bạn có thể sử dụng các loại proxy khác nhau để thu thập dữ liệu phân tán: trung tâm dữ liệu (datacenter), dân cư (residential) hoặc di động (mobile). Sự lựa chọn phụ thuộc vào lượng yêu cầu và các yêu cầu về tính ổn định, tốc độ và chi phí. Proxy trung tâm dữ liệu thường rẻ hơn và nhanh hơn, nhưng trong một số trường hợp nhất định, chúng có nhiều khả năng bị hạn chế hơn. Các địa chỉ dân cư và di động nhìn chung có khả năng phục hồi tốt hơn, nhưng chúng có chi phí cao hơn và cung cấp thông lượng thấp hơn.
Sau khi việc thu thập dữ liệu chính hoàn tất, bạn có thể bổ sung vào danh sách truy vấn cuối cùng bằng dữ liệu từ các cơ sở dữ liệu ngữ nghĩa bên ngoài. Kết quả thu được phải là một tập hợp các truy vấn đầy đủ nhất có thể, sau đó có thể được chuyển sang các giai đoạn làm sạch, chuẩn hóa và phân cụm sâu hơn.
Làm sạch dữ liệu trước khi vector hóa
Sau khi thu thập dữ liệu ngữ nghĩa, bạn sẽ có một tệp chứa hàng chục nghìn truy vấn tìm kiếm. Thoạt nhìn, nó có vẻ đã sẵn sàng cho việc vector hóa và phân cụm, nhưng chất lượng của kết quả phụ thuộc rất nhiều vào mức độ dữ liệu được chuẩn bị tốt trước đó.
Ở giai đoạn này, các thư viện Pandas và NumPy rất tiện lợi để làm sạch và chuẩn hóa tập dữ liệu đầu vào. Một danh sách truy vấn thô hầu như luôn chứa các bản trùng lặp, các ký tự không cần thiết, rác kỹ thuật, các cụm từ không liên quan và các thành phần giả khác xuất hiện trong quá trình phân tích cú pháp và hợp nhất nhiều nguồn dữ liệu.
Mô hình nhúng dù sao cũng sẽ chuyển đổi các chuỗi này thành các vector, nhưng điều này tạo ra chi phí tính toán không cần thiết và có thể làm giảm chất lượng cấu hình của các cụm kết quả. Đó là lý do tại sao bạn nên đưa dữ liệu về một định dạng nhất quán và dễ đoán trước khi thực hiện vector hóa.
Các giai đoạn chuẩn bị chính như sau:
Loại bỏ rác kỹ thuật. Các thẻ HTML, khoảng trắng thừa, ký tự ẩn, biểu tượng cảm xúc và các yếu tố khác có thể đã lọt vào dữ liệu trong quá trình cào dữ liệu sẽ bị loại bỏ.
Loại bỏ trùng lặp toàn cục. Khi kết hợp các truy vấn từ nhiều nguồn, việc trùng lặp là gần như không thể tránh khỏi. Việc vector hóa các chuỗi giống hệt nhau nhiều hơn một lần là không có ý nghĩa, vì vậy các bản trùng lặp hoàn toàn nên được loại bỏ trước.
Lọc từ dừng (Stop-word). Ở giai đoạn này, bạn có thể loại trừ các truy vấn chứa tên địa danh không liên quan, các nhãn không mong muốn hoặc các từ không phù hợp với yêu cầu của dự án. Ví dụ: dữ liệu ngữ nghĩa thương mại có thể loại trừ các truy vấn có các từ như “miễn phí”, “torrent” và các từ sửa đổi tương tự.
Đưa các từ về dạng từ điển (lemmatization) là tùy chọn. Các mô hình hiện đại hiểu rất tốt các dạng khác nhau của cùng một từ và các cụm từ tương đương. Ví dụ, chúng có thể nhận biết rằng “mua iPhone” và “tôi muốn mua một chiếc iPhone” gần như là cùng một truy vấn. Vì vậy, không cần thiết phải cố ý thay đổi từ trước khi xử lý. Tuy nhiên, việc tiền xử lý đơn giản có thể giúp xác định các truy vấn tương tự và giảm lượng dữ liệu.
Kết quả thu được phải là một tập hợp các truy vấn duy nhất sạch sẽ và đã được lọc, không có nhiễu kỹ thuật rõ ràng. Dữ liệu sau đó có thể được chuyển sang giai đoạn tiếp theo—chuyển đổi văn bản thành các biểu diễn vector.
Vector hóa các truy vấn tìm kiếm
Phân cụm vector khác với so sánh chuỗi truyền thống vì nó không hoạt động với các khớp từ chính xác, mà hoạt động với các biểu diễn ngữ nghĩa của chúng. Mỗi truy vấn tìm kiếm được chuyển đổi thành một vector số—một vector nhúng (embedding)—mã hóa các đặc điểm ngữ nghĩa của nó.
Các mô hình nhúng chuyên dụng được sử dụng cho việc này. Văn bản trước tiên được chia thành các token, sau đó mô hình sẽ tạo ra một vector có số chiều cố định. Kết quả là, các truy vấn tương tự nhau về mặt ngữ nghĩa được định vị gần nhau hơn trong không gian vector.
Ví dụ, các cụm từ “mua iPhone 15” và “giá iPhone 15 Pro” sẽ có các vector tương tự nhau hơn là “mua iPhone 15” và “sửa chữa điện thoại Apple”. Đặc tính này giúp có thể sử dụng các thuật toán phân cụm để nhóm các truy vấn lại với nhau.
Các giải pháp thương mại (OpenAI, Claude)
Để vector hóa, bạn có thể sử dụng cả API đám mây và các mô hình cục bộ. Sự lựa chọn phụ thuộc vào lượng dữ liệu, yêu cầu chất lượng, cơ sở hạ tầng sẵn có và chi phí xử lý có thể chấp nhận được.
Các API thương mại rất tiện lợi vì chúng không yêu cầu triển khai mô hình cục bộ và cho phép bạn bắt đầu nhanh chóng. Nhà cung cấp sẽ chăm sóc cơ sở hạ tầng, cập nhật mô hình và mở rộng quy mô tính toán.
Đối với các tập dữ liệu vừa và nhỏ, đây là một trong những giải pháp đơn giản nhất. Tuy nhiên, khi xử lý hàng trăm nghìn hoặc hàng triệu truy vấn, bạn cần xem xét chi phí API, giới hạn yêu cầu và thông lượng.
Ngoài ra, làm việc với các API đòi hỏi một kiến trúc có khả năng chịu lỗi (vượt qua các giới hạn API bằng cách sử dụng nhiều tài khoản, xoay vòng khóa và các yêu cầu không đồng bộ thông qua aiohttp).
Bạn có thể tự mình kiểm tra cách các mạng thần kinh thương mại hoạt động với các truy vấn của bạn bằng cách sử dụng mã sau:
import os
from openai import OpenAI

# Khởi tạo client
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Tập dữ liệu thô của chúng tôi
queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

# 1. Vector hóa các truy vấn thông qua OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# Kết quả là một tập hợp các vector đa chiều đã sẵn sàng
embeddings = [data.embedding for data in response.data]
Các mô hình cục bộ từ hệ sinh thái Hugging Face
Một giải pháp thay thế cho các API thương mại là các mô hình nhúng mở chạy cục bộ. Ví dụ: đối với các tác vụ đa ngôn ngữ, bạn có thể sử dụng jinaai/jina-embeddings-v3 hoặc Alibaba-NLP/gte-multilingual-large, những mô hình này không phát sinh chi phí cho mỗi lần tạo.
from sentence_transformers import SentenceTransformer

print("⏳ 1. Đang tải mô hình BGE-m3 ổn định...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

print(f"⏳ 2. Đang vector hóa {len(queries)} truy vấn...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Đã xong! Hãy xem kết quả:")
print(f"📊 Kích thước dữ liệu: {embeddings.shape}")
print("🔍 Vector cho cụm từ 'buy iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... và thêm {len(embeddings[0]) - 5} số khác.")
Ưu điểm chính của các mô hình cục bộ là toàn bộ quy trình xử lý nằm trong cơ sở hạ tầng của riêng bạn. Bạn xử lý các truy vấn tìm kiếm mà không cần gửi chúng đến API của bên thứ ba, và một khi mô hình được tải, bạn có thể vector hóa chúng mà không phải trả phí cho từng yêu cầu riêng lẻ.
Làm việc với các mô hình cục bộ thường hiệu quả hơn về mặt chi phí: chúng cho phép bạn thực hiện vector hóa mà không phải trả tiền cho mỗi cuộc gọi API. Đồng thời, chúng đòi hỏi một lượng không gian đĩa đáng kể: cùng với trọng số mô hình và bộ nhớ đệm, chúng có thể chiếm tới vài gigabyte. Nếu bạn không còn cần một mô hình nữa, bạn nên xóa các tệp cục bộ của nó và xóa bộ nhớ đệm sau khi hoàn tất công việc.
Lưu trữ và tìm kiếm các biểu diễn vector
Sau khi vector hóa, mỗi truy vấn tìm kiếm được biểu diễn dưới dạng một vector nhúng. Câu hỏi tiếp theo là lưu trữ dữ liệu này ở đâu và làm thế nào để tìm kiếm các truy vấn tương tự về mặt ngữ nghĩa một cách hiệu quả.
Đối với các tập dữ liệu nhỏ, các vector có thể nằm trong bộ nhớ, ví dụ như trong các mảng NumPy hoặc các cấu trúc Pandas. Nếu chỉ có vài nghìn truy vấn, điều này thường là đủ cho các thử nghiệm và xử lý cục bộ.
Khi tập dữ liệu lớn dần, tình hình sẽ thay đổi. Nếu mỗi vector được so sánh trực tiếp với tất cả các vector khác, số lượng thao tác sẽ tăng theo hàm mũ bậc hai. Đối với hàng chục hoặc hàng trăm nghìn truy vấn, việc này sẽ nhanh chóng trở nên tốn tài nguyên về cả thời gian tính toán và mức sử dụng bộ nhớ.
Vấn đề này được giải quyết bằng các cơ sở dữ liệu vector. Chúng được tối ưu hóa đặc biệt cho các tác vụ như vậy và hỗ trợ các thuật toán tìm kiếm láng giềng gần nhất xấp xỉ (đặc biệt là HNSW). Các chỉ mục tích hợp sẵn giúp tránh việc so sánh trực tiếp mọi vector với nhau và cung cấp các tìm kiếm gần như tức thì cho các cụm từ tương tự nhất ngay cả trong hàng triệu bản ghi.
Có một số giải pháp phổ biến cho các tác vụ này: Pinecone, Qdrant, PostgreSQL với phần mở rộng pgvector, và các giải pháp khác. Trong ví dụ của mình, chúng tôi sẽ sử dụng ChromaDB. Nó rất phù hợp cho các thử nghiệm cục bộ: hoạt động mà không cần máy chủ riêng biệt, lưu trữ dữ liệu trên đĩa và dễ dàng tích hợp với mã Python.
Hãy lưu các vector nhúng thu được ở giai đoạn trước và kiểm tra xem tìm kiếm ngữ nghĩa hoạt động như thế nào:
import chromadb

# 1. Khởi tạo cơ sở dữ liệu cục bộ (tạo thư mục semantic_db)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Tạo collection
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Tải các vector và văn bản truy vấn của chúng tôi lên
collection.add(
    embeddings=embeddings.tolist(), # các vector từ mô hình BGE-m3 cục bộ của chúng tôi
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Dữ liệu đã được lưu vào cơ sở dữ liệu!\n")

# ==========================================
# PHÉP THUẬT TÌM KIẾM: hãy kiểm tra cách cơ sở dữ liệu hiểu ý nghĩa
# ==========================================
test_phrase = "how much does the new iphone cost"
print(f"Đang tìm kiếm trong cơ sở dữ liệu cho cụm từ: '{test_phrase}'")

# Chuyển đổi cụm từ kiểm tra thành vector bằng cùng một mô hình
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Yêu cầu cơ sở dữ liệu tìm hai tùy chọn tương tự nhất
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Truy vấn gần nhất: {results['documents'][0][0]} (Khoảng cách: {results['distances'][0][0]:.4f})")
print(f"Gần thứ hai: {results['documents'][0][1]} (Khoảng cách: {results['distances'][0][1]:.4f})")
Chọn một thuật toán phân cụm
Khi các vector nhúng đã được thu thập, bạn có thể chuyển sang giai đoạn tiếp theo—nhóm các truy vấn tìm kiếm. Ở giai đoạn này, điều quan trọng là chọn một thuật toán phù hợp với cấu trúc dữ liệu và không đòi hỏi các giả định quá cứng nhắc về số lượng cụm trong tương lai.
Tại sao K-Means không phải lúc nào cũng phù hợp cho phân cụm SEO
K-Means là một thuật toán phân cụm cổ điển chia dữ liệu thành một số lượng nhóm được xác định trước. Số lượng cụm được chỉ định bằng tham số k.
Ví dụ: nếu chúng ta có 10.000 truy vấn tìm kiếm và chỉ định k=500, thuật toán sẽ tạo ra 500 tâm cụm (centroids) và gán mỗi truy vấn cho tâm cụm gần nhất trong không gian vector.
Hạn chế chính của phương pháp này là số lượng cụm phải được xác định trước. Điều này không phải lúc nào cũng thuận tiện cho một cấu trúc ngữ nghĩa cốt lõi: trước khi quá trình xử lý bắt đầu, rất khó để biết tập dữ liệu chứa bao nhiêu nhóm ý định độc lập—50, 500, hay 1.200.
Nếu k được chọn không tốt, các truy vấn liên quan có thể bị chia tách thành nhiều nhóm khác nhau. Điều ngược lại cũng có thể xảy ra: các truy vấn có chủ đề gần giống nhau nhưng khác nhau về ý định có thể bị gộp lại với nhau chỉ vì thuật toán phải tạo ra đúng số lượng cụm đã chỉ định.
Phân cụm với DBSCAN
Nếu số lượng nhóm không được biết trước, bạn có thể sử dụng các thuật toán phân cụm dựa trên mật độ. Một trong những giải pháp nổi tiếng nhất là DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
Không giống như K-Means, DBSCAN không yêu cầu bạn chỉ định trước số lượng cụm. Thuật toán sẽ tìm kiếm các vùng trong không gian vector nơi các đối tượng đủ gần nhau và tạo thành các nhóm từ chúng.
Hành vi của DBSCAN được xác định bởi hai thông số chính:
eps(epsilon/khoảng cách): khoảng cách tối đa giữa các điểm mà tại đó chúng được coi là láng giềng của nhau. Trong trường hợp của chúng tôi, đây là ngưỡng tương đồng cosine của các vector.min_samples: số lượng láng giềng tối thiểu cần thiết để tạo thành một cụm hoàn chỉnh.
DBSCAN lấy một truy vấn ngẫu nhiên đầu tiên. Nếu có min_samples các truy vấn khác trong bán kính eps của nó, một lõi cụm sẽ được hình thành. Thuật toán sau đó mở rộng theo mọi hướng, thêm các láng giềng mới cho đến khi mật độ không còn nữa.
Tham số eps có thể được so sánh một cách đại khái với mức độ nghiêm ngặt của việc phân cụm:
Một giá trị
epsnhỏ hơn tương ứng với việc nhóm nghiêm ngặt hơn. Chỉ các truy vấn có biểu diễn vector rất giống nhau mới nằm trong cùng một cụm, vì vậy bạn thường có nhiều nhóm hơn và chúng trở nên gọn gàng hơn.Một giá trị
epslớn hơn giúp các điều kiện gộp lỏng lẻo hơn. Các cụm trở nên lớn hơn và có thể bao gồm các ngữ nghĩa rộng hơn, nhưng nguy cơ kết hợp các truy vấn có ý định khác nhau cũng tăng lên.
Một đặc tính hữu ích khác của DBSCAN là khả năng xác định nhiễu. Nếu một truy vấn không nằm trong một vùng có mật độ đủ lớn của không gian vector, thuật toán sẽ không cố gắng ép nó vào một trong các cụm hiện có. Thay vào đó, nó đánh dấu truy vấn đó là một Điểm ngoại lai (Outlier). Bạn có thể xuất các truy vấn này sang một tệp riêng để xem xét thủ công thay vì làm ảnh hưởng đến các trang đích sạch sẽ khác.
Đồng thời, DBSCAN nhạy cảm với việc chọn eps: một ngưỡng duy nhất không phải lúc nào cũng hoạt động tốt với dữ liệu trong đó có một số nhóm rất dày đặc và những nhóm khác lại thưa thớt hơn nhiều.
Trong những trường hợp như vậy, hãy cân nhắc sử dụng HDBSCAN, một phần mở rộng phân cấp của phương pháp dựa trên mật độ. Nó có thể tìm thấy các cụm có mật độ khác nhau, tự động điều chỉnh tham số eps ở những nơi các truy vấn được xếp chặt chẽ hơn hoặc ngược lại, phân tán hơn.
Kịch bản phân cụm
Hãy trích xuất các vector của chúng ta từ cơ sở dữ liệu ChromaDB cục bộ và chạy chúng qua DBSCAN bằng thư viện scikit-learn:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Đang kết nối tới cơ sở dữ liệu vector...")
client = chromadb.PersistentClient(path="./semantic_db")

# Trích xuất collection chứa các vector (sử dụng tên của riêng bạn)
collection = client.get_collection(name="search_queries")

# Trích xuất tất cả các văn bản truy vấn và các vector toán học của chúng
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Đã trích xuất các truy vấn từ cơ sở dữ liệu: {len(documents)}")

# ==========================================
# PHÂN CỤM (DBSCAN)
# ==========================================
print("⏳ 2. Bắt đầu thuật toán DBSCAN...")

# CÀI ĐẶT:
# eps = 0.15 (Khoảng cách cosine được phép. Càng nhỏ, các cụm càng nghiêm ngặt);
# min_samples = 2 (Tối thiểu 2 truy vấn để tạo một nhóm);
# metric="cosine" (Chúng tôi chỉ định rõ ràng rằng chúng tôi đo góc giữa các vector, không phải khoảng cách tuyến tính).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Chạy phân nhóm
labels = dbscan.fit_predict(embeddings)

# ==========================================
# KẾT QUẢ ĐẦU RA
# ==========================================
# Thuật toán đã gán cho mỗi truy vấn một số nhóm (0, 1, 2...).
# Nếu một truy vấn được nhận dạng là nhiễu (Outlier), nó sẽ nhận nhãn -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== KẾT QUẢ PHÂN NHÓM ===")
for cluster_id, docs in clusters.items():
    print(f"\n Cụm #{cluster_id} (Truy vấn: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Điểm ngoại lai/Nhiễu (Truy vấn: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
Ví dụ trên sử dụng mô hình cục bộ, nhưng khi làm việc với các mô hình nhúng thương mại, giá trị eps có thể cần điều chỉnh bổ sung. Cụ thể, ngưỡng 0.15 hoạt động tốt cho mô hình này có thể, với cấu hình khác, khiến một phần đáng kể các truy vấn gộp lại thành một cụm lớn hoặc bị phân loại sai thành nhiễu.
Do đó, bất cứ khi nào bạn chuyển đổi mô hình, bạn nên điều chỉnh riêng eps dựa trên sự phân bố khoảng cách giữa các vector và chất lượng thực tế của các nhóm kết quả.
Phân cụm kết hợp để tách biệt các ý định tìm kiếm
Phân cụm có thể được thực hiện chỉ bằng các vector nhúng, nhưng trên thực tế điều này thường là không đủ. Sự tương đồng về mặt ngữ nghĩa không phải lúc nào cũng có nghĩa là ý định tìm kiếm giống nhau.
Ví dụ: các truy vấn “mua trình duyệt chống phát hiện” và “trình duyệt chống phát hiện là gì” có chủ đề rất gần nhau. Mô hình nhúng nhận dạng chính xác rằng cả hai cụm từ đều đề cập đến cùng một đối tượng, vì vậy khoảng cách giữa các vector của chúng sẽ nhỏ. Kết quả là DBSCAN rất có thể sẽ xếp các truy vấn đó vào một cụm.
Đứng từ góc độ SEO, điều này không mong muốn vì ý định là khác nhau. Ý định thứ nhất ngụ ý một trang đích thương mại, trong khi ý định thứ hai ngụ ý nội dung thông tin.
Hãy chứng minh điều này bằng một tập dữ liệu thử nghiệm nhỏ:
queries = [
    # Thông tin
    "what are antidetect browsers for",
    "what is an antidetect browser",
    "how antidetect browsers work",
    "antidetect browsers comparison",

    # Thương mại
    "buy an anti-detect browser",
    "buy proxies for an anti-detect browser",
    "anti-detect browser trial",

    # Tải về
    "download anti-detect browser octo browser",
    "octo browser anti-detect browser download",
    "octo anti-detect browser download",

    # Các truy vấn về một chủ đề khác
    "ford everest 2024 review",
    "buy used ford everest",

    # Nhiễu
    "weather in pattaya in May",
    "tom yum soup recipe"
]
Khi chỉ phân cụm theo độ tương đồng vector, các truy vấn liên quan đến trình duyệt chống phát hiện có thể nằm trong cùng một nhóm bất kể sự khác biệt về ý định.
Ở giai đoạn này, trình duyệt chống phát hiện một lần nữa trở thành một phần của quy trình, nhưng không phải để thu thập dữ liệu ngữ nghĩa. Thay vào đó, nó được sử dụng để thu thập dữ liệu SERP. Đối với mỗi truy vấn, bạn cần thu thập kết quả tìm kiếm và sau đó sử dụng sự trùng lặp URL làm tín hiệu phân cụm bổ sung.
Với số lượng truy vấn lớn, việc thu thập này có thể được phân phối thuận tiện trên các hồ sơ trình duyệt cô lập, ví dụ như bằng cách sử dụng Octo Browser cùng với Playwright hoặc Puppeteer.
Đối với mỗi truy vấn, hãy thu thập 10 URL hàng đầu từ kết quả tìm kiếm. Sau đó, trước khi chạy DBSCAN, hãy so sánh kết quả của các cụm từ tương tự về mặt ngữ nghĩa. Nếu hai truy vấn không có URL chung hoặc số lượng của chúng dưới một ngưỡng xác định, khoảng cách giữa các vector tương ứng sẽ được tăng lên một cách nhân tạo.
Do đó, các vector nhúng được sử dụng để tìm các truy vấn tương tự về mặt ngữ nghĩa, trong khi phân tích SERP đóng vai trò như một ràng buộc bổ sung và giúp ngăn chặn các cụm từ có ý định tìm kiếm khác nhau bị gộp lại.
Sau khi thêm dữ liệu kết quả tìm kiếm, tập dữ liệu thử nghiệm được thảo luận trước đó trong bài viết được phân bổ khác đi:
Số lượng cụm tăng lên, và bản thân các nhóm phù hợp hơn với ý định tìm kiếm mong muốn của các truy vấn.
Xử lý hậu kỳ kết quả và cập nhật dữ liệu
Sau khi tạo thành các cụm, có một tác vụ thực tế nữa—gán một cái tên rõ ràng cho mỗi nhóm. Những con số như “Cụm #42” rất thuận tiện cho thuật toán nhưng lại nói lên rất ít điều với một chuyên gia SEO, biên tập viên hoặc người viết nội dung.
Đặt tên cụm tự động bằng LLM
Khi làm việc thủ công, chuyên gia phải xem xét nội dung của từng nhóm, xác định ý định chính và nghĩ ra một cái tên cho trang hoặc mẩu nội dung tương lai. Nếu có hàng trăm cụm, giai đoạn này sẽ tốn một lượng thời gian đáng kể.
Tuy nhiên, phần này của quy trình có thể được tự động hóa bằng LLM. Mô hình nhận một danh sách các truy vấn từ một cụm, xác định ý định tổng thể và tạo ra một tiêu đề thích hợp. Bạn có thể sử dụng các mô hình dựa trên đám mây hoặc các giải pháp cục bộ, ví dụ: Ollama.
Điều quan trọng là phải xác định một định dạng đầu ra nghiêm ngặt trước. Nếu bạn chỉ đơn giản yêu cầu mô hình nghĩ ra một cái tên, bạn có thể nhận được các giải thích và nhận xét bổ sung cùng với tiêu đề. Đó là lý do tại sao tốt hơn hết là nêu rõ ràng trong câu lệnh hệ thống (system prompt) rằng kết quả đầu ra chỉ nên chứa tiêu đề và không có văn bản bổ sung nào khác:
from openai import OpenAI

# 1. KHỞI TẠO VÀ KHÓA
# Chèn khóa API thực tế của bạn vào đây
client_ai = OpenAI(api_key="sk-YOUR_OPENAI_KEY")

# 2. DỮ LIỆU CỦA CHÚNG TÔI (Kết quả của phân cụm kết hợp)
clusters = {
    0: [
       "what are anti-detect browsers for",
       "what is an anti-detect browser",
       "how anti-detect browsers work",
       "anti-detect browsers comparison",
    ],
    1: [
        "buy an anti-detect browser",
        "buy proxies for an anti-detect browser",
        "anti-detect browser trial"
    ],
    2: [
        "download anti-detect browser octo browser",
        "octo browser anti-detect browser download",
        "octo anti-detect browser download"
    ]
}

# System prompt (thiết lập các quy tắc cho mô hình)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Đang gửi các cụm tới GPT-4o-mini để tự động đặt tên...\n")

# 3. Lặp qua tất cả các cụm
for cluster_id, queries in clusters.items():
    # Gửi các truy vấn từ cụm hiện tại tới API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Kết hợp các truy vấn thành một văn bản duy nhất
        ],
        temperature=0.3
    )

    # Nhận phản hồi
    h1_title = response.choices[0].message.content

    # In kết quả ra màn hình điều khiển
    print(f"Cụm #{cluster_id}")
    print(f"Các cụm từ: {', '.join(queries)}")
    print(f"H1 được tạo: {h1_title}\n")
Đối với tập dữ liệu thử nghiệm, kết quả có thể trông như thế này:
Cụm #0
   Các cụm từ: what are anti-detect browsers for, what is an anti-detect browser, how anti-detect browsers work
   H1 được tạo: What are anti-detect browsers used for

Cụm #1
   Các cụm từ: buy an anti-detect browser, buy proxies for an anti-detect browser, anti-detect browser trial
   H1 được tạo: Best anti-detect browsers and proxies for safe browsing

Cụm #2
   Các cụm từ: download anti-detect browser octo browser, octo browser anti-detect browser download, octo anti-detect browser download
   H1 được tạo: Download anti-detect browser Octo Browser
Trong một dự án thực tế, số lượng cụm sẽ lớn hơn nhiều, vì vậy việc lưu trữ trực tiếp dữ liệu nguồn trong mã là không thực tế. Thông thường, các cụm được tải từ một tệp hoặc cơ sở dữ liệu, và các tên được tạo sẽ được ghi lại vào bảng để làm việc tiếp.
Ở giai đoạn này, LLM không tham gia vào việc phân cụm; nó chỉ được sử dụng để xử lý hậu kỳ các nhóm đã được tạo thành. Điều này tự động hóa phần việc thủ công lặp đi lặp lại và mang lại cho bạn một cấu trúc ngữ nghĩa cốt lõi rõ ràng mà không cần phải đặt tên thủ công cho từng cụm.
Thêm các truy vấn mới
Một ưu điểm khác của việc lưu trữ các vector nhúng trong ChromaDB là khả năng làm việc với dữ liệu mới mà không cần phải thực hiện lại tìm kiếm láng giềng gần nhất trên toàn bộ tập dữ liệu một cách thủ công.
Sau khi nhận được một đợt dữ liệu ngữ nghĩa mới, các truy vấn sẽ đi qua cùng một quy trình: làm sạch, vector hóa và thêm chúng vào ChromaDB. Với mỗi vector nhúng mới, bạn có thể tìm thấy các truy vấn hiện có gần nhất và đánh giá khoảng cách tới chúng.
Nếu các láng giềng gần nhất thuộc về một cụm hiện có ổn định và đáp ứng ngưỡng tương đồng đã xác định, truy vấn mới có thể được thêm vào nhóm đó. Nếu không có cụm nào phù hợp, truy vấn sẽ tiếp tục là ứng cử viên để tạo thành một nhóm mới hoặc được gửi đi để xử lý bổ sung.
Phương pháp này cho phép bạn sử dụng cơ sở dữ liệu vector tích lũy được làm chỉ mục để xử lý các truy vấn mới và tránh việc phải thực hiện tìm kiếm cặp đầy đủ trên toàn bộ cấu trúc ngữ nghĩa cốt lõi mỗi khi nó được cập nhật.
Kết luận
Xây dựng quy trình xử lý của riêng bạn dựa trên các mô hình nhúng, lưu trữ vector và các thuật toán phân cụm sẽ tốn thời gian, vì bạn cần định cấu hình, thử nghiệm và tinh chỉnh nó. Tuy nhiên, một khi việc này hoàn tất, bạn sẽ có được một hệ thống có thể điều chỉnh phù hợp với một chủ đề cụ thể, khối lượng dữ liệu và các yêu cầu của dự án.
Những ưu điểm chính của phương pháp này là:
Giảm sự phụ thuộc vào các dịch vụ chuyên dụng. Bạn không cần một dịch vụ SEO riêng biệt với các gói cố định và giới hạn dung lượng để phân cụm. Các hạn chế chính chuyển sang cơ sở hạ tầng của riêng bạn: tài nguyên tính toán, bộ nhớ và không gian đĩa.
Kiểm soát logic phân cụm. Bạn có thể tự chọn mô hình nhúng, định cấu hình
eps, sử dụng dữ liệu SERP và thay đổi các quy tắc kết hợp truy vấn tùy thuộc vào tác vụ.Kiểm soát dữ liệu. Khi sử dụng các mô hình cục bộ và lưu trữ cục bộ, dữ liệu ngữ nghĩa vẫn nằm trong cơ sở hạ tầng của riêng bạn và không bị gửi đến các API của bên thứ ba.
Giá trị chính của phương pháp này không phải là thay thế hoàn toàn các công cụ SEO có sẵn, mà là khả năng xây dựng quy trình kiểm soát được của riêng bạn. Hãy sử dụng Octo Browser để tự động hóa việc cào dữ liệu ngữ nghĩa và dữ liệu SERP, đồng thời thực hiện phần xử lý còn lại tại cục bộ bằng các vector nhúng, ChromaDB và thuật toán phân cụm.
Một khi bạn xây dựng quy trình này và tinh chỉnh nó cẩn thận bằng dữ liệu thực tế, nó sẽ trở nên giá trị hơn nhiều so với một tập lệnh chạy một lần. Nó biến thành một công cụ làm việc thực sự mà bạn có thể tái sử dụng và mở rộng quy mô khi cấu trúc ngữ nghĩa cốt lõi của bạn phát triển.
Cập nhật với các tin tức Octo Browser mới nhất
Khi nhấp vào nút này, bạn sẽ đồng ý với Chính sách Quyền riêng tư của chúng tôi.
Cập nhật với các tin tức Octo Browser mới nhất
Khi nhấp vào nút này, bạn sẽ đồng ý với Chính sách Quyền riêng tư của chúng tôi.
Cập nhật với các tin tức Octo Browser mới nhất
Khi nhấp vào nút này, bạn sẽ đồng ý với Chính sách Quyền riêng tư của chúng tôi.
Tham gia Octo Browser ngay
Hoặc liên hệ với Dịch vụ khách hàng bất kì lúc nào nếu bạn có bất cứ thắc mắc nào.
Tham gia Octo Browser ngay
Hoặc liên hệ với Dịch vụ khách hàng bất kì lúc nào nếu bạn có bất cứ thắc mắc nào.
Tham gia Octo Browser ngay
Hoặc liên hệ với Dịch vụ khách hàng bất kì lúc nào nếu bạn có bất cứ thắc mắc nào.