Agrupamento vetorial de consultas de pesquisa: construa seu próprio sistema com ChromaDB, embeddings e Python


Markus_automation
Expert in data parsing and automation
O agrupamento (clustering) é uma das etapas mais trabalhosas no trabalho com dados semânticos. Coletar e limpar um conjunto de consultas é relativamente simples, mas distribuir corretamente milhares de palavras-chave em clusters com a mesma intenção de busca é muito mais difícil.
Ferramentas de agrupamento como Rush Analytics, Key.so e Key Collector simplificam a tarefa, mas têm limitações em termos de volume, configurações e qualidade dos resultados. Isso é especialmente perceptível em nichos complexos, onde algoritmos automáticos podem combinar consultas com intenções diferentes ou dividir frases que têm significado muito próximo.
Uma abordagem baseada em redes neurais permite resolver essa tarefa de forma diferente. Em vez de comparar palavras individuais e correspondências léxicas, as consultas são convertidas em vetores multidimensionais chamados embeddings. Estes podem ser comparados por semelhança semântica e usados para formar clusters automaticamente.
Neste artigo, veremos como construir seu próprio pipeline de agrupamento escalável em um computador local ou servidor — desde a coleta automatizada de dados semânticos e da SERP usando um navegador antidetecção até a vetorização, agrupamento e pós-processamento dos resultados.
Índice
Mantenha o anonimato on-line com Octo Browser. Sua verdadeira impressão digital não pode ser rastreada.
Gostaria de experimentar o Octo Browser com desconto?
Use o código promocional OCTOBLOG para obter 30% de desconto em qualquer assinatura. Esta oferta é válida apenas para novos usuários.
Coleta de dados semânticos
Existem várias abordagens para coletar dados semânticos, mas o processo básico geralmente é construído em torno do mesmo padrão: primeiro, um pool inicial de consultas é criado usando serviços como o Google Ads Keyword Planner e outras ferramentas que fornecem dados de volume de pesquisa para o tópico relevante.
O conjunto inicial é então expandido com consultas relacionadas, sugestões de pesquisa e fontes semânticas adicionais. O Key Collector era frequentemente usado para tarefas semelhantes no passado, mas hoje em dia costuma ser necessário combinar várias ferramentas ou usar scripts personalizados para coletar os dados necessários.
Uso de ferramentas de automação para coletar dados semânticos
Se as soluções comerciais não se ajustarem ao seu orçamento, requisitos de funcionalidade ou limitações, você mesmo pode automatizar parte do processo de coleta semântica. Por exemplo, para recuperar sugestões de pesquisa e outros dados de interfaces web, você pode usar navegadores headless baseados em Puppeteer ou Playwright.
Se você estiver coletando dados semânticos em um grande número de sessões paralelas, precisará gerenciar os perfis de navegador e seus ambientes com segurança. Aqui você pode usar um navegador antidetecção como o Octo Browser para isolar sessões, gerenciar configurações de perfil e conectar diferentes proxies. Isso simplifica a infraestrutura de raspagem e reduz a quantidade de configuração manual necessária para cada instância individual do navegador.
O principal desafio ao coletar dados em escala são as restrições impostas pelos mecanismos de pesquisa. Solicitações automatizadas podem acionar limites de taxa, CAPTCHAs ou outros mecanismos de proteção. Por isso, ao projetar esse fluxo de trabalho, você precisa considerar a estabilidade da sessão, a frequência das solicitações e os bloqueios temporários.
Ao trabalhar com automação de navegadores, também é importante controlar os parâmetros do ambiente, como o User-Agent, tamanho da janela, localidade, WebGL e outras características da sessão do navegador. Você pode fazer isso usando suas próprias configurações de Puppeteer ou Playwright ou soluções de navegadores especializados que permitem criar perfis isolados com diferentes parâmetros de ambiente.
Outra tarefa distinta é a organização da infraestrutura de rede. Você pode usar diferentes tipos de proxies para coleta de dados distribuída: datacenter, residencial ou móvel. A escolha depende do volume de solicitações e dos requisitos de estabilidade, velocidade e custo. Os proxies de datacenter geralmente são mais baratos e rápidos, mas em certos cenários têm maior probabilidade de serem restritos. Os endereços residenciais e móveis geralmente são mais resilientes, mas custam mais e oferecem menor taxa de transferência.
Depois de concluir a coleta de dados principal, você pode complementar a lista final de consultas com dados de bancos de dados semânticos externos. O resultado deve ser um conjunto de consultas o mais completo possível, que poderá então ser enviado para as etapas de limpeza, normalização e posterior agrupamento (clustering).
Limpeza de dados antes da vetorização
Depois de coletar seus dados semânticos, você terá um arquivo contendo dezenas de milhares de consultas de pesquisa. À primeira vista, pode parecer pronto para vetorização e agrupamento, mas a qualidade do resultado depende muito de quão bem os dados foram preparados previamente.
Nesta fase, as bibliotecas Pandas e NumPy são convenientes para limpar e normalizar o conjunto de dados de entrada. Uma lista de consultas brutas quase sempre contém duplicatas, caracteres desnecessários, poluição técnica, frases irrelevantes e outros artefatos introduzidos durante a análise e a fusão de várias fontes.
De qualquer forma, um modelo de incorporação (embedding) converterá essas strings em vetores, mas isso cria uma sobrecarga computacional desnecessária e pode degradar a estrutura dos agrupamentos resultantes. É por isso que é uma boa ideia trazer os dados para um formato consistente e previsível antes da vetorização.
As principais etapas de preparação são as seguintes:
Remoção de poluição técnica. Tags HTML, espaços extras, caracteres invisíveis, emojis e outros elementos que possam ter entrado nos dados durante a raspagem são removidos.
Deduzimento global. Ao combinar consultas de várias fontes, as sobreposições são quase inevitáveis. Não há sentido em vetorizar strings idênticas mais de uma vez, portanto, as duplicatas completas devem ser removidas com antecedência.
Filtragem de palavras de parada (stop-words). Nesta etapa, você pode excluir consultas contendo nomes de locais irrelevantes, marcadores indesejados ou palavras que não se encaixam nos requisitos do projeto. Por exemplo, dados semânticos comerciais podem excluir consultas com palavras como "grátis", "torrent" e modificadores semelhantes.
Reduzir palavras à sua forma de dicionário (lematização) é opcional. Os modelos modernos entendem bem diferentes formas da mesma palavra e frases equivalentes. Por exemplo, eles podem reconhecer que "comprar iPhone" e "quero comprar um iPhone" são quase a mesma consulta. Portanto, não há necessidade de alterar deliberadamente as palavras antes do processamento. No entanto, um pré-processamento simples pode ajudar a identificar consultas semelhantes e reduzir a quantidade de dados.
O resultado deve ser um conjunto limpo e filtrado de consultas exclusivas sem ruídos técnicos óbvios. Os dados podem então ser passados para a próxima etapa — conversão de texto em representações vetoriais.
Vetorização de consultas de pesquisa
O agrupamento vetorial difere da comparação tradicional de strings porque não trabalha com correspondências exatas de palavras, mas com suas representações semânticas. Cada consulta de pesquisa é convertida em um vetor numérico — uma incorporação (embedding) — que codifica suas características semânticas.
Modelos de incorporação especializados são usados para isso. O texto é primeiro dividido em tokens, após o qual o modelo gera um vetor de dimensionalidade fixa. Como resultado, consultas semânticamente semelhantes são posicionadas mais próximas umas das outras no espaço vetorial.
Por exemplo, as frases "comprar iPhone 15" e "preço do iPhone 15 Pro" terão vetores mais semelhantes do que "comprar iPhone 15" e "conserto de telefone Apple". Essa propriedade torna possível usar algoritmos de agrupamento para agrupar consultas.
Soluções comerciais (OpenAI, Claude)
Para vetorização, você pode usar tanto APIs de nuvem quanto modelos locais. A escolha depende do volume de dados, dos requisitos de qualidade, da infraestrutura disponível e do custo aceitável de processamento.
As APIs comerciais são convenientes porque não exigem a implantação de modelos locais e permitem que você comece rapidamente. O provedor cuida da infraestrutura, atualizações de modelos e dimensionamento computacional.
Para conjuntos de dados de pequeno e médio porte, esta é uma das soluções mais simples. No entanto, ao processar centenas de milhares ou milhões de consultas, você precisa considerar os custos da API, os limites de solicitação e a taxa de transferência.
Além disso, trabalhar com APIs exige uma arquitetura tolerante a falhas (contornando os limites da API por meio de multicontas, rotação de chaves e solicitações assíncronas via aiohttp).
Você mesmo pode testar como as redes neurais comerciais funcionam com suas consultas usando o seguinte código:
import os
from openai import OpenAI

# Initialize the client
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Our raw dataset
queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

# 1. Vectorize queries through OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# The result is a set of ready-made multidimensional vectors
embeddings = [data.embedding for data in response.data]
import os
from openai import OpenAI

# Initialize the client
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Our raw dataset
queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

# 1. Vectorize queries through OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# The result is a set of ready-made multidimensional vectors
embeddings = [data.embedding for data in response.data]
Modelos locais do ecossistema Hugging Face
Uma alternativa às APIs comerciais são os modelos de incorporação abertos que funcionam localmente. Por exemplo, para tarefas multilíngues, você pode usar jinaai/jina-embeddings-v3 ou Alibaba-NLP/gte-multilingual-large, que não geram custos por geração.
from sentence_transformers import SentenceTransformer

print("⏳ 1. Loading stable BGE-m3 model...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

print(f"⏳ 2. Vectorizing {len(queries)} queries...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Done! Let's look at the result:")
print(f"📊 Data dimensions: {embeddings.shape}")
print("🔍 Vector for the phrase 'buy iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... and {len(embeddings[0]) - 5} more numbers.")
from sentence_transformers import SentenceTransformer

print("⏳ 1. Loading stable BGE-m3 model...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

print(f"⏳ 2. Vectorizing {len(queries)} queries...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Done! Let's look at the result:")
print(f"📊 Data dimensions: {embeddings.shape}")
print("🔍 Vector for the phrase 'buy iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... and {len(embeddings[0]) - 5} more numbers.")
A principal vantagem dos modelos locais é que todo o pipeline de processamento permanece dentro da sua própria infraestrutura. Você processa as consultas de pesquisa sem enviá-las a uma API de terceiros e, uma vez carregado o modelo, pode vetorizá-las sem pagar por cada solicitação individual.
Trabalhar com modelos locais costuma ser mais econômico: eles permitem realizar a vetorização sem pagar por cada chamada de API. Ao mesmo tempo, exigem uma quantidade significativa de espaço em disco: junto com os pesos do modelo e o cache, podem ocupar vários gigabytes. Se você não precisar mais de um modelo, é uma boa ideia remover seus arquivos locais e limpar o cache depois de terminar de trabalhar com ele.
Armazenamento e busca de representações vetoriais
Após a vetorização, cada consulta de pesquisa é representada como um vetor de incorporação. A próxima questão é onde armazenar esses dados e como encontrar com eficiência consultas semânticamente semelhantes.
Para pequenos conjuntos de dados, os vetores podem permanecer na memória, por exemplo, em matrizes NumPy ou estruturas Pandas. Se houver apenas alguns milhares de consultas, isso costuma ser suficiente para experimentos e processamento local.
À medida que o conjunto de dados cresce, a situação muda. Se cada vetor for comparado diretamente com todos os outros, o número de operações cresce quadraticamente. Para dezenas ou centenas de milhares de consultas, isso rapidamente se torna intensivo em recursos, tanto em termos de tempo de computação quanto de uso de memória.
Esse problema é resolvido com bancos de dados vetoriais. Eles são otimizados especificamente para tais tarefas e suportam algoritmos de busca de vizinhos mais próximos aproximados (em particular, HNSW). Os índices integrados tornam possível evitar a comparação direta de cada vetor com todos os outros e fornecem buscas quase instantâneas pelas frases mais semelhantes, mesmo entre milhões de registros.
Existem várias soluções populares para essas tarefas: Pinecone, Qdrant, PostgreSQL com a extensão pgvector e outras. Em nosso exemplo, usaremos o ChromaDB. Ele é muito adequado para experimentos locais: funciona sem um servidor separado, armazena dados em disco e se integra facilmente com código Python.
Vamos salvar as incorporações obtidas na etapa anterior e verificar como funciona a busca semântica:
import chromadb

# 1. Initialize the local database (creates the semantic_db folder)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Create the collection
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Load our vectors and query texts
collection.add(
    embeddings=embeddings.tolist(), # vectors from our local BGE-m3 model
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Data saved to the database!\n")

# ==========================================
# SEARCH MAGIC: let's check how the database understands meaning
# ==========================================
test_phrase = "how much does the new iphone cost"
print(f"Searching the database for the phrase: '{test_phrase}'")

# Convert the test phrase into a vector using the same model
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Ask the database to find the two most similar options
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Closest query: {results['documents'][0][0]} (Distance: {results['distances'][0][0]:.4f})")
print(f"Second closest: {results['documents'][0][1]} (Distance: {results['distances'][0][1]:.4f})")
import chromadb

# 1. Initialize the local database (creates the semantic_db folder)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Create the collection
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Load our vectors and query texts
collection.add(
    embeddings=embeddings.tolist(), # vectors from our local BGE-m3 model
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Data saved to the database!\n")

# ==========================================
# SEARCH MAGIC: let's check how the database understands meaning
# ==========================================
test_phrase = "how much does the new iphone cost"
print(f"Searching the database for the phrase: '{test_phrase}'")

# Convert the test phrase into a vector using the same model
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Ask the database to find the two most similar options
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Closest query: {results['documents'][0][0]} (Distance: {results['distances'][0][0]:.4f})")
print(f"Second closest: {results['documents'][0][1]} (Distance: {results['distances'][0][1]:.4f})")
Escolhendo um algoritmo de agrupamento
Depois que os vetores de incorporação foram obtidos, você pode passar para a próxima etapa — agrupar as consultas de pesquisa. Nesta fase, é importante escolher um algoritmo que corresponda à estrutura dos dados e não exija suposições excessivamente rígidas sobre o número de agrupamentos futuros.
Por que o K-Means nem sempre é adequado para o agrupamento de SEO
O K-Means é um algoritmo de agrupamento clássico que divide os dados em um número predefinido de grupos. O número de agrupamentos é especificado com o parâmetro k.
Por exemplo, se temos 10.000 consultas de pesquisa e especificamos k=500, o algoritmo criará 500 centroides e atribuirá cada consulta ao mais próximo no espaço vetorial.
A principal limitação dessa abordagem é que o número de agrupamentos deve ser determinado com antecedência. Isso nem sempre é conveniente para um núcleo semântico: antes de o processamento começar, é difícil saber quantos grupos de intenção independentes o conjunto de dados contém — 50, 500 ou 1.200.
Se k for mal escolhido, consultas relacionadas podem acabar divididas em vários grupos. O inverso também pode acontecer: consultas que são próximas em tópicos, mas diferem em intenção, podem ser fundidas simplesmente porque o algoritmo precisa criar o número especificado de agrupamentos.
Agrupamento com DBSCAN
Se o número de grupos não for conhecido com antecedência, você poderá usar algoritmos de agrupamento baseados em densidade. Uma das soluções mais conhecidas é o DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
Ao contrário do K-Means, o DBSCAN não exige que você especifique o número de agrupamentos previamente. O algoritmo busca regiões no espaço vetorial onde os objetos estão suficientemente próximos e forma grupos a partir deles.
O comportamento do DBSCAN é determinado por dois parâmetros principais:
eps(épsilon/distância): a distância máxima entre pontos para que sejam considerados vizinhos. No nosso caso, esse é o limite de similaridade por cosseno dos vetores.min_samples: o número mínimo de vizinhos necessários para formar um agrupamento completo.
O DBSCAN escolhe uma primeira consulta aleatória. Se houver pelo menos min_samples outras consultas dentro de um raio eps em torno dela, um núcleo de agrupamento é formado. O algoritmo então se expande em todas as direções, adicionando novos vizinhos até que a densidade acabe.
O parâmetro eps pode ser comparado grosseiramente ao rigor do agrupamento:
Um
epsmenor corresponde a um agrupamento mais rigoroso. Apenas consultas com representações vetoriais muito semelhantes acabarão no mesmo agrupamento, portanto, você geralmente obtém mais grupos, e eles se tornam mais compactos.Um
epsmaior torna as condições de fusão mais permissivas. Os agrupamentos tornam-se maiores e podem incluir uma semântica mais ampla, mas o risco de combinar consultas com intenções diferentes também aumenta.
Outra propriedade útil do DBSCAN é sua capacidade de identificar ruído. Se uma consulta não estiver localizada em uma região suficientemente densa do espaço vetorial, o algoritmo não tenta forçá-la a entrar em um dos agrupamentos existentes. Em vez disso, ele marca a consulta como um Outlier (ponto fora da curva). Você pode exportar essas consultas para um arquivo separado para revisão manual, em vez de comprometer páginas de destino que de outra forma estariam limpas.
Ao mesmo tempo, o DBSCAN é sensível à escolha de eps: um único limite nem sempre funciona bem com dados nos quais alguns grupos são muito densos e outros são muito mais dispersos.
Nesses casos, considere o HDBSCAN, uma extensão hierárquica da abordagem baseada em densidade. Ele pode encontrar agrupamentos com densidades diferentes, adaptando automaticamente o parâmetro eps onde as consultas estão mais compactadas ou, inversamente, mais dispersas.
O script de agrupamento
Vamos extrair nossos vetores do banco de dados ChromaDB local e executá-los no DBSCAN usando a biblioteca scikit-learn:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Connecting to the vector database...")
client = chromadb.PersistentClient(path="./semantic_db")

# Extract the collection with the vectors (use your own name)
collection = client.get_collection(name="search_queries")

# Extract all query texts and their mathematical vectors
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Queries extracted from the database: {len(documents)}")

# ==========================================
# CLUSTERING (DBSCAN)
# ==========================================
print("⏳ 2. Starting the DBSCAN algorithm...")

# SETTINGS:
# eps = 0.15 (Allowed cosine distance. The smaller it is, the stricter the clusters);
# min_samples = 2 (Minimum of 2 queries to create a group);
# metric="cosine" (We explicitly specify that we measure angles between vectors, not linear distance).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Run the grouping
labels = dbscan.fit_predict(embeddings)

# ==========================================
# OUTPUT RESULTS
# ==========================================
# The algorithm assigned each query a group number (0, 1, 2...).
# If a query is recognized as noise (Outlier), it receives the label -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== GROUPING RESULTS ===")
for cluster_id, docs in clusters.items():
    print(f"\n Cluster #{cluster_id} (Queries: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Outliers/Noise (Queries: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Connecting to the vector database...")
client = chromadb.PersistentClient(path="./semantic_db")

# Extract the collection with the vectors (use your own name)
collection = client.get_collection(name="search_queries")

# Extract all query texts and their mathematical vectors
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Queries extracted from the database: {len(documents)}")

# ==========================================
# CLUSTERING (DBSCAN)
# ==========================================
print("⏳ 2. Starting the DBSCAN algorithm...")

# SETTINGS:
# eps = 0.15 (Allowed cosine distance. The smaller it is, the stricter the clusters);
# min_samples = 2 (Minimum of 2 queries to create a group);
# metric="cosine" (We explicitly specify that we measure angles between vectors, not linear distance).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Run the grouping
labels = dbscan.fit_predict(embeddings)

# ==========================================
# OUTPUT RESULTS
# ==========================================
# The algorithm assigned each query a group number (0, 1, 2...).
# If a query is recognized as noise (Outlier), it receives the label -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== GROUPING RESULTS ===")
for cluster_id, docs in clusters.items():
    print(f"\n Cluster #{cluster_id} (Queries: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Outliers/Noise (Queries: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
O exemplo acima usa um modelo local, mas ao trabalhar com modelos de incorporação comerciais, o valor de eps pode exigir ajustes adicionais. Em particular, um limite de 0.15 que funciona para um modelo pode, com outra configuração, fazer com que uma parte significativa das consultas se funda em um único grande agrupamento ou seja classificada incorretamente como ruído.
Portanto, sempre que você mudar de modelo, deve ajustar o eps separadamente com base na distribuição das distâncias entre os vetores e na qualidade real dos grupos resultantes.
Agrupamento híbrido para separar intenções de busca
O agrupamento pode ser feito exclusivamente com vetores de incorporação, mas na prática isso muitas vezes não é suficiente. A similaridade semântica nem sempre significa que a intenção de busca seja a mesma.
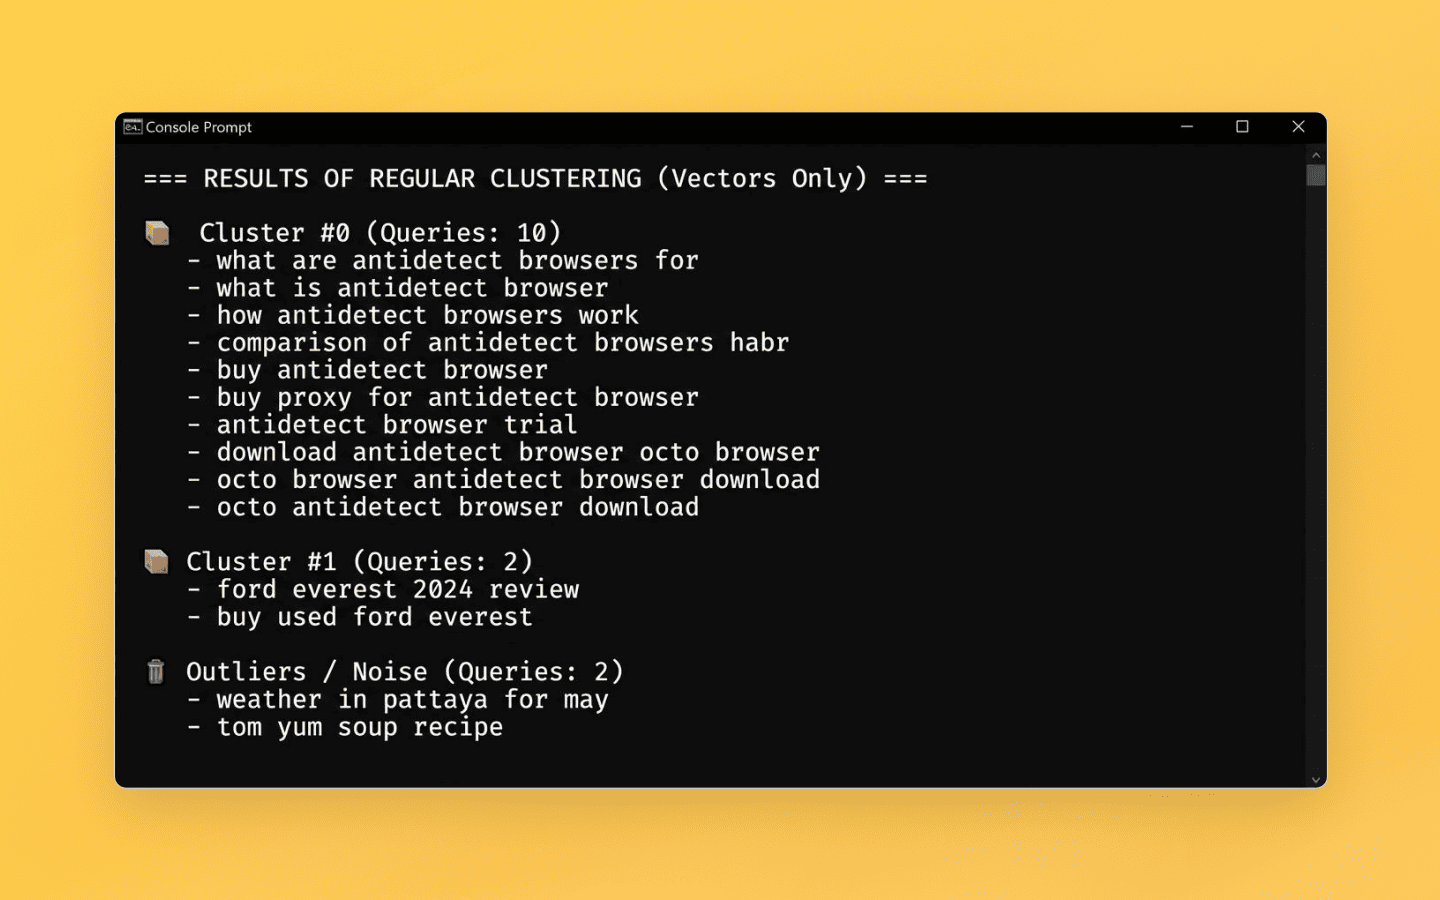
Por exemplo, as consultas "comprar um navegador antidetecção" e "o que é um navegador antidetecção" são muito próximas em termos de tópico. O modelo de incorporação reconhece corretamente que ambas as frases se referem ao mesmo objeto, de modo que a distância entre seus vetores será pequena. Como resultado, o DBSCAN provavelmente colocará essas consultas no mesmo agrupamento.
Do ponto de vista de SEO, isso é indesejável porque a intenção difere. A primeira implica uma página de destino comercial, enquanto a segunda implica conteúdo informativo.
Vamos demonstrar isso com um pequeno conjunto de dados de teste:
queries = [
    # Informational
    "what are antidetect browsers for",
    "what is an antidetect browser",
    "how antidetect browsers work",
    "antidetect browsers comparison",

    # Commercial
    "buy an anti-detect browser",
    "buy proxies for an anti-detect browser",
    "anti-detect browser trial",

    # Download
    "download anti-detect browser octo browser",
    "octo browser anti-detect browser download",
    "octo anti-detect browser download",

    # Queries on a different topic
    "ford everest 2024 review",
    "buy used ford everest",

    # Noise
    "weather in pattaya in May",
    "tom yum soup recipe"
]
queries = [
    # Informational
    "what are antidetect browsers for",
    "what is an antidetect browser",
    "how antidetect browsers work",
    "antidetect browsers comparison",

    # Commercial
    "buy an anti-detect browser",
    "buy proxies for an anti-detect browser",
    "anti-detect browser trial",

    # Download
    "download anti-detect browser octo browser",
    "octo browser anti-detect browser download",
    "octo anti-detect browser download",

    # Queries on a different topic
    "ford everest 2024 review",
    "buy used ford everest",

    # Noise
    "weather in pattaya in May",
    "tom yum soup recipe"
]
Ao agrupar apenas por similaridade vetorial, as consultas relacionadas a navegadores antidetecção podem acabar no mesmo grupo, apesar das diferenças de intenção.
Nesta fase, o navegador antidetecção torna-se mais uma vez parte do pipeline, mas não para coletar dados semânticos. Em vez disso, ele é usado para coletar dados de SERP (páginas de resultados de busca). Para cada consulta, você precisa coletar resultados de pesquisa e usar as sobreposições de URL como um sinal de agrupamento adicional.
Com um grande número de consultas, essa coleta pode ser convenientemente distribuída em perfis de navegador isolados, por exemplo, usando o Octo Browser junto com o Playwright ou Puppeteer.

Para cada consulta, colete as 10 principais URLs dos resultados de pesquisa. Em seguida, antes de executar o DBSCAN, compare os resultados de frases semânticamente semelhantes. Se duas consultas não tiverem URLs em comum ou se o número de URLs comuns estiver abaixo de um limite definido, a distância entre os vetores correspondentes será aumentada artificialmente.
Dessa forma, as incorporações são usadas para encontrar consultas semânticamente semelhantes, enquanto a análise de SERP atua como uma restrição adicional e ajuda a evitar que frases com intenções de busca diferentes sejam mescladas.
Após adicionar os dados dos resultados de pesquisa, o conjunto de dados de teste discutido anteriormente neste artigo é distribuído de forma diferente:
O número de agrupamentos aumenta, e os próprios grupos correspondem melhor à intenção de busca pretendida das consultas.
Pós-processamento de resultados e atualização de dados
Depois de formar os agrupamentos, há mais uma tarefa prática — atribuir um nome claro a cada grupo. Números como "Agrupamento #42" são convenientes para um algoritmo, mas dizem muito pouco a um especialista em SEO, editor ou redator de conteúdo.
Nomeação automática de agrupamentos com um LLM
Ao trabalhar manualmente, um especialista precisa revisar o conteúdo de cada grupo, determinar a intenção principal e criar um nome para a futura página ou peça de conteúdo. Se houver várias centenas de agrupamentos, essa etapa consome um tempo significativo.
Essa parte do processo, no entanto, pode ser automatizada com um LLM. O modelo recebe uma lista de consultas de um agrupamento, determina a intenção geral e gera um título apropriado. Você pode usar tanto modelos baseados em nuvem quanto soluções locais, por exemplo, o Ollama.
É importante definir um formato de saída estrito com antecedência. Se você simplesmente pedir ao modelo para criar um nome, poderá obter explicações e comentários adicionais junto com o título. É por isso que é melhor declarar explicitamente no prompt do sistema que a saída deve conter apenas o título, sem nenhum texto adicional:
from openai import OpenAI

# 1. INITIALIZATION AND KEY
# Insert your actual API key here
client_ai = OpenAI(api_key="sk-YOUR_OPENAI_KEY")

# 2. OUR DATA (Result of hybrid clustering)
clusters = {
    0: [
       "what are anti-detect browsers for",
       "what is an anti-detect browser",
       "how anti-detect browsers work",
       "anti-detect browsers comparison",
    ],
    1: [
        "buy an anti-detect browser",
        "buy proxies for an anti-detect browser",
        "anti-detect browser trial"
    ],
    2: [
        "download anti-detect browser octo browser",
        "octo browser anti-detect browser download",
        "octo anti-detect browser download"
    ]
}

# System prompt (set rules for the model)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Sending clusters to GPT-4o-mini for automatic naming...\n")

# 3. Iterate through all clusters
for cluster_id, queries in clusters.items():
    # Send the queries from the current cluster to the API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Combine the queries into a single text
        ],
        temperature=0.3
    )

    # Get the response
    h1_title = response.choices[0].message.content

    # Print the result to the console
    print(f"Cluster #{cluster_id}")
    print(f"Phrases: {', '.join(queries)}")
    print(f"Generated H1: {h1_title}\n")
from openai import OpenAI

# 1. INITIALIZATION AND KEY
# Insert your actual API key here
client_ai = OpenAI(api_key="sk-YOUR_OPENAI_KEY")

# 2. OUR DATA (Result of hybrid clustering)
clusters = {
    0: [
       "what are anti-detect browsers for",
       "what is an anti-detect browser",
       "how anti-detect browsers work",
       "anti-detect browsers comparison",
    ],
    1: [
        "buy an anti-detect browser",
        "buy proxies for an anti-detect browser",
        "anti-detect browser trial"
    ],
    2: [
        "download anti-detect browser octo browser",
        "octo browser anti-detect browser download",
        "octo anti-detect browser download"
    ]
}

# System prompt (set rules for the model)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Sending clusters to GPT-4o-mini for automatic naming...\n")

# 3. Iterate through all clusters
for cluster_id, queries in clusters.items():
    # Send the queries from the current cluster to the API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Combine the queries into a single text
        ],
        temperature=0.3
    )

    # Get the response
    h1_title = response.choices[0].message.content

    # Print the result to the console
    print(f"Cluster #{cluster_id}")
    print(f"Phrases: {', '.join(queries)}")
    print(f"Generated H1: {h1_title}\n")
Para o conjunto de dados de teste, o resultado pode ser semelhante a este:
Cluster #0
   Phrases: what are anti-detect browsers for, what is an anti-detect browser, how anti-detect browsers work
   Generated H1: What are anti-detect browsers used for

Cluster #1
   Phrases: buy an anti-detect browser, buy proxies for an anti-detect browser, anti-detect browser trial
   Generated H1: Best anti-detect browsers and proxies for safe browsing

Cluster #2
   Phrases: download anti-detect browser octo browser, octo browser anti-detect browser download, octo anti-detect browser download
   Generated H1: Download anti-detect browser Octo Browser
Cluster #0
   Phrases: what are anti-detect browsers for, what is an anti-detect browser, how anti-detect browsers work
   Generated H1: What are anti-detect browsers used for

Cluster #1
   Phrases: buy an anti-detect browser, buy proxies for an anti-detect browser, anti-detect browser trial
   Generated H1: Best anti-detect browsers and proxies for safe browsing

Cluster #2
   Phrases: download anti-detect browser octo browser, octo browser anti-detect browser download, octo anti-detect browser download
   Generated H1: Download anti-detect browser Octo Browser
Em um projeto real, o número de agrupamentos será muito maior, por isso armazenar os dados de origem diretamente no código é impraticável. Normalmente, os agrupamentos são carregados a partir de um arquivo ou banco de dados, e os nomes gerados são gravados de volta na tabela para trabalhos futuros.
Nesta fase, o LLM não está envolvido no agrupamento em si; ele é usado apenas para pós-processar grupos já formados. Isso automatiza a parte rotineira do trabalho e fornece a você uma estrutura clara de núcleo semântico sem ter que nomear manualmente cada agrupamento.
Adicionando novas consultas
Outra vantagem de armazenar incorporações no ChromaDB é a capacidade de trabalhar com novos dados sem precisar realizar manualmente uma busca de vizinho mais próximo em todo o conjunto de dados novamente.
Após obter um novo lote de dados semânticos, as consultas passam pelo mesmo pipeline: limpeza, vetorização e adição ao ChromaDB. Para cada nova incorporação, você pode encontrar as consultas existentes mais próximas e avaliar a distância até elas.
Se os vizinhos mais próximos pertencerem a um agrupamento estável já existente e atenderem ao limite de similaridade definido, a nova consulta poderá ser adicionada a esse grupo. Se não houver nenhum agrupamento adequado, a consulta permanecerá como candidata para formar um novo grupo ou será enviada para processamento adicional.
Essa abordagem permite que você use o banco de dados vetorial acumulado como um índice para processar novas consultas, evitando a realização de uma busca completa de pares em todo o núcleo semântico cada vez que ele for atualizado.
Conclusão
Construir seu próprio pipeline baseado em modelos de incorporação, armazenamento vetorial e algoritmos de agrupamento leva tempo, pois você precisa configurá-lo, testá-lo e ajustá-lo. No entanto, uma vez feito isso, você obtém um sistema que pode ser adaptado a um tópico específico, volume de dados e requisitos do projeto.
As principais vantagens dessa abordagem são:
Menor dependência de serviços especializados. Você não precisa de um serviço de SEO separado com planos fixos e limites de volume para agrupamento. As principais limitações mudam para sua própria infraestrutura: recursos de computação, memória e espaço em disco.
Controle sobre a lógica de agrupamento. Você mesmo pode escolher o modelo de incorporação, configurar o
eps, usar dados de SERP e alterar as regras de combinação de consultas de acordo com a tarefa.Controle sobre os dados. Ao usar modelos locais e armazenamento local, os dados semânticos permanecem dentro da sua própria infraestrutura e não são enviados para APIs de terceiros.
O principal valor dessa abordagem não é substituir totalmente as ferramentas de SEO prontas, mas sim ser capaz de construir seu próprio pipeline controlável. Use o Octo Browser para automatizar a raspagem de dados semânticos e de SERP, e realize o restante do processamento localmente com incorporações, ChromaDB e algoritmos de agrupamento.
Depois de estruturar esse processo e ajustá-lo cuidadosamente usando dados reais, ele se torna mais do que um script de uso único. Ele se transforma em uma ferramenta de trabalho que você pode reutilizar e dimensionar à medida que seu núcleo semântico cresce.
Mantenha o anonimato on-line com Octo Browser. Sua verdadeira impressão digital não pode ser rastreada.
Gostaria de experimentar o Octo Browser com desconto?
Use o código promocional OCTOBLOG para obter 30% de desconto em qualquer assinatura. Esta oferta é válida apenas para novos usuários.
Coleta de dados semânticos
Existem várias abordagens para coletar dados semânticos, mas o processo básico geralmente é construído em torno do mesmo padrão: primeiro, um pool inicial de consultas é criado usando serviços como o Google Ads Keyword Planner e outras ferramentas que fornecem dados de volume de pesquisa para o tópico relevante.
O conjunto inicial é então expandido com consultas relacionadas, sugestões de pesquisa e fontes semânticas adicionais. O Key Collector era frequentemente usado para tarefas semelhantes no passado, mas hoje em dia costuma ser necessário combinar várias ferramentas ou usar scripts personalizados para coletar os dados necessários.
Uso de ferramentas de automação para coletar dados semânticos
Se as soluções comerciais não se ajustarem ao seu orçamento, requisitos de funcionalidade ou limitações, você mesmo pode automatizar parte do processo de coleta semântica. Por exemplo, para recuperar sugestões de pesquisa e outros dados de interfaces web, você pode usar navegadores headless baseados em Puppeteer ou Playwright.
Se você estiver coletando dados semânticos em um grande número de sessões paralelas, precisará gerenciar os perfis de navegador e seus ambientes com segurança. Aqui você pode usar um navegador antidetecção como o Octo Browser para isolar sessões, gerenciar configurações de perfil e conectar diferentes proxies. Isso simplifica a infraestrutura de raspagem e reduz a quantidade de configuração manual necessária para cada instância individual do navegador.
O principal desafio ao coletar dados em escala são as restrições impostas pelos mecanismos de pesquisa. Solicitações automatizadas podem acionar limites de taxa, CAPTCHAs ou outros mecanismos de proteção. Por isso, ao projetar esse fluxo de trabalho, você precisa considerar a estabilidade da sessão, a frequência das solicitações e os bloqueios temporários.
Ao trabalhar com automação de navegadores, também é importante controlar os parâmetros do ambiente, como o User-Agent, tamanho da janela, localidade, WebGL e outras características da sessão do navegador. Você pode fazer isso usando suas próprias configurações de Puppeteer ou Playwright ou soluções de navegadores especializados que permitem criar perfis isolados com diferentes parâmetros de ambiente.
Outra tarefa distinta é a organização da infraestrutura de rede. Você pode usar diferentes tipos de proxies para coleta de dados distribuída: datacenter, residencial ou móvel. A escolha depende do volume de solicitações e dos requisitos de estabilidade, velocidade e custo. Os proxies de datacenter geralmente são mais baratos e rápidos, mas em certos cenários têm maior probabilidade de serem restritos. Os endereços residenciais e móveis geralmente são mais resilientes, mas custam mais e oferecem menor taxa de transferência.
Depois de concluir a coleta de dados principal, você pode complementar a lista final de consultas com dados de bancos de dados semânticos externos. O resultado deve ser um conjunto de consultas o mais completo possível, que poderá então ser enviado para as etapas de limpeza, normalização e posterior agrupamento (clustering).
Limpeza de dados antes da vetorização
Depois de coletar seus dados semânticos, você terá um arquivo contendo dezenas de milhares de consultas de pesquisa. À primeira vista, pode parecer pronto para vetorização e agrupamento, mas a qualidade do resultado depende muito de quão bem os dados foram preparados previamente.
Nesta fase, as bibliotecas Pandas e NumPy são convenientes para limpar e normalizar o conjunto de dados de entrada. Uma lista de consultas brutas quase sempre contém duplicatas, caracteres desnecessários, poluição técnica, frases irrelevantes e outros artefatos introduzidos durante a análise e a fusão de várias fontes.
De qualquer forma, um modelo de incorporação (embedding) converterá essas strings em vetores, mas isso cria uma sobrecarga computacional desnecessária e pode degradar a estrutura dos agrupamentos resultantes. É por isso que é uma boa ideia trazer os dados para um formato consistente e previsível antes da vetorização.
As principais etapas de preparação são as seguintes:
Remoção de poluição técnica. Tags HTML, espaços extras, caracteres invisíveis, emojis e outros elementos que possam ter entrado nos dados durante a raspagem são removidos.
Deduzimento global. Ao combinar consultas de várias fontes, as sobreposições são quase inevitáveis. Não há sentido em vetorizar strings idênticas mais de uma vez, portanto, as duplicatas completas devem ser removidas com antecedência.
Filtragem de palavras de parada (stop-words). Nesta etapa, você pode excluir consultas contendo nomes de locais irrelevantes, marcadores indesejados ou palavras que não se encaixam nos requisitos do projeto. Por exemplo, dados semânticos comerciais podem excluir consultas com palavras como "grátis", "torrent" e modificadores semelhantes.
Reduzir palavras à sua forma de dicionário (lematização) é opcional. Os modelos modernos entendem bem diferentes formas da mesma palavra e frases equivalentes. Por exemplo, eles podem reconhecer que "comprar iPhone" e "quero comprar um iPhone" são quase a mesma consulta. Portanto, não há necessidade de alterar deliberadamente as palavras antes do processamento. No entanto, um pré-processamento simples pode ajudar a identificar consultas semelhantes e reduzir a quantidade de dados.
O resultado deve ser um conjunto limpo e filtrado de consultas exclusivas sem ruídos técnicos óbvios. Os dados podem então ser passados para a próxima etapa — conversão de texto em representações vetoriais.
Vetorização de consultas de pesquisa
O agrupamento vetorial difere da comparação tradicional de strings porque não trabalha com correspondências exatas de palavras, mas com suas representações semânticas. Cada consulta de pesquisa é convertida em um vetor numérico — uma incorporação (embedding) — que codifica suas características semânticas.
Modelos de incorporação especializados são usados para isso. O texto é primeiro dividido em tokens, após o qual o modelo gera um vetor de dimensionalidade fixa. Como resultado, consultas semânticamente semelhantes são posicionadas mais próximas umas das outras no espaço vetorial.
Por exemplo, as frases "comprar iPhone 15" e "preço do iPhone 15 Pro" terão vetores mais semelhantes do que "comprar iPhone 15" e "conserto de telefone Apple". Essa propriedade torna possível usar algoritmos de agrupamento para agrupar consultas.
Soluções comerciais (OpenAI, Claude)
Para vetorização, você pode usar tanto APIs de nuvem quanto modelos locais. A escolha depende do volume de dados, dos requisitos de qualidade, da infraestrutura disponível e do custo aceitável de processamento.
As APIs comerciais são convenientes porque não exigem a implantação de modelos locais e permitem que você comece rapidamente. O provedor cuida da infraestrutura, atualizações de modelos e dimensionamento computacional.
Para conjuntos de dados de pequeno e médio porte, esta é uma das soluções mais simples. No entanto, ao processar centenas de milhares ou milhões de consultas, você precisa considerar os custos da API, os limites de solicitação e a taxa de transferência.
Além disso, trabalhar com APIs exige uma arquitetura tolerante a falhas (contornando os limites da API por meio de multicontas, rotação de chaves e solicitações assíncronas via aiohttp).
Você mesmo pode testar como as redes neurais comerciais funcionam com suas consultas usando o seguinte código:
import os
from openai import OpenAI

# Initialize the client
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Our raw dataset
queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

# 1. Vectorize queries through OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# The result is a set of ready-made multidimensional vectors
embeddings = [data.embedding for data in response.data]
Modelos locais do ecossistema Hugging Face
Uma alternativa às APIs comerciais são os modelos de incorporação abertos que funcionam localmente. Por exemplo, para tarefas multilíngues, você pode usar jinaai/jina-embeddings-v3 ou Alibaba-NLP/gte-multilingual-large, que não geram custos por geração.
from sentence_transformers import SentenceTransformer

print("⏳ 1. Loading stable BGE-m3 model...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

print(f"⏳ 2. Vectorizing {len(queries)} queries...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Done! Let's look at the result:")
print(f"📊 Data dimensions: {embeddings.shape}")
print("🔍 Vector for the phrase 'buy iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... and {len(embeddings[0]) - 5} more numbers.")
A principal vantagem dos modelos locais é que todo o pipeline de processamento permanece dentro da sua própria infraestrutura. Você processa as consultas de pesquisa sem enviá-las a uma API de terceiros e, uma vez carregado o modelo, pode vetorizá-las sem pagar por cada solicitação individual.
Trabalhar com modelos locais costuma ser mais econômico: eles permitem realizar a vetorização sem pagar por cada chamada de API. Ao mesmo tempo, exigem uma quantidade significativa de espaço em disco: junto com os pesos do modelo e o cache, podem ocupar vários gigabytes. Se você não precisar mais de um modelo, é uma boa ideia remover seus arquivos locais e limpar o cache depois de terminar de trabalhar com ele.
Armazenamento e busca de representações vetoriais
Após a vetorização, cada consulta de pesquisa é representada como um vetor de incorporação. A próxima questão é onde armazenar esses dados e como encontrar com eficiência consultas semânticamente semelhantes.
Para pequenos conjuntos de dados, os vetores podem permanecer na memória, por exemplo, em matrizes NumPy ou estruturas Pandas. Se houver apenas alguns milhares de consultas, isso costuma ser suficiente para experimentos e processamento local.
À medida que o conjunto de dados cresce, a situação muda. Se cada vetor for comparado diretamente com todos os outros, o número de operações cresce quadraticamente. Para dezenas ou centenas de milhares de consultas, isso rapidamente se torna intensivo em recursos, tanto em termos de tempo de computação quanto de uso de memória.
Esse problema é resolvido com bancos de dados vetoriais. Eles são otimizados especificamente para tais tarefas e suportam algoritmos de busca de vizinhos mais próximos aproximados (em particular, HNSW). Os índices integrados tornam possível evitar a comparação direta de cada vetor com todos os outros e fornecem buscas quase instantâneas pelas frases mais semelhantes, mesmo entre milhões de registros.
Existem várias soluções populares para essas tarefas: Pinecone, Qdrant, PostgreSQL com a extensão pgvector e outras. Em nosso exemplo, usaremos o ChromaDB. Ele é muito adequado para experimentos locais: funciona sem um servidor separado, armazena dados em disco e se integra facilmente com código Python.
Vamos salvar as incorporações obtidas na etapa anterior e verificar como funciona a busca semântica:
import chromadb

# 1. Initialize the local database (creates the semantic_db folder)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Create the collection
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Load our vectors and query texts
collection.add(
    embeddings=embeddings.tolist(), # vectors from our local BGE-m3 model
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Data saved to the database!\n")

# ==========================================
# SEARCH MAGIC: let's check how the database understands meaning
# ==========================================
test_phrase = "how much does the new iphone cost"
print(f"Searching the database for the phrase: '{test_phrase}'")

# Convert the test phrase into a vector using the same model
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Ask the database to find the two most similar options
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Closest query: {results['documents'][0][0]} (Distance: {results['distances'][0][0]:.4f})")
print(f"Second closest: {results['documents'][0][1]} (Distance: {results['distances'][0][1]:.4f})")
Escolhendo um algoritmo de agrupamento
Depois que os vetores de incorporação foram obtidos, você pode passar para a próxima etapa — agrupar as consultas de pesquisa. Nesta fase, é importante escolher um algoritmo que corresponda à estrutura dos dados e não exija suposições excessivamente rígidas sobre o número de agrupamentos futuros.
Por que o K-Means nem sempre é adequado para o agrupamento de SEO
O K-Means é um algoritmo de agrupamento clássico que divide os dados em um número predefinido de grupos. O número de agrupamentos é especificado com o parâmetro k.
Por exemplo, se temos 10.000 consultas de pesquisa e especificamos k=500, o algoritmo criará 500 centroides e atribuirá cada consulta ao mais próximo no espaço vetorial.
A principal limitação dessa abordagem é que o número de agrupamentos deve ser determinado com antecedência. Isso nem sempre é conveniente para um núcleo semântico: antes de o processamento começar, é difícil saber quantos grupos de intenção independentes o conjunto de dados contém — 50, 500 ou 1.200.
Se k for mal escolhido, consultas relacionadas podem acabar divididas em vários grupos. O inverso também pode acontecer: consultas que são próximas em tópicos, mas diferem em intenção, podem ser fundidas simplesmente porque o algoritmo precisa criar o número especificado de agrupamentos.
Agrupamento com DBSCAN
Se o número de grupos não for conhecido com antecedência, você poderá usar algoritmos de agrupamento baseados em densidade. Uma das soluções mais conhecidas é o DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
Ao contrário do K-Means, o DBSCAN não exige que você especifique o número de agrupamentos previamente. O algoritmo busca regiões no espaço vetorial onde os objetos estão suficientemente próximos e forma grupos a partir deles.
O comportamento do DBSCAN é determinado por dois parâmetros principais:
eps(épsilon/distância): a distância máxima entre pontos para que sejam considerados vizinhos. No nosso caso, esse é o limite de similaridade por cosseno dos vetores.min_samples: o número mínimo de vizinhos necessários para formar um agrupamento completo.
O DBSCAN escolhe uma primeira consulta aleatória. Se houver pelo menos min_samples outras consultas dentro de um raio eps em torno dela, um núcleo de agrupamento é formado. O algoritmo então se expande em todas as direções, adicionando novos vizinhos até que a densidade acabe.
O parâmetro eps pode ser comparado grosseiramente ao rigor do agrupamento:
Um
epsmenor corresponde a um agrupamento mais rigoroso. Apenas consultas com representações vetoriais muito semelhantes acabarão no mesmo agrupamento, portanto, você geralmente obtém mais grupos, e eles se tornam mais compactos.Um
epsmaior torna as condições de fusão mais permissivas. Os agrupamentos tornam-se maiores e podem incluir uma semântica mais ampla, mas o risco de combinar consultas com intenções diferentes também aumenta.
Outra propriedade útil do DBSCAN é sua capacidade de identificar ruído. Se uma consulta não estiver localizada em uma região suficientemente densa do espaço vetorial, o algoritmo não tenta forçá-la a entrar em um dos agrupamentos existentes. Em vez disso, ele marca a consulta como um Outlier (ponto fora da curva). Você pode exportar essas consultas para um arquivo separado para revisão manual, em vez de comprometer páginas de destino que de outra forma estariam limpas.
Ao mesmo tempo, o DBSCAN é sensível à escolha de eps: um único limite nem sempre funciona bem com dados nos quais alguns grupos são muito densos e outros são muito mais dispersos.
Nesses casos, considere o HDBSCAN, uma extensão hierárquica da abordagem baseada em densidade. Ele pode encontrar agrupamentos com densidades diferentes, adaptando automaticamente o parâmetro eps onde as consultas estão mais compactadas ou, inversamente, mais dispersas.
O script de agrupamento
Vamos extrair nossos vetores do banco de dados ChromaDB local e executá-los no DBSCAN usando a biblioteca scikit-learn:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Connecting to the vector database...")
client = chromadb.PersistentClient(path="./semantic_db")

# Extract the collection with the vectors (use your own name)
collection = client.get_collection(name="search_queries")

# Extract all query texts and their mathematical vectors
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Queries extracted from the database: {len(documents)}")

# ==========================================
# CLUSTERING (DBSCAN)
# ==========================================
print("⏳ 2. Starting the DBSCAN algorithm...")

# SETTINGS:
# eps = 0.15 (Allowed cosine distance. The smaller it is, the stricter the clusters);
# min_samples = 2 (Minimum of 2 queries to create a group);
# metric="cosine" (We explicitly specify that we measure angles between vectors, not linear distance).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Run the grouping
labels = dbscan.fit_predict(embeddings)

# ==========================================
# OUTPUT RESULTS
# ==========================================
# The algorithm assigned each query a group number (0, 1, 2...).
# If a query is recognized as noise (Outlier), it receives the label -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== GROUPING RESULTS ===")
for cluster_id, docs in clusters.items():
    print(f"\n Cluster #{cluster_id} (Queries: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Outliers/Noise (Queries: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
O exemplo acima usa um modelo local, mas ao trabalhar com modelos de incorporação comerciais, o valor de eps pode exigir ajustes adicionais. Em particular, um limite de 0.15 que funciona para um modelo pode, com outra configuração, fazer com que uma parte significativa das consultas se funda em um único grande agrupamento ou seja classificada incorretamente como ruído.
Portanto, sempre que você mudar de modelo, deve ajustar o eps separadamente com base na distribuição das distâncias entre os vetores e na qualidade real dos grupos resultantes.
Agrupamento híbrido para separar intenções de busca
O agrupamento pode ser feito exclusivamente com vetores de incorporação, mas na prática isso muitas vezes não é suficiente. A similaridade semântica nem sempre significa que a intenção de busca seja a mesma.
Por exemplo, as consultas "comprar um navegador antidetecção" e "o que é um navegador antidetecção" são muito próximas em termos de tópico. O modelo de incorporação reconhece corretamente que ambas as frases se referem ao mesmo objeto, de modo que a distância entre seus vetores será pequena. Como resultado, o DBSCAN provavelmente colocará essas consultas no mesmo agrupamento.
Do ponto de vista de SEO, isso é indesejável porque a intenção difere. A primeira implica uma página de destino comercial, enquanto a segunda implica conteúdo informativo.
Vamos demonstrar isso com um pequeno conjunto de dados de teste:
queries = [
    # Informational
    "what are antidetect browsers for",
    "what is an antidetect browser",
    "how antidetect browsers work",
    "antidetect browsers comparison",

    # Commercial
    "buy an anti-detect browser",
    "buy proxies for an anti-detect browser",
    "anti-detect browser trial",

    # Download
    "download anti-detect browser octo browser",
    "octo browser anti-detect browser download",
    "octo anti-detect browser download",

    # Queries on a different topic
    "ford everest 2024 review",
    "buy used ford everest",

    # Noise
    "weather in pattaya in May",
    "tom yum soup recipe"
]
Ao agrupar apenas por similaridade vetorial, as consultas relacionadas a navegadores antidetecção podem acabar no mesmo grupo, apesar das diferenças de intenção.
Nesta fase, o navegador antidetecção torna-se mais uma vez parte do pipeline, mas não para coletar dados semânticos. Em vez disso, ele é usado para coletar dados de SERP (páginas de resultados de busca). Para cada consulta, você precisa coletar resultados de pesquisa e usar as sobreposições de URL como um sinal de agrupamento adicional.
Com um grande número de consultas, essa coleta pode ser convenientemente distribuída em perfis de navegador isolados, por exemplo, usando o Octo Browser junto com o Playwright ou Puppeteer.
Para cada consulta, colete as 10 principais URLs dos resultados de pesquisa. Em seguida, antes de executar o DBSCAN, compare os resultados de frases semânticamente semelhantes. Se duas consultas não tiverem URLs em comum ou se o número de URLs comuns estiver abaixo de um limite definido, a distância entre os vetores correspondentes será aumentada artificialmente.
Dessa forma, as incorporações são usadas para encontrar consultas semânticamente semelhantes, enquanto a análise de SERP atua como uma restrição adicional e ajuda a evitar que frases com intenções de busca diferentes sejam mescladas.
Após adicionar os dados dos resultados de pesquisa, o conjunto de dados de teste discutido anteriormente neste artigo é distribuído de forma diferente:
O número de agrupamentos aumenta, e os próprios grupos correspondem melhor à intenção de busca pretendida das consultas.
Pós-processamento de resultados e atualização de dados
Depois de formar os agrupamentos, há mais uma tarefa prática — atribuir um nome claro a cada grupo. Números como "Agrupamento #42" são convenientes para um algoritmo, mas dizem muito pouco a um especialista em SEO, editor ou redator de conteúdo.
Nomeação automática de agrupamentos com um LLM
Ao trabalhar manualmente, um especialista precisa revisar o conteúdo de cada grupo, determinar a intenção principal e criar um nome para a futura página ou peça de conteúdo. Se houver várias centenas de agrupamentos, essa etapa consome um tempo significativo.
Essa parte do processo, no entanto, pode ser automatizada com um LLM. O modelo recebe uma lista de consultas de um agrupamento, determina a intenção geral e gera um título apropriado. Você pode usar tanto modelos baseados em nuvem quanto soluções locais, por exemplo, o Ollama.
É importante definir um formato de saída estrito com antecedência. Se você simplesmente pedir ao modelo para criar um nome, poderá obter explicações e comentários adicionais junto com o título. É por isso que é melhor declarar explicitamente no prompt do sistema que a saída deve conter apenas o título, sem nenhum texto adicional:
from openai import OpenAI

# 1. INITIALIZATION AND KEY
# Insert your actual API key here
client_ai = OpenAI(api_key="sk-YOUR_OPENAI_KEY")

# 2. OUR DATA (Result of hybrid clustering)
clusters = {
    0: [
       "what are anti-detect browsers for",
       "what is an anti-detect browser",
       "how anti-detect browsers work",
       "anti-detect browsers comparison",
    ],
    1: [
        "buy an anti-detect browser",
        "buy proxies for an anti-detect browser",
        "anti-detect browser trial"
    ],
    2: [
        "download anti-detect browser octo browser",
        "octo browser anti-detect browser download",
        "octo anti-detect browser download"
    ]
}

# System prompt (set rules for the model)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Sending clusters to GPT-4o-mini for automatic naming...\n")

# 3. Iterate through all clusters
for cluster_id, queries in clusters.items():
    # Send the queries from the current cluster to the API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Combine the queries into a single text
        ],
        temperature=0.3
    )

    # Get the response
    h1_title = response.choices[0].message.content

    # Print the result to the console
    print(f"Cluster #{cluster_id}")
    print(f"Phrases: {', '.join(queries)}")
    print(f"Generated H1: {h1_title}\n")
Para o conjunto de dados de teste, o resultado pode ser semelhante a este:
Cluster #0
   Phrases: what are anti-detect browsers for, what is an anti-detect browser, how anti-detect browsers work
   Generated H1: What are anti-detect browsers used for

Cluster #1
   Phrases: buy an anti-detect browser, buy proxies for an anti-detect browser, anti-detect browser trial
   Generated H1: Best anti-detect browsers and proxies for safe browsing

Cluster #2
   Phrases: download anti-detect browser octo browser, octo browser anti-detect browser download, octo anti-detect browser download
   Generated H1: Download anti-detect browser Octo Browser
Em um projeto real, o número de agrupamentos será muito maior, por isso armazenar os dados de origem diretamente no código é impraticável. Normalmente, os agrupamentos são carregados a partir de um arquivo ou banco de dados, e os nomes gerados são gravados de volta na tabela para trabalhos futuros.
Nesta fase, o LLM não está envolvido no agrupamento em si; ele é usado apenas para pós-processar grupos já formados. Isso automatiza a parte rotineira do trabalho e fornece a você uma estrutura clara de núcleo semântico sem ter que nomear manualmente cada agrupamento.
Adicionando novas consultas
Outra vantagem de armazenar incorporações no ChromaDB é a capacidade de trabalhar com novos dados sem precisar realizar manualmente uma busca de vizinho mais próximo em todo o conjunto de dados novamente.
Após obter um novo lote de dados semânticos, as consultas passam pelo mesmo pipeline: limpeza, vetorização e adição ao ChromaDB. Para cada nova incorporação, você pode encontrar as consultas existentes mais próximas e avaliar a distância até elas.
Se os vizinhos mais próximos pertencerem a um agrupamento estável já existente e atenderem ao limite de similaridade definido, a nova consulta poderá ser adicionada a esse grupo. Se não houver nenhum agrupamento adequado, a consulta permanecerá como candidata para formar um novo grupo ou será enviada para processamento adicional.
Essa abordagem permite que você use o banco de dados vetorial acumulado como um índice para processar novas consultas, evitando a realização de uma busca completa de pares em todo o núcleo semântico cada vez que ele for atualizado.
Conclusão
Construir seu próprio pipeline baseado em modelos de incorporação, armazenamento vetorial e algoritmos de agrupamento leva tempo, pois você precisa configurá-lo, testá-lo e ajustá-lo. No entanto, uma vez feito isso, você obtém um sistema que pode ser adaptado a um tópico específico, volume de dados e requisitos do projeto.
As principais vantagens dessa abordagem são:
Menor dependência de serviços especializados. Você não precisa de um serviço de SEO separado com planos fixos e limites de volume para agrupamento. As principais limitações mudam para sua própria infraestrutura: recursos de computação, memória e espaço em disco.
Controle sobre a lógica de agrupamento. Você mesmo pode escolher o modelo de incorporação, configurar o
eps, usar dados de SERP e alterar as regras de combinação de consultas de acordo com a tarefa.Controle sobre os dados. Ao usar modelos locais e armazenamento local, os dados semânticos permanecem dentro da sua própria infraestrutura e não são enviados para APIs de terceiros.
O principal valor dessa abordagem não é substituir totalmente as ferramentas de SEO prontas, mas sim ser capaz de construir seu próprio pipeline controlável. Use o Octo Browser para automatizar a raspagem de dados semânticos e de SERP, e realize o restante do processamento localmente com incorporações, ChromaDB e algoritmos de agrupamento.
Depois de estruturar esse processo e ajustá-lo cuidadosamente usando dados reais, ele se torna mais do que um script de uso único. Ele se transforma em uma ferramenta de trabalho que você pode reutilizar e dimensionar à medida que seu núcleo semântico cresce.
Mantenha-se atualizado com as últimas notícias do Octo Browser
Ao clicar no botão, você concorda com a nossa Política de Privacidade.
Mantenha-se atualizado com as últimas notícias do Octo Browser
Ao clicar no botão, você concorda com a nossa Política de Privacidade.
Mantenha-se atualizado com as últimas notícias do Octo Browser
Ao clicar no botão, você concorda com a nossa Política de Privacidade.
Junte-se ao Octo Browser agora mesmo
Ou entre em contato com a equipe de suporte no chat para tirar dúvidas a qualquer momento.
Junte-se ao Octo Browser agora mesmo
Ou entre em contato com a equipe de suporte no chat para tirar dúvidas a qualquer momento.
Junte-se ao Octo Browser agora mesmo
Ou entre em contato com a equipe de suporte no chat para tirar dúvidas a qualquer momento.