搜索查询的向量聚类:使用 ChromaDB、嵌入(embeddings)和 Python 构建您自己的系统


Markus_automation
Expert in data parsing and automation
聚类是处理语义数据时最耗费人力的阶段之一。收集和清理查询池相对简单,但将数千个关键词正确分配到具有相同搜索意图的聚类中就要困难得多。
Rush Analytics、Key.so和Key Collector等聚类工具简化了这一任务,但在数量、设置和结果质量方面存在局限性。这在复杂的利基市场中尤为明显,在这些市场中,自动算法可能会将不同意图的查询合并,或将含义非常接近的短语拆分。
神经网络方法使以不同方式解决这一任务成为可能。查询不再是比较单个单词和词汇匹配,而是被转换为称为嵌入的多维向量。这些向量可以通过语义相似性进行比较,并用于自动形成聚类。
在本文中,我们将介绍如何在本地计算机或服务器上构建您自己的可扩展聚类管道——从使用反检测浏览器自动收集语义和SERP数据,到向量化、分组以及结果的后处理。
内容
使用Octo Browser维护您的在线匿名性。您真实的数字指纹无法被追踪。
您想以折扣价体验 Octo Browser 吗?
使用优惠码 OCTOBLOG 即可享受任何订阅的 30% 优惠。此优惠仅对新用户有效。
收集语义数据
收集语义数据有几种方法,但基本流程通常是围绕相同的模式构建的:首先,使用 Google Ads 关键字规划师等服务以及其他提供相关主题搜索量数据的工具来创建初始查询池。
然后,利用相关查询、搜索建议和其他语义来源扩展初始集。过去,Key Collector 经常被用于类似的任务,但今天,通常需要结合使用几种工具或使用自定义脚本来收集必要的数据。
使用自动化工具收集语义数据
如果商业解决方案不符合您的预算、功能要求或限制,您可以自己将部分语义收集流程自动化。例如,要从 Web 界面检索搜索建议和其他数据,您可以使用基于 Puppeteer 或 Playwright 的无头浏览器。
如果您在大量的并行会话中收集语义数据,则需要安全地管理浏览器配置文件及其环境。在这里,您可以使用反检测浏览器(如 Octo Browser)来隔离会话、管理配置文件设置并连接不同的代理。这简化了抓取基础设施,并减少了每个单独浏览器实例所需的手动配置量。
大规模收集数据时的主要挑战是搜索引擎施加的限制。自动请求可能会触发频率限制、CAPTCHA 或其他保护机制,因此在设计此类管道时,您需要考虑会话稳定性、请求频率和临时封锁。
在使用浏览器自动化时,控制环境参数(如 User-Agent、窗口大小、语言环境、WebGL 以及其他浏览器会话特征)也同样重要。您可以使用自己的 Puppeteer 或 Playwright 配置或专业的浏览器解决方案来做到这一点,这些解决方案允许您创建具有不同环境参数的隔离配置文件。
另一个单独的任务是组织网络基础设施。您可以使用不同类型的代理进行分布式数据收集:数据中心代理、住宅代理或移动代理。选择取决于请求量以及对稳定性、速度和成本的要求。数据中心代理通常更便宜、更快,但在某些情况下,它们更有可能受到限制。住宅和移动地址通常更具弹性,但成本较高且吞吐量较低。
一旦主要数据收集完成,您就可以用来自外部语义数据库的数据来补充最终的查询列表。结果应该是尽可能完整的查询集,然后可以将其传递给清洗、规范化和进一步的聚类阶段。
在向量化之前清洗数据
收集完语义数据后,您将获得一个包含数万个搜索查询的文件。乍一看,它似乎已经可以进行向量化和聚类了,但结果的质量在很大程度上取决于数据预先准备得如何。
在此阶段,Pandas 和 NumPy 库对于清洗和规范化输入数据集非常方便。原始查询列表几乎总是包含重复项、无用字符、技术杂乱、无关短语以及在解析和合并多个数据源期间引入的其他人工痕迹。
嵌入模型无论如何都会将这些字符串转换为向量,但这会产生不必要的计算开销,并可能会降低所得聚类的结构。这就是为什么最好在向量化之前将数据整理成一致且可预测的格式。
主要的准备阶段如下:
删除技术杂乱。 删除 HTML 标签、多余空格、不可见字符、表情符号以及在抓取过程中可能进入数据的其他元素。
全局去重。 当合并来自多个来源的查询时,重叠几乎是不可避免的。多次向量化相同的字符串是没有意义的,因此应提前删除完全重复的项。
停用词过滤。 在此阶段,您可以排除包含无关地名、不需要的标记或不符合项目要求的单词的查询。例如,商业语义数据可能会排除包含“免费”、“种子”等修饰词的查询。
将单词还原为词典形式(词形还原)是可选的。 现代模型能很好地理解相同单词的不同形式和等效短语。例如,它们可以识别出“购买 iPhone”和“我想买一部 iPhone”几乎是相同的查询。因此,没有必要在处理前刻意改变单词。然而,简单的预处理可以帮助识别相似的查询并减少数据量。
结果应该是一个干净且经过过滤的唯一查询集,没有明显的技术噪点。然后,数据可以被传递到下一个阶段——将文本转换为向量表示。
向量化搜索查询
向量聚类不同于传统的字符串比较,因为它不处理精确的单词匹配,而是处理它们的语义表示。每个搜索查询都被转换为一个数值向量(即嵌入),该向量对它的语义特征进行编码。
为此需要使用专门的嵌入模型。首先将文本分割成标记,然后模型生成一个固定维度的向量。因此,语义相似的查询在向量空间中彼此靠得更近。
例如,相比“购买 iPhone 15”和“苹果手机维修”,“购买 iPhone 15”和“iPhone 15 Pro 价格”这两个短语将具有更相似的向量。这一特性使得使用聚类算法对查询进行分组成为可能。
商业解决方案 (OpenAI, Claude)
对于向量化,您既可以使用云端 API,也可以使用本地模型。选择取决于数据量、质量要求、可用基础设施以及可接受的处理成本。
商业 API 很方便,因为它们不需要本地模型部署,并且可以让您快速上手。提供商负责基础设施、模型更新和计算扩展。
对于中小型数据集,这是最简单的解决方案之一。然而,当处理数十万或数百万个查询时,您需要考虑 API 成本、请求限制和吞吐量。
此外,使用 API 需要容错架构(通过多账号、密钥轮换以及通过 aiohttp 进行异步请求来绕过 API 限制)。
您可以使用以下代码自己测试商业神经网络如何处理您的查询:
import os
from openai import OpenAI

# Initialize the client
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Our raw dataset
queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

# 1. Vectorize queries through OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# The result is a set of ready-made multidimensional vectors
embeddings = [data.embedding for data in response.data]
import os
from openai import OpenAI

# Initialize the client
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Our raw dataset
queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

# 1. Vectorize queries through OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# The result is a set of ready-made multidimensional vectors
embeddings = [data.embedding for data in response.data]
来自 Hugging Face 生态系统的本地模型
商业 API 的替代方案是本地运行的开源嵌入模型。例如,对于多语言任务,您可以使用 jinaai/jina-embeddings-v3 或 Alibaba-NLP/gte-multilingual-large,这些模型不会产生单次生成费用。
from sentence_transformers import SentenceTransformer

print("⏳ 1. Loading stable BGE-m3 model...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

print(f"⏳ 2. Vectorizing {len(queries)} queries...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Done! Let's look at the result:")
print(f"📊 Data dimensions: {embeddings.shape}")
print("🔍 Vector for the phrase 'buy iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... and {len(embeddings[0]) - 5} more numbers.")
from sentence_transformers import SentenceTransformer

print("⏳ 1. Loading stable BGE-m3 model...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

print(f"⏳ 2. Vectorizing {len(queries)} queries...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Done! Let's look at the result:")
print(f"📊 Data dimensions: {embeddings.shape}")
print("🔍 Vector for the phrase 'buy iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... and {len(embeddings[0]) - 5} more numbers.")
本地模型的主要优势在于整个处理管道都保留在您自己的基础设施内。您在处理搜索查询时无需将其发送给第三方 API,并且一旦加载了模型,您就可以对其进行向量化,而无需为每个单独的请求付费。
使用本地模型通常更具成本效益:它们让您无需为每次 API 调用付费即可进行向量化。同时,它们需要大量的磁盘空间:连同模型权重和缓存,它们可能会占用几个吉字节。如果您不再需要某个模型,最好在结束工作后删除其本地文件并清除缓存。
存储并搜索向量表示
向量化之后,每个搜索查询都被表示为一个嵌入向量。接下来的问题是在哪里存储这些数据以及如何高效地找到语义相似的查询。
对于小型数据集,向量可以保留在内存中,例如在 NumPy 数组或 Pandas 结构中。如果只有几千个查询,这通常足够用于实验和本地处理。
随着数据集的增长,情况发生了变化。如果将每个向量直接与所有其他向量进行比较,操作次数将呈二次方增长。对于数十万或数百万个查询,这在计算时间和内存使用方面都会迅速变得消耗资源。
这个问题可以通过向量数据库来解决。它们专门针对此类任务进行了优化,并支持近似最近邻搜索算法(特别是 HNSW)。内置索引使得避免直接比较每个向量与每个其他向量成为可能,并且即使在数百万条记录中也能几乎瞬间搜索到最相似的短语。
对于这些任务,有几种流行的解决方案:Pinecone、Qdrant、带有 pgvector 扩展的 PostgreSQL 等。在我们的示例中,我们将使用 ChromaDB。它非常适合本地实验:无需单独服务器即可运行,将数据存储在磁盘上,并且易于与 Python 代码集成。
让我们保存上一步获得的嵌入,并检查语义搜索是如何工作的:
import chromadb

# 1. Initialize the local database (creates the semantic_db folder)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Create the collection
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Load our vectors and query texts
collection.add(
    embeddings=embeddings.tolist(), # vectors from our local BGE-m3 model
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Data saved to the database!\n")

# ==========================================
# SEARCH MAGIC: let's check how the database understands meaning
# ==========================================
test_phrase = "how much does the new iphone cost"
print(f"Searching the database for the phrase: '{test_phrase}'")

# Convert the test phrase into a vector using the same model
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Ask the database to find the two most similar options
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Closest query: {results['documents'][0][0]} (Distance: {results['distances'][0][0]:.4f})")
print(f"Second closest: {results['documents'][0][1]} (Distance: {results['distances'][0][1]:.4f})")
import chromadb

# 1. Initialize the local database (creates the semantic_db folder)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Create the collection
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Load our vectors and query texts
collection.add(
    embeddings=embeddings.tolist(), # vectors from our local BGE-m3 model
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Data saved to the database!\n")

# ==========================================
# SEARCH MAGIC: let's check how the database understands meaning
# ==========================================
test_phrase = "how much does the new iphone cost"
print(f"Searching the database for the phrase: '{test_phrase}'")

# Convert the test phrase into a vector using the same model
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Ask the database to find the two most similar options
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Closest query: {results['documents'][0][0]} (Distance: {results['distances'][0][0]:.4f})")
print(f"Second closest: {results['documents'][0][1]} (Distance: {results['distances'][0][1]:.4f})")
选择聚类算法
一旦获得了嵌入向量,就可以进入下一个阶段——对搜索查询进行分组。在这一阶段,重要的是选择一种与数据结构相匹配的算法,并且不需要对未来的聚类数量做出过于生硬的假设。
为什么 K-Means 并不总是适用于 SEO 聚类
K-Means 是一种经典的聚类算法,它将数据划分为预先定义好数量的组。聚类的数量是通过 k 参数指定的。
例如,如果我们有 10,000 个搜索查询并指定 k=500,该算法将创建 500 个质心,并将每个查询分配给向量空间中最近的一个。
这种方法的主要局限性在于必须提前确定聚类的数量。对于语义核心来说,这并不总是方便的:在处理开始之前,很难知道数据集包含多少个独立的意图组——是 50、500 还是 1,200 个。
如果 k 选择不当,相关的查询可能会被拆分到几个组中。相反的情况也可能发生:主题相近但意图不同的查询可能会被合并,这仅仅是因为算法必须创建指定数量的聚类。
使用 DBSCAN 进行聚类
如果无法提前知道组的数量,您可以使用基于密度的聚类算法。其中最著名的解决方案之一是 DBSCAN(基于密度的空间聚类应用噪声)。
与 K-Means 不同,DBSCAN 不需要您预先指定聚类的数量。该算法在向量空间中寻找对象足够接近的区域并从中形成组。
DBSCAN 的行为由两个主要参数决定:
eps(epsilon/距离):点之间被视为邻居的最大距离。在我们的案例中,这是向量的余弦相似度阈值。min_samples:形成一个完整聚类所需的最小邻居数。
DBSCAN 获取第一个随机查询。如果在其 eps 半径内有 min_samples 个其他查询,则形成一个聚类核心。然后算法向所有方向扩展,添加新的邻居,直到密度耗尽。
eps 参数可以粗略地比作聚类的严格程度:
较小的
eps对应于更严格的分组。只有具有非常相似的向量表示的查询才会最终归入同一个聚类中,因此您通常会获得更多的组,并且它们会更加紧凑。较大的
eps使得合并条件更宽松。聚类变得更大,并且可能包括更广泛的语义,但合并具有不同意图的查询的风险也会增加。
DBSCAN 的另一个有用特性是它能够识别噪声。如果查询不位于向量空间中足够密集的区域,该算法不会试图将其强行塞入现有的聚类之一。相反,它会将该查询标记为离群值 (Outlier)。您可以将这些查询导出到单独的文件中进行人工审核,而不是影响原本干净的着陆页。
同时,DBSCAN 对 eps 的选择很敏感:单一阈值在某些组非常密集而其他组要稀疏得多的数据中并不总是能很好地工作。
在这些情况下,请考虑 HDBSCAN,这是基于密度方法的层次扩展。它可以找到具有不同密度的聚类,并在查询排列得更紧密或相反更分散的地方自动适应 eps 参数。
聚类脚本
让我们从本地 ChromaDB 数据库中提取我们的向量,并通过使用 scikit-learn 库的 DBSCAN 运行它们:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Connecting to the vector database...")
client = chromadb.PersistentClient(path="./semantic_db")

# Extract the collection with the vectors (use your own name)
collection = client.get_collection(name="search_queries")

# Extract all query texts and their mathematical vectors
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Queries extracted from the database: {len(documents)}")

# ==========================================
# CLUSTERING (DBSCAN)
# ==========================================
print("⏳ 2. Starting the DBSCAN algorithm...")

# SETTINGS:
# eps = 0.15 (Allowed cosine distance. The smaller it is, the stricter the clusters);
# min_samples = 2 (Minimum of 2 queries to create a group);
# metric="cosine" (We explicitly specify that we measure angles between vectors, not linear distance).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Run the grouping
labels = dbscan.fit_predict(embeddings)

# ==========================================
# OUTPUT RESULTS
# ==========================================
# The algorithm assigned each query a group number (0, 1, 2...).
# If a query is recognized as noise (Outlier), it receives the label -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== GROUPING RESULTS ===")
for cluster_id, docs in clusters.items():
    print(f"\n Cluster #{cluster_id} (Queries: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Outliers/Noise (Queries: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Connecting to the vector database...")
client = chromadb.PersistentClient(path="./semantic_db")

# Extract the collection with the vectors (use your own name)
collection = client.get_collection(name="search_queries")

# Extract all query texts and their mathematical vectors
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Queries extracted from the database: {len(documents)}")

# ==========================================
# CLUSTERING (DBSCAN)
# ==========================================
print("⏳ 2. Starting the DBSCAN algorithm...")

# SETTINGS:
# eps = 0.15 (Allowed cosine distance. The smaller it is, the stricter the clusters);
# min_samples = 2 (Minimum of 2 queries to create a group);
# metric="cosine" (We explicitly specify that we measure angles between vectors, not linear distance).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Run the grouping
labels = dbscan.fit_predict(embeddings)

# ==========================================
# OUTPUT RESULTS
# ==========================================
# The algorithm assigned each query a group number (0, 1, 2...).
# If a query is recognized as noise (Outlier), it receives the label -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== GROUPING RESULTS ===")
for cluster_id, docs in clusters.items():
    print(f"\n Cluster #{cluster_id} (Queries: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Outliers/Noise (Queries: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
上面的示例使用了本地模型,但在使用商业嵌入模型时,eps 值可能需要额外的微调。特别是,适用于一种模型的 0.15 阈值,在另一种配置下可能会导致大部分查询合并为一个大型聚类,或者被错误地归类为噪声。
因此,每当您切换模型时,您都应该根据向量之间的距离分布和所得分组的实际质量来单独调整 eps。
用于分离搜索意图的混合聚类
聚类可以仅通过嵌入向量来完成,但在实践中这往往是不够的。语义相似性并不总是意味着搜索意图是相同的。
例如,“购买反检测浏览器”和“什么是反检测浏览器”这两个查询在主题上非常接近。嵌入模型正确地识别出这两个短语都指代同一个对象,因此它们的向量之间的距离会很小。结果,DBSCAN 极有可能将这些查询放入同一个聚类中。
从 SEO 的角度来看,这是不可取的,因为意图不同。第一个暗示的是商业着陆页,而第二个暗示的是信息性内容。
让我们用一个小的测试数据集来演示这一点:
queries = [
    # Informational
    "what are antidetect browsers for",
    "what is an antidetect browser",
    "how antidetect browsers work",
    "antidetect browsers comparison",

    # Commercial
    "buy an anti-detect browser",
    "buy proxies for an anti-detect browser",
    "anti-detect browser trial",

    # Download
    "download anti-detect browser octo browser",
    "octo browser anti-detect browser download",
    "octo anti-detect browser download",

    # Queries on a different topic
    "ford everest 2024 review",
    "buy used ford everest",

    # Noise
    "weather in pattaya in May",
    "tom yum soup recipe"
]
queries = [
    # Informational
    "what are antidetect browsers for",
    "what is an antidetect browser",
    "how antidetect browsers work",
    "antidetect browsers comparison",

    # Commercial
    "buy an anti-detect browser",
    "buy proxies for an anti-detect browser",
    "anti-detect browser trial",

    # Download
    "download anti-detect browser octo browser",
    "octo browser anti-detect browser download",
    "octo anti-detect browser download",

    # Queries on a different topic
    "ford everest 2024 review",
    "buy used ford everest",

    # Noise
    "weather in pattaya in May",
    "tom yum soup recipe"
]
当仅通过向量相似性进行聚类时,与反检测浏览器相关的查询尽管在意图上存在差异,但最终可能会归入同一个组。
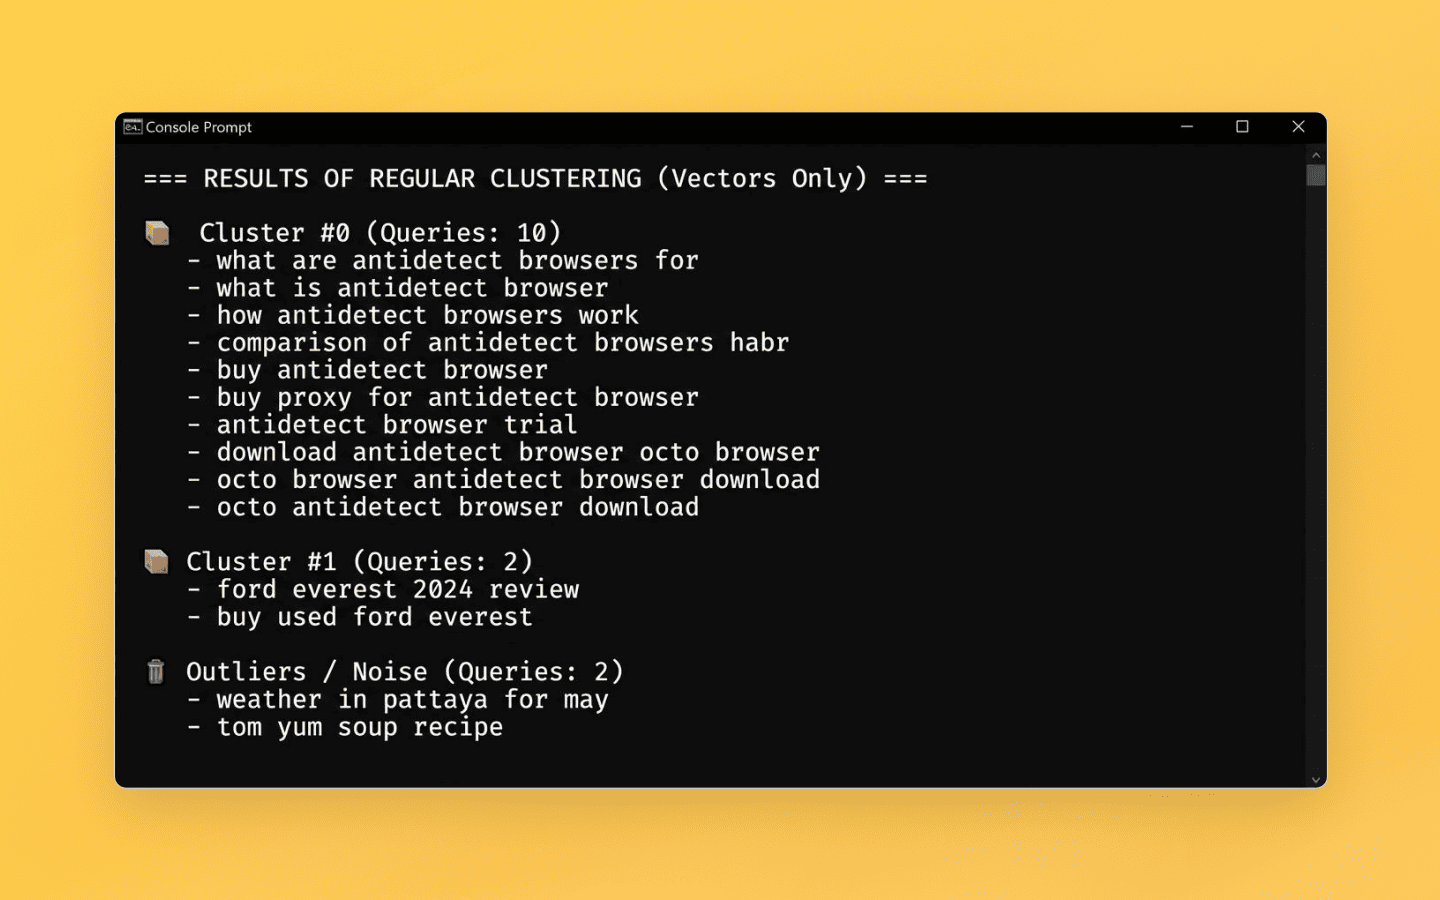
在此阶段,反检测浏览器再次成为管道的一部分,但不是为了收集语义数据。相反,它被用来收集 SERP(搜索引擎结果页面)数据。对于每个查询,您需要收集搜索结果,然后将 URL 重叠作为额外的聚类信号。
对于大量的查询,可以方便地将这种收集分布在隔离的浏览器配置文件中,例如通过结合使用 Octo Browser 与 Playwright 或 Puppeteer。

对于每个查询,从搜索结果中收集前 10 个 URL。然后,在运行 DBSCAN 之前,比较语义相似短语的结果。如果两个查询没有共同的 URL,或者它们的数量低于定义的阈值,则相应向量之间的距离会被人工拉大。
因此,嵌入用于寻找语义相似的查询,而 SERP 分析则作为附加约束,并有助于防止具有不同搜索意图的短语被合并。
添加搜索结果数据后,本文前面讨论的测试数据集的分布方式有所不同:
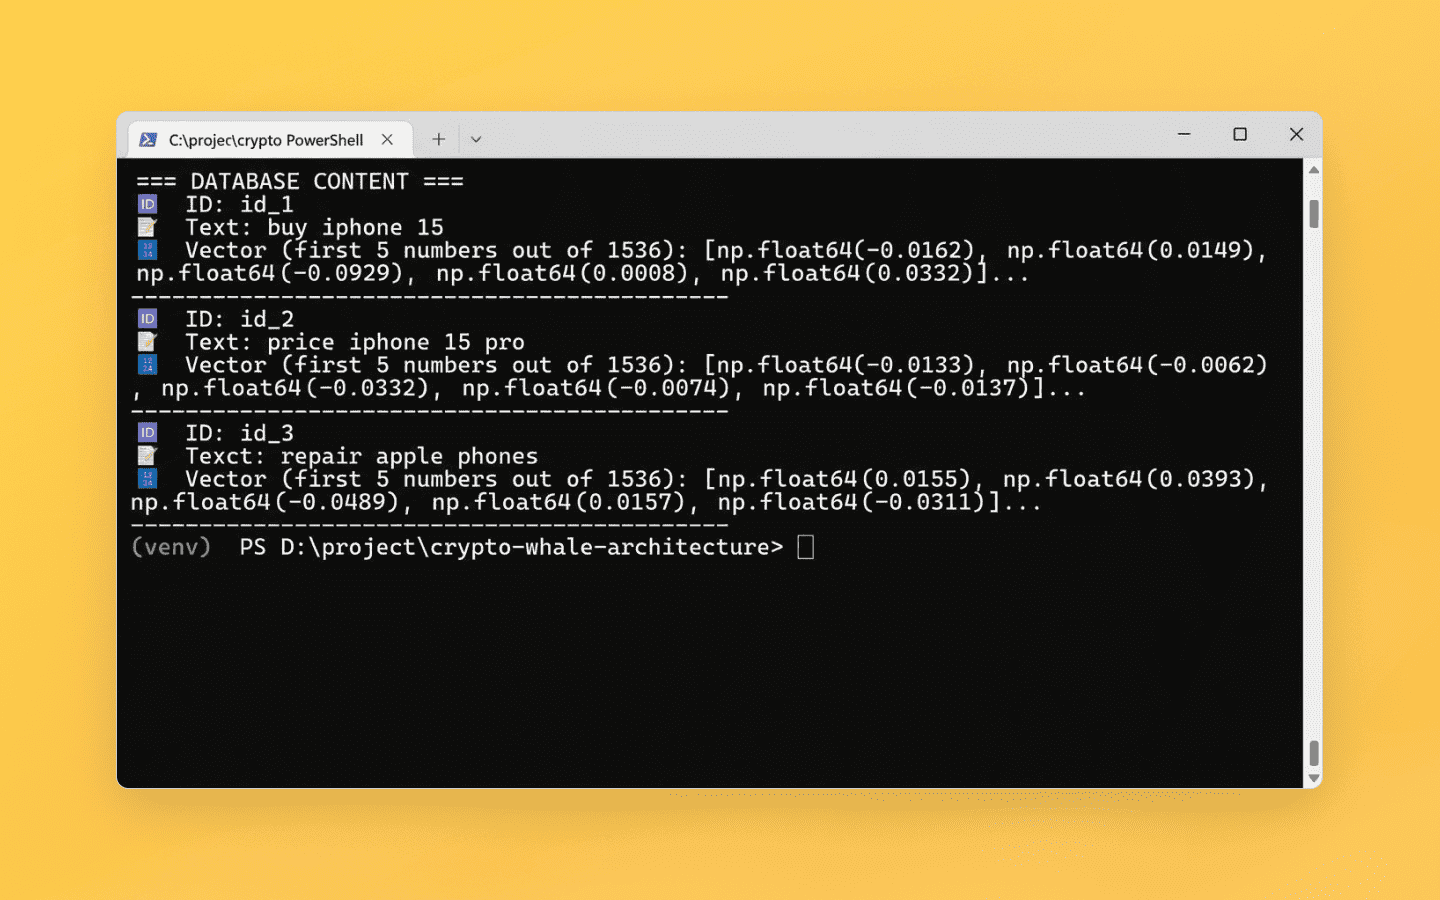
聚类的数量增加,并且这些组本身更好地匹配了查询预期的搜索意图。
后期处理结果并更新数据
形成聚类后,还有一个实际任务——为每个组分配一个清晰的名称。像“Cluster #42”这样的数字对算法来说很方便,但对 SEO 专家、编辑或内容撰写人员却说明不了什么。
使用 LLM 自动命名聚类
手动操作时,专家必须审查每个组的内容,确定主要意图,并为未来的页面或内容想一个名称。如果有几百个聚类,这个阶段会耗费大量的时间。
然而,这部分过程可以使用 LLM 来自动完成。该模型接收来自一个聚类的查询列表,确定整体意图,并生成一个合适的标题。您可以使用基于云的模型,也可以使用本地解决方案(例如 Ollama)。
提前定义严格的输出格式非常重要。如果您只是要求模型想出一个名称,您可能会在标题之外得到额外的解释和评论。这就是为什么最好在系统提示词中明确指出,输出应仅包含标题,不能有任何多余的文本:
from openai import OpenAI

# 1. INITIALIZATION AND KEY
# Insert your actual API key here
client_ai = OpenAI(api_key="sk-YOUR_OPENAI_KEY")

# 2. OUR DATA (Result of hybrid clustering)
clusters = {
    0: [
       "what are anti-detect browsers for",
       "what is an anti-detect browser",
       "how anti-detect browsers work",
       "anti-detect browsers comparison",
    ],
    1: [
        "buy an anti-detect browser",
        "buy proxies for an anti-detect browser",
        "anti-detect browser trial"
    ],
    2: [
        "download anti-detect browser octo browser",
        "octo browser anti-detect browser download",
        "octo anti-detect browser download"
    ]
}

# System prompt (set rules for the model)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Sending clusters to GPT-4o-mini for automatic naming...\n")

# 3. Iterate through all clusters
for cluster_id, queries in clusters.items():
    # Send the queries from the current cluster to the API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Combine the queries into a single text
        ],
        temperature=0.3
    )

    # Get the response
    h1_title = response.choices[0].message.content

    # Print the result to the console
    print(f"Cluster #{cluster_id}")
    print(f"Phrases: {', '.join(queries)}")
    print(f"Generated H1: {h1_title}\n")
from openai import OpenAI

# 1. INITIALIZATION AND KEY
# Insert your actual API key here
client_ai = OpenAI(api_key="sk-YOUR_OPENAI_KEY")

# 2. OUR DATA (Result of hybrid clustering)
clusters = {
    0: [
       "what are anti-detect browsers for",
       "what is an anti-detect browser",
       "how anti-detect browsers work",
       "anti-detect browsers comparison",
    ],
    1: [
        "buy an anti-detect browser",
        "buy proxies for an anti-detect browser",
        "anti-detect browser trial"
    ],
    2: [
        "download anti-detect browser octo browser",
        "octo browser anti-detect browser download",
        "octo anti-detect browser download"
    ]
}

# System prompt (set rules for the model)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Sending clusters to GPT-4o-mini for automatic naming...\n")

# 3. Iterate through all clusters
for cluster_id, queries in clusters.items():
    # Send the queries from the current cluster to the API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Combine the queries into a single text
        ],
        temperature=0.3
    )

    # Get the response
    h1_title = response.choices[0].message.content

    # Print the result to the console
    print(f"Cluster #{cluster_id}")
    print(f"Phrases: {', '.join(queries)}")
    print(f"Generated H1: {h1_title}\n")
对于测试数据集,结果可能看起来像这样:
Cluster #0
   Phrases: what are anti-detect browsers for, what is an anti-detect browser, how anti-detect browsers work
   Generated H1: What are anti-detect browsers used for

Cluster #1
   Phrases: buy an anti-detect browser, buy proxies for an anti-detect browser, anti-detect browser trial
   Generated H1: Best anti-detect browsers and proxies for safe browsing

Cluster #2
   Phrases: download anti-detect browser octo browser, octo browser anti-detect browser download, octo anti-detect browser download
   Generated H1: Download anti-detect browser Octo Browser
Cluster #0
   Phrases: what are anti-detect browsers for, what is an anti-detect browser, how anti-detect browsers work
   Generated H1: What are anti-detect browsers used for

Cluster #1
   Phrases: buy an anti-detect browser, buy proxies for an anti-detect browser, anti-detect browser trial
   Generated H1: Best anti-detect browsers and proxies for safe browsing

Cluster #2
   Phrases: download anti-detect browser octo browser, octo browser anti-detect browser download, octo anti-detect browser download
   Generated H1: Download anti-detect browser Octo Browser
在实际项目中,聚类的数量会大得多,因此直接在代码中存储源数据是不切实际的。通常,聚类是从文件或数据库加载的,而生成的名称则写回表中以供进一步工作使用。
在这一阶段,LLM 本身不参与聚类;它仅用于对已形成的分组进行后期处理。这使日常的常规工作自动化,并在无需手动命名每个聚类的情况下为您提供清晰的语义核心结构。
添加新查询
在 ChromaDB 中存储嵌入的另一个优势是能够处理新数据,而无需再次手动在整个数据集中进行最近邻搜索。
在获得一批新的语义数据后,查询会通过相同的管道:清洗、向量化并将其添加到 ChromaDB。对于每个新嵌入,您可以找到最近的现有查询并评估与它们的距离。
如果最近的邻居属于一个稳定的现有聚类并符合定义的相似度阈值,则可以将新查询添加到该组中。如果没有合适的聚类,该查询将保持作为形成新组的候选对象,或者被发送去进行额外处理。
这种方法允许您将积累的向量数据库用作处理新查询的索引,并避免每次更新语义核心时在整个语义核心中进行完整的成对搜索。
结论
构建基于嵌入模型、向量存储和聚类算法的自有管道需要时间,因为您需要对其进行配置、测试和调整。然而,一旦完成,您就会得到一个可以适应特定主题、数据量和项目要求的系统。
这种方法的主要优势在于:
减少对专业服务的依赖。 您不需要具有固定计划和聚类数量限制的独立 SEO 服务。主要的限制转移到了您自己的基础设施上:计算资源、内存和磁盘空间。
对聚类逻辑的控制。 您可以自己选择嵌入模型、配置
eps、使用 SERP 数据并根据任务更改合并查询的规则。对数据的控制。 当使用本地模型和本地存储时,语义数据将保留在您自己的基础设施内,不会发送给第三方 API。
这种方法的主要价值不在于完全取代现成的 SEO 工具,而在于能够构建您自己可控的管道。使用 Octo Browser 自动抓取语义和 SERP 数据,并在本地利用嵌入、ChromaDB 和聚类算法执行其余的处理。
一旦您构建了此流程并使用真实数据对其进行仔细微调,它就不仅仅是一个一次性脚本。它将变成一个随语义核心增长而可重复使用和扩展的实用工具。
使用Octo Browser维护您的在线匿名性。您真实的数字指纹无法被追踪。
您想以折扣价体验 Octo Browser 吗?
使用优惠码 OCTOBLOG 即可享受任何订阅的 30% 优惠。此优惠仅对新用户有效。
收集语义数据
收集语义数据有几种方法,但基本流程通常是围绕相同的模式构建的:首先,使用 Google Ads 关键字规划师等服务以及其他提供相关主题搜索量数据的工具来创建初始查询池。
然后,利用相关查询、搜索建议和其他语义来源扩展初始集。过去,Key Collector 经常被用于类似的任务,但今天,通常需要结合使用几种工具或使用自定义脚本来收集必要的数据。
使用自动化工具收集语义数据
如果商业解决方案不符合您的预算、功能要求或限制,您可以自己将部分语义收集流程自动化。例如,要从 Web 界面检索搜索建议和其他数据,您可以使用基于 Puppeteer 或 Playwright 的无头浏览器。
如果您在大量的并行会话中收集语义数据,则需要安全地管理浏览器配置文件及其环境。在这里,您可以使用反检测浏览器(如 Octo Browser)来隔离会话、管理配置文件设置并连接不同的代理。这简化了抓取基础设施,并减少了每个单独浏览器实例所需的手动配置量。
大规模收集数据时的主要挑战是搜索引擎施加的限制。自动请求可能会触发频率限制、CAPTCHA 或其他保护机制,因此在设计此类管道时,您需要考虑会话稳定性、请求频率和临时封锁。
在使用浏览器自动化时,控制环境参数(如 User-Agent、窗口大小、语言环境、WebGL 以及其他浏览器会话特征)也同样重要。您可以使用自己的 Puppeteer 或 Playwright 配置或专业的浏览器解决方案来做到这一点,这些解决方案允许您创建具有不同环境参数的隔离配置文件。
另一个单独的任务是组织网络基础设施。您可以使用不同类型的代理进行分布式数据收集:数据中心代理、住宅代理或移动代理。选择取决于请求量以及对稳定性、速度和成本的要求。数据中心代理通常更便宜、更快,但在某些情况下,它们更有可能受到限制。住宅和移动地址通常更具弹性,但成本较高且吞吐量较低。
一旦主要数据收集完成,您就可以用来自外部语义数据库的数据来补充最终的查询列表。结果应该是尽可能完整的查询集,然后可以将其传递给清洗、规范化和进一步的聚类阶段。
在向量化之前清洗数据
收集完语义数据后,您将获得一个包含数万个搜索查询的文件。乍一看,它似乎已经可以进行向量化和聚类了,但结果的质量在很大程度上取决于数据预先准备得如何。
在此阶段,Pandas 和 NumPy 库对于清洗和规范化输入数据集非常方便。原始查询列表几乎总是包含重复项、无用字符、技术杂乱、无关短语以及在解析和合并多个数据源期间引入的其他人工痕迹。
嵌入模型无论如何都会将这些字符串转换为向量,但这会产生不必要的计算开销,并可能会降低所得聚类的结构。这就是为什么最好在向量化之前将数据整理成一致且可预测的格式。
主要的准备阶段如下:
删除技术杂乱。 删除 HTML 标签、多余空格、不可见字符、表情符号以及在抓取过程中可能进入数据的其他元素。
全局去重。 当合并来自多个来源的查询时,重叠几乎是不可避免的。多次向量化相同的字符串是没有意义的,因此应提前删除完全重复的项。
停用词过滤。 在此阶段,您可以排除包含无关地名、不需要的标记或不符合项目要求的单词的查询。例如,商业语义数据可能会排除包含“免费”、“种子”等修饰词的查询。
将单词还原为词典形式(词形还原)是可选的。 现代模型能很好地理解相同单词的不同形式和等效短语。例如,它们可以识别出“购买 iPhone”和“我想买一部 iPhone”几乎是相同的查询。因此,没有必要在处理前刻意改变单词。然而,简单的预处理可以帮助识别相似的查询并减少数据量。
结果应该是一个干净且经过过滤的唯一查询集,没有明显的技术噪点。然后,数据可以被传递到下一个阶段——将文本转换为向量表示。
向量化搜索查询
向量聚类不同于传统的字符串比较,因为它不处理精确的单词匹配,而是处理它们的语义表示。每个搜索查询都被转换为一个数值向量(即嵌入),该向量对它的语义特征进行编码。
为此需要使用专门的嵌入模型。首先将文本分割成标记,然后模型生成一个固定维度的向量。因此,语义相似的查询在向量空间中彼此靠得更近。
例如,相比“购买 iPhone 15”和“苹果手机维修”,“购买 iPhone 15”和“iPhone 15 Pro 价格”这两个短语将具有更相似的向量。这一特性使得使用聚类算法对查询进行分组成为可能。
商业解决方案 (OpenAI, Claude)
对于向量化,您既可以使用云端 API,也可以使用本地模型。选择取决于数据量、质量要求、可用基础设施以及可接受的处理成本。
商业 API 很方便,因为它们不需要本地模型部署,并且可以让您快速上手。提供商负责基础设施、模型更新和计算扩展。
对于中小型数据集,这是最简单的解决方案之一。然而,当处理数十万或数百万个查询时,您需要考虑 API 成本、请求限制和吞吐量。
此外,使用 API 需要容错架构(通过多账号、密钥轮换以及通过 aiohttp 进行异步请求来绕过 API 限制)。
您可以使用以下代码自己测试商业神经网络如何处理您的查询:
import os
from openai import OpenAI

# Initialize the client
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Our raw dataset
queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

# 1. Vectorize queries through OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# The result is a set of ready-made multidimensional vectors
embeddings = [data.embedding for data in response.data]
来自 Hugging Face 生态系统的本地模型
商业 API 的替代方案是本地运行的开源嵌入模型。例如,对于多语言任务,您可以使用 jinaai/jina-embeddings-v3 或 Alibaba-NLP/gte-multilingual-large,这些模型不会产生单次生成费用。
from sentence_transformers import SentenceTransformer

print("⏳ 1. Loading stable BGE-m3 model...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["buy iphone 15", "iphone 15 pro price", "apple phone repair"]

print(f"⏳ 2. Vectorizing {len(queries)} queries...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Done! Let's look at the result:")
print(f"📊 Data dimensions: {embeddings.shape}")
print("🔍 Vector for the phrase 'buy iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... and {len(embeddings[0]) - 5} more numbers.")
本地模型的主要优势在于整个处理管道都保留在您自己的基础设施内。您在处理搜索查询时无需将其发送给第三方 API,并且一旦加载了模型,您就可以对其进行向量化,而无需为每个单独的请求付费。
使用本地模型通常更具成本效益:它们让您无需为每次 API 调用付费即可进行向量化。同时,它们需要大量的磁盘空间:连同模型权重和缓存,它们可能会占用几个吉字节。如果您不再需要某个模型,最好在结束工作后删除其本地文件并清除缓存。
存储并搜索向量表示
向量化之后,每个搜索查询都被表示为一个嵌入向量。接下来的问题是在哪里存储这些数据以及如何高效地找到语义相似的查询。
对于小型数据集,向量可以保留在内存中,例如在 NumPy 数组或 Pandas 结构中。如果只有几千个查询,这通常足够用于实验和本地处理。
随着数据集的增长,情况发生了变化。如果将每个向量直接与所有其他向量进行比较,操作次数将呈二次方增长。对于数十万或数百万个查询,这在计算时间和内存使用方面都会迅速变得消耗资源。
这个问题可以通过向量数据库来解决。它们专门针对此类任务进行了优化,并支持近似最近邻搜索算法(特别是 HNSW)。内置索引使得避免直接比较每个向量与每个其他向量成为可能,并且即使在数百万条记录中也能几乎瞬间搜索到最相似的短语。
对于这些任务,有几种流行的解决方案:Pinecone、Qdrant、带有 pgvector 扩展的 PostgreSQL 等。在我们的示例中,我们将使用 ChromaDB。它非常适合本地实验:无需单独服务器即可运行,将数据存储在磁盘上,并且易于与 Python 代码集成。
让我们保存上一步获得的嵌入,并检查语义搜索是如何工作的:
import chromadb

# 1. Initialize the local database (creates the semantic_db folder)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Create the collection
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Load our vectors and query texts
collection.add(
    embeddings=embeddings.tolist(), # vectors from our local BGE-m3 model
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Data saved to the database!\n")

# ==========================================
# SEARCH MAGIC: let's check how the database understands meaning
# ==========================================
test_phrase = "how much does the new iphone cost"
print(f"Searching the database for the phrase: '{test_phrase}'")

# Convert the test phrase into a vector using the same model
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Ask the database to find the two most similar options
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Closest query: {results['documents'][0][0]} (Distance: {results['distances'][0][0]:.4f})")
print(f"Second closest: {results['documents'][0][1]} (Distance: {results['distances'][0][1]:.4f})")
选择聚类算法
一旦获得了嵌入向量,就可以进入下一个阶段——对搜索查询进行分组。在这一阶段,重要的是选择一种与数据结构相匹配的算法,并且不需要对未来的聚类数量做出过于生硬的假设。
为什么 K-Means 并不总是适用于 SEO 聚类
K-Means 是一种经典的聚类算法,它将数据划分为预先定义好数量的组。聚类的数量是通过 k 参数指定的。
例如,如果我们有 10,000 个搜索查询并指定 k=500,该算法将创建 500 个质心,并将每个查询分配给向量空间中最近的一个。
这种方法的主要局限性在于必须提前确定聚类的数量。对于语义核心来说,这并不总是方便的:在处理开始之前,很难知道数据集包含多少个独立的意图组——是 50、500 还是 1,200 个。
如果 k 选择不当,相关的查询可能会被拆分到几个组中。相反的情况也可能发生:主题相近但意图不同的查询可能会被合并,这仅仅是因为算法必须创建指定数量的聚类。
使用 DBSCAN 进行聚类
如果无法提前知道组的数量,您可以使用基于密度的聚类算法。其中最著名的解决方案之一是 DBSCAN(基于密度的空间聚类应用噪声)。
与 K-Means 不同,DBSCAN 不需要您预先指定聚类的数量。该算法在向量空间中寻找对象足够接近的区域并从中形成组。
DBSCAN 的行为由两个主要参数决定:
eps(epsilon/距离):点之间被视为邻居的最大距离。在我们的案例中,这是向量的余弦相似度阈值。min_samples:形成一个完整聚类所需的最小邻居数。
DBSCAN 获取第一个随机查询。如果在其 eps 半径内有 min_samples 个其他查询,则形成一个聚类核心。然后算法向所有方向扩展,添加新的邻居,直到密度耗尽。
eps 参数可以粗略地比作聚类的严格程度:
较小的
eps对应于更严格的分组。只有具有非常相似的向量表示的查询才会最终归入同一个聚类中,因此您通常会获得更多的组,并且它们会更加紧凑。较大的
eps使得合并条件更宽松。聚类变得更大,并且可能包括更广泛的语义,但合并具有不同意图的查询的风险也会增加。
DBSCAN 的另一个有用特性是它能够识别噪声。如果查询不位于向量空间中足够密集的区域,该算法不会试图将其强行塞入现有的聚类之一。相反,它会将该查询标记为离群值 (Outlier)。您可以将这些查询导出到单独的文件中进行人工审核,而不是影响原本干净的着陆页。
同时,DBSCAN 对 eps 的选择很敏感:单一阈值在某些组非常密集而其他组要稀疏得多的数据中并不总是能很好地工作。
在这些情况下,请考虑 HDBSCAN,这是基于密度方法的层次扩展。它可以找到具有不同密度的聚类,并在查询排列得更紧密或相反更分散的地方自动适应 eps 参数。
聚类脚本
让我们从本地 ChromaDB 数据库中提取我们的向量,并通过使用 scikit-learn 库的 DBSCAN 运行它们:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Connecting to the vector database...")
client = chromadb.PersistentClient(path="./semantic_db")

# Extract the collection with the vectors (use your own name)
collection = client.get_collection(name="search_queries")

# Extract all query texts and their mathematical vectors
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Queries extracted from the database: {len(documents)}")

# ==========================================
# CLUSTERING (DBSCAN)
# ==========================================
print("⏳ 2. Starting the DBSCAN algorithm...")

# SETTINGS:
# eps = 0.15 (Allowed cosine distance. The smaller it is, the stricter the clusters);
# min_samples = 2 (Minimum of 2 queries to create a group);
# metric="cosine" (We explicitly specify that we measure angles between vectors, not linear distance).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Run the grouping
labels = dbscan.fit_predict(embeddings)

# ==========================================
# OUTPUT RESULTS
# ==========================================
# The algorithm assigned each query a group number (0, 1, 2...).
# If a query is recognized as noise (Outlier), it receives the label -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== GROUPING RESULTS ===")
for cluster_id, docs in clusters.items():
    print(f"\n Cluster #{cluster_id} (Queries: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Outliers/Noise (Queries: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
上面的示例使用了本地模型,但在使用商业嵌入模型时,eps 值可能需要额外的微调。特别是,适用于一种模型的 0.15 阈值,在另一种配置下可能会导致大部分查询合并为一个大型聚类,或者被错误地归类为噪声。
因此,每当您切换模型时,您都应该根据向量之间的距离分布和所得分组的实际质量来单独调整 eps。
用于分离搜索意图的混合聚类
聚类可以仅通过嵌入向量来完成,但在实践中这往往是不够的。语义相似性并不总是意味着搜索意图是相同的。
例如,“购买反检测浏览器”和“什么是反检测浏览器”这两个查询在主题上非常接近。嵌入模型正确地识别出这两个短语都指代同一个对象,因此它们的向量之间的距离会很小。结果,DBSCAN 极有可能将这些查询放入同一个聚类中。
从 SEO 的角度来看,这是不可取的,因为意图不同。第一个暗示的是商业着陆页,而第二个暗示的是信息性内容。
让我们用一个小的测试数据集来演示这一点:
queries = [
    # Informational
    "what are antidetect browsers for",
    "what is an antidetect browser",
    "how antidetect browsers work",
    "antidetect browsers comparison",

    # Commercial
    "buy an anti-detect browser",
    "buy proxies for an anti-detect browser",
    "anti-detect browser trial",

    # Download
    "download anti-detect browser octo browser",
    "octo browser anti-detect browser download",
    "octo anti-detect browser download",

    # Queries on a different topic
    "ford everest 2024 review",
    "buy used ford everest",

    # Noise
    "weather in pattaya in May",
    "tom yum soup recipe"
]
当仅通过向量相似性进行聚类时,与反检测浏览器相关的查询尽管在意图上存在差异,但最终可能会归入同一个组。
在此阶段,反检测浏览器再次成为管道的一部分,但不是为了收集语义数据。相反,它被用来收集 SERP(搜索引擎结果页面)数据。对于每个查询,您需要收集搜索结果,然后将 URL 重叠作为额外的聚类信号。
对于大量的查询,可以方便地将这种收集分布在隔离的浏览器配置文件中,例如通过结合使用 Octo Browser 与 Playwright 或 Puppeteer。
对于每个查询,从搜索结果中收集前 10 个 URL。然后,在运行 DBSCAN 之前,比较语义相似短语的结果。如果两个查询没有共同的 URL,或者它们的数量低于定义的阈值,则相应向量之间的距离会被人工拉大。
因此,嵌入用于寻找语义相似的查询,而 SERP 分析则作为附加约束,并有助于防止具有不同搜索意图的短语被合并。
添加搜索结果数据后,本文前面讨论的测试数据集的分布方式有所不同:
聚类的数量增加,并且这些组本身更好地匹配了查询预期的搜索意图。
后期处理结果并更新数据
形成聚类后,还有一个实际任务——为每个组分配一个清晰的名称。像“Cluster #42”这样的数字对算法来说很方便,但对 SEO 专家、编辑或内容撰写人员却说明不了什么。
使用 LLM 自动命名聚类
手动操作时,专家必须审查每个组的内容,确定主要意图,并为未来的页面或内容想一个名称。如果有几百个聚类,这个阶段会耗费大量的时间。
然而,这部分过程可以使用 LLM 来自动完成。该模型接收来自一个聚类的查询列表,确定整体意图,并生成一个合适的标题。您可以使用基于云的模型,也可以使用本地解决方案(例如 Ollama)。
提前定义严格的输出格式非常重要。如果您只是要求模型想出一个名称,您可能会在标题之外得到额外的解释和评论。这就是为什么最好在系统提示词中明确指出,输出应仅包含标题,不能有任何多余的文本:
from openai import OpenAI

# 1. INITIALIZATION AND KEY
# Insert your actual API key here
client_ai = OpenAI(api_key="sk-YOUR_OPENAI_KEY")

# 2. OUR DATA (Result of hybrid clustering)
clusters = {
    0: [
       "what are anti-detect browsers for",
       "what is an anti-detect browser",
       "how anti-detect browsers work",
       "anti-detect browsers comparison",
    ],
    1: [
        "buy an anti-detect browser",
        "buy proxies for an anti-detect browser",
        "anti-detect browser trial"
    ],
    2: [
        "download anti-detect browser octo browser",
        "octo browser anti-detect browser download",
        "octo anti-detect browser download"
    ]
}

# System prompt (set rules for the model)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Sending clusters to GPT-4o-mini for automatic naming...\n")

# 3. Iterate through all clusters
for cluster_id, queries in clusters.items():
    # Send the queries from the current cluster to the API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Combine the queries into a single text
        ],
        temperature=0.3
    )

    # Get the response
    h1_title = response.choices[0].message.content

    # Print the result to the console
    print(f"Cluster #{cluster_id}")
    print(f"Phrases: {', '.join(queries)}")
    print(f"Generated H1: {h1_title}\n")
对于测试数据集,结果可能看起来像这样:
Cluster #0
   Phrases: what are anti-detect browsers for, what is an anti-detect browser, how anti-detect browsers work
   Generated H1: What are anti-detect browsers used for

Cluster #1
   Phrases: buy an anti-detect browser, buy proxies for an anti-detect browser, anti-detect browser trial
   Generated H1: Best anti-detect browsers and proxies for safe browsing

Cluster #2
   Phrases: download anti-detect browser octo browser, octo browser anti-detect browser download, octo anti-detect browser download
   Generated H1: Download anti-detect browser Octo Browser
在实际项目中,聚类的数量会大得多,因此直接在代码中存储源数据是不切实际的。通常,聚类是从文件或数据库加载的,而生成的名称则写回表中以供进一步工作使用。
在这一阶段,LLM 本身不参与聚类;它仅用于对已形成的分组进行后期处理。这使日常的常规工作自动化,并在无需手动命名每个聚类的情况下为您提供清晰的语义核心结构。
添加新查询
在 ChromaDB 中存储嵌入的另一个优势是能够处理新数据,而无需再次手动在整个数据集中进行最近邻搜索。
在获得一批新的语义数据后,查询会通过相同的管道:清洗、向量化并将其添加到 ChromaDB。对于每个新嵌入,您可以找到最近的现有查询并评估与它们的距离。
如果最近的邻居属于一个稳定的现有聚类并符合定义的相似度阈值,则可以将新查询添加到该组中。如果没有合适的聚类,该查询将保持作为形成新组的候选对象,或者被发送去进行额外处理。
这种方法允许您将积累的向量数据库用作处理新查询的索引,并避免每次更新语义核心时在整个语义核心中进行完整的成对搜索。
结论
构建基于嵌入模型、向量存储和聚类算法的自有管道需要时间,因为您需要对其进行配置、测试和调整。然而,一旦完成,您就会得到一个可以适应特定主题、数据量和项目要求的系统。
这种方法的主要优势在于:
减少对专业服务的依赖。 您不需要具有固定计划和聚类数量限制的独立 SEO 服务。主要的限制转移到了您自己的基础设施上:计算资源、内存和磁盘空间。
对聚类逻辑的控制。 您可以自己选择嵌入模型、配置
eps、使用 SERP 数据并根据任务更改合并查询的规则。对数据的控制。 当使用本地模型和本地存储时,语义数据将保留在您自己的基础设施内,不会发送给第三方 API。
这种方法的主要价值不在于完全取代现成的 SEO 工具,而在于能够构建您自己可控的管道。使用 Octo Browser 自动抓取语义和 SERP 数据,并在本地利用嵌入、ChromaDB 和聚类算法执行其余的处理。
一旦您构建了此流程并使用真实数据对其进行仔细微调,它就不仅仅是一个一次性脚本。它将变成一个随语义核心增长而可重复使用和扩展的实用工具。
随时获取最新的Octo Browser新闻
通过点击按钮,您同意我们的 隐私政策。
随时获取最新的Octo Browser新闻
通过点击按钮,您同意我们的 隐私政策。
随时获取最新的Octo Browser新闻
通过点击按钮,您同意我们的 隐私政策。