Clustering vectorial de consultas de búsqueda: crea tu propio sistema con ChromaDB, embeddings y Python


Markus_automation
Expert in data parsing and automation
El clustering es una de las etapas que más tiempo requieren al trabajar con datos semánticos. Recopilar y limpiar un conjunto de consultas es relativamente sencillo, pero distribuir correctamente miles de keywords en clústeres (grupos) con la misma intención de búsqueda (search intent) es mucho más difícil.
Las herramientas de clustering, como Rush Analytics, Key.so y Key Collector, simplifican la tarea, pero tienen limitaciones en cuanto al volumen, la configuración y la calidad de los resultados. Esto se nota especialmente en nichos complejos, donde los algoritmos automáticos pueden combinar consultas con diferentes intenciones o separar frases muy cercanas en significado.
El enfoque basado en redes neuronales permite resolver esta tarea de otra manera. En lugar de comparar palabras individuales y coincidencias léxicas, las consultas se convierten en vectores multidimensionales (embeddings). Estos pueden compararse por similitud semántica y utilizarse para formar clústeres automáticamente.
En este artículo veremos cómo crear tu propio pipeline escalable de clustering en un ordenador o servidor local, desde la recopilación automatizada de datos semánticos y SERP con un navegador antidetección hasta la vectorización, agrupación y postprocesamiento de los resultados.
Contenidos
Mantén tu anonimato en línea con Octo Browser. Tu huella digital real no se puede rastrear.
¿Te gustaría probar Octo Browser con descuento?
Usa el código promocional OCTOBLOG para obtener un 30% de descuento en cualquier suscripción. Esta oferta es válida solo para nuevos usuarios.
Recopilación de datos semánticos
Existen varios enfoques para recopilar datos semánticos, pero el proceso básico suele seguir el mismo esquema: primero se crea un conjunto inicial de consultas mediante servicios como Google Ads Keyword Planner y otras herramientas que proporcionan datos sobre el volumen de búsquedas del tema correspondiente.
Después, el conjunto inicial se amplía con consultas relacionadas, sugerencias de búsqueda y otras fuentes de datos semánticos. Anteriormente, Key Collector se utilizaba con frecuencia para este tipo de tareas, pero hoy en día a menudo es necesario combinar varias herramientas o utilizar scripts propios para recopilar los datos.
Uso de herramientas de automatización para recopilar datos semánticos
Si las soluciones comerciales no se ajustan a tu presupuesto, necesidades funcionales o limitaciones, puedes automatizar por tu cuenta parte del proceso de recopilación semántica. Por ejemplo, para obtener sugerencias de búsqueda y otros datos de interfaces web, puedes utilizar navegadores headless basados en Puppeteer o Playwright.
Si recopilas datos semánticos en un gran número de sesiones paralelas, necesitas gestionar de forma segura los perfiles del navegador y sus entornos. Para eso puedes utilizar un navegador antidetección como Octo Browser para aislar sesiones, gestionar los parámetros de los perfiles y conectar diferentes tipos de proxies. Esto simplifica la infraestructura de scraping y reduce la cantidad de configuración manual necesaria para cada instancia independiente del navegador.
La principal dificultad al recopilar datos a gran escala son las restricciones de los motores de búsqueda. Las solicitudes automatizadas pueden activar rate limits, CAPTCHAs, u otros mecanismos de protección, por lo que al diseñar este tipo de pipeline debes tener en cuenta la estabilidad de las sesiones, la frecuencia de las solicitudes y la gestión de bloqueos temporales.
Al trabajar con automatización del navegador, también es importante controlar parámetros del entorno como el User-Agent, el tamaño de la ventana, la configuración regional, WebGL y otras características de la sesión del navegador. Puedes hacerlo con tu propia configuración de Puppeteer o Playwright, o utilizar soluciones de navegador especializadas que permiten crear perfiles aislados con diferentes parámetros del entorno.
Otra tarea independiente es organizar la infraestructura de red. Para la recopilación de datos distribuida pueden utilizarse proxies de diferentes tipos: de centros de datos, residenciales o móviles. La elección depende del volumen de solicitudes y de los requisitos de estabilidad, velocidad y coste. Los proxies de centros de datos suelen ser más baratos y rápidos, pero en algunos escenarios están sujetos a restricciones con mayor frecuencia. Las direcciones residenciales y móviles suelen ser más resistentes, pero son más caras y tienen un menor ancho de banda.
Una vez finalizada la recopilación principal, puedes complementar la lista final de consultas con datos procedentes de bases semánticas externas. El resultado debe ser el conjunto de consultas más completo posible, que después puede pasar a las etapas de limpieza, normalización y clustering.
Limpieza de datos antes de la vectorización
Después de recopilar los datos semánticos tendrás un archivo con decenas de miles de consultas de búsqueda. A primera vista parece que ya se puede pasar a la etapa de vectorización y clustering, pero la calidad del resultado depende en gran medida de la preparación previa de los datos.
En esta etapa, las bibliotecas Pandas y NumPy son útiles para limpiar y normalizar el conjunto de datos de entrada. Una lista de consultas sin procesar casi siempre contiene duplicados, caracteres innecesarios, basura técnica, frases irrelevantes y otros artefactos generados durante el scraping y la combinación de varias fuentes.
Para el modelo de embeddings, estas cadenas se convertirán igualmente en vectores, pero esto generará una carga computacional innecesaria y puede empeorar la estructura de los clústeres finales. Por eso, antes de la vectorización conviene convertir los datos a un formato uniforme y predecible.
Las principales etapas de preparación de los datos son las siguientes:
Eliminación de basura técnica. Se eliminan etiquetas HTML, espacios innecesarios, caracteres invisibles, emojis y otros elementos que puedan haber llegado a los datos durante el scraping.
Deduplicación global. Al combinar consultas de varias fuentes, las coincidencias son prácticamente inevitables. No tiene sentido vectorizar varias veces cadenas idénticas, por lo que es mejor eliminar los duplicados completos de antemano.
Filtrado por palabras clave excluidas. En esta etapa puedes excluir consultas que contengan topónimos irrelevantes, marcadores no deseados o palabras que no correspondan a los objetivos del proyecto. Por ejemplo, para la semántica comercial pueden ser consultas con palabras como «gratis», «torrent» y modificadores similares.
Reducir las palabras a su forma de diccionario (lematización) es opcional. Los modelos modernos entienden bien las diferentes formas de una misma palabra. También reconocen que “comprar iPhone” y “quiero comprar un iPhone” son prácticamente la misma consulta. Por eso no es necesario modificar las palabras deliberadamente antes del procesamiento. Sin embargo, un preprocesamiento sencillo puede ayudar a encontrar consultas similares y reducir el volumen de datos.
Como resultado, debes obtener un conjunto limpio y filtrado de consultas únicas sin ruido técnico evidente. Después puedes pasar los datos a la siguiente etapa: convertir el texto en representaciones vectoriales.
Vectorización de consultas de búsqueda
El clustering vectorial se diferencia de la comparación clásica de cadenas porque no trabaja con coincidencias exactas de palabras, sino con su representación semántica. Cada consulta de búsqueda se convierte en un vector numérico (un embedding) que codifica sus características semánticas.
Para ello se utilizan modelos de embeddings especializados. Primero, el texto se convierte en tokens y, después, el modelo genera un vector con una dimensionalidad fija. Como resultado, las consultas semánticamente similares se sitúan más cerca unas de otras en el espacio vectorial.
Por ejemplo, las frases “comprar iPhone 15” y “precio iPhone 15 Pro” tendrán vectores más próximos que “comprar iPhone 15” y “reparación de teléfonos Apple”. Esta propiedad permite utilizar algoritmos de clustering para agrupar las consultas.
Soluciones comerciales (OpenAI, Claude)
Para la vectorización puedes utilizar tanto APIs en la nube como modelos locales. La elección depende del volumen de datos, los requisitos de calidad, la infraestructura disponible y el coste de procesamiento asumible.
Las APIs comerciales son cómodas porque no requieren desplegar el modelo localmente y permiten empezar el proceso rápidamente. El proveedor se encarga de la infraestructura, las actualizaciones de los modelos y el escalado de los recursos de cómputo.
Para volúmenes de datos pequeños y medianos, esta es una de las opciones más sencillas. Sin embargo, al procesar cientos de miles o millones de consultas debes tener en cuenta el coste de la API, los límites de solicitudes y el rendimiento.
Además, trabajar con APIs requiere una arquitectura tolerante a fallos (evitar los límites de la API usando múltiples cuentas, rotación de claves y solicitudes asíncronas con aiohttp).
Puedes probar por tu cuenta cómo funcionan las redes neuronales comerciales con consultas mediante este código:
import os
from openai import OpenAI

# Inicializar el cliente
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Nuestro conjunto de datos sin procesar
queries = ["comprar iphone 15", "precio iphone 15 pro", "reparación de teléfonos apple"]

# 1. Vectorizamos las consultas mediante OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# Como resultado obtenemos vectores multidimensionales listos para usar
embeddings = [data.embedding for data in response.data]
import os
from openai import OpenAI

# Inicializar el cliente
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Nuestro conjunto de datos sin procesar
queries = ["comprar iphone 15", "precio iphone 15 pro", "reparación de teléfonos apple"]

# 1. Vectorizamos las consultas mediante OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# Como resultado obtenemos vectores multidimensionales listos para usar
embeddings = [data.embedding for data in response.data]
Modelos locales del ecosistema de Hugging Face
Una alternativa a las APIs comerciales son los modelos abiertos de embeddings que se ejecutan localmente. Para tareas multilingües puedes utilizar, por ejemplo, jinaai/jina-embeddings-v3 o Alibaba-NLP/gte-multilingual-large, que no requieren pagar por cada generación.
from sentence_transformers import SentenceTransformer

print("⏳ 1. Cargando el modelo BGE-m3 estable...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["comprar iphone 15", "precio iphone 15 pro", "reparación de teléfonos apple"]

print(f"⏳ 2. Vectorizando {len(queries)} consultas...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ ¡Listo! Veamos el resultado:")
print(f"📊 Dimensiones de los datos: {embeddings.shape}")
print("🔍 Vector para la frase 'comprar iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... y {len(embeddings[0]) - 5} números más.")
from sentence_transformers import SentenceTransformer

print("⏳ 1. Cargando el modelo BGE-m3 estable...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["comprar iphone 15", "precio iphone 15 pro", "reparación de teléfonos apple"]

print(f"⏳ 2. Vectorizando {len(queries)} consultas...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ ¡Listo! Veamos el resultado:")
print(f"📊 Dimensiones de los datos: {embeddings.shape}")
print("🔍 Vector para la frase 'comprar iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... y {len(embeddings[0]) - 5} números más.")
La principal ventaja de los modelos locales es que todo el procesamiento permanece dentro de tu propia infraestructura. Procesas las consultas de búsqueda sin enviarlas a una API de terceros y, una vez cargado el modelo, puedes vectorizarlas sin pagar por cada solicitud.
Trabajar con modelos locales suele resultar más rentable: permiten realizar la vectorización sin pagar por cada llamada a la API. Sin embargo, requieren una cantidad considerable de espacio en disco: junto con los pesos y la caché, los archivos pueden ocupar varios gigabytes. Si ya no necesitas un modelo, después de terminar tu trabajo conviene eliminar sus archivos locales y limpiar la caché.
Almacenamiento y búsqueda de representaciones vectoriales
Después de la vectorización, cada consulta de búsqueda está representada como un vector de embeddings. La siguiente pregunta es dónde almacenar estos datos y cómo encontrar de forma eficiente consultas semánticamente similares.
Para conjuntos de datos pequeños, los vectores pueden permanecer en memoria, por ejemplo, en matrices de NumPy o estructuras de Pandas. Si solo tienes unos pocos miles de consultas, normalmente es suficiente para experimentos y procesamiento local.
A medida que aumenta el dataset, la situación cambia. Si comparas cada vector directamente con todos los demás, el número de operaciones crece de forma cuadrática. Para decenas o cientos de miles de consultas, este enfoque se vuelve rápidamente costoso tanto en tiempo de cálculo como en memoria.
Este problema se resuelve mediante bases de datos vectoriales. Están optimizadas específicamente para estas tareas y admiten algoritmos de búsqueda aproximada de vecinos más cercanos (en particular, HNSW). Los índices integrados permiten evitar la comparación directa de todos los vectores entre sí y ofrecen búsquedas prácticamente instantáneas de las frases más similares incluso entre millones de registros.
Para este tipo de tareas existen varias soluciones populares: Pinecone, Qdrant, PostgreSQL con la extensión pgvector y otras. En nuestro ejemplo utilizaremos ChromaDB. Es adecuada para experimentos locales: funciona sin un servidor independiente, guarda los datos en disco y se integra fácilmente con código Python.
Guardemos los embeddings obtenidos en la etapa anterior y comprobemos cómo funciona la búsqueda semántica:
import chromadb

# 1. Inicializamos la base de datos local (creará la carpeta semantic_db)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Creamos la colección
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Cargamos nuestros vectores y textos de las consultas
collection.add(
    embeddings=embeddings.tolist(), # vectores de nuestro modelo local BGE-m3
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ ¡Datos guardados en la base de datos!\n")

# ==========================================
# MAGIA DE LA BÚSQUEDA: comprobamos cómo entiende el significado la base de datos
# ==========================================
test_phrase = "cuánto cuesta un iphone nuevo"
print(f"Buscando en la base de datos la frase: '{test_phrase}'")

# Convertimos la frase de prueba en un vector utilizando el mismo modelo
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Pedimos a la base de datos que encuentre las dos opciones más similares
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Consulta más cercana: {results['documents'][0][0]} (Distancia: {results['distances'][0][0]:.4f})")
print(f"Segunda más cercana: {results['documents'][0][1]} (Distancia: {results['distances'][0][1]:.4f})")
import chromadb

# 1. Inicializamos la base de datos local (creará la carpeta semantic_db)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Creamos la colección
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Cargamos nuestros vectores y textos de las consultas
collection.add(
    embeddings=embeddings.tolist(), # vectores de nuestro modelo local BGE-m3
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ ¡Datos guardados en la base de datos!\n")

# ==========================================
# MAGIA DE LA BÚSQUEDA: comprobamos cómo entiende el significado la base de datos
# ==========================================
test_phrase = "cuánto cuesta un iphone nuevo"
print(f"Buscando en la base de datos la frase: '{test_phrase}'")

# Convertimos la frase de prueba en un vector utilizando el mismo modelo
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Pedimos a la base de datos que encuentre las dos opciones más similares
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Consulta más cercana: {results['documents'][0][0]} (Distancia: {results['distances'][0][0]:.4f})")
print(f"Segunda más cercana: {results['documents'][0][1]} (Distancia: {results['distances'][0][1]:.4f})")
Elección del algoritmo de clustering
Después de obtener los vectores de embeddings puedes pasar a la siguiente etapa: agrupar las consultas de búsqueda. En este punto es importante elegir un algoritmo que se adapte a la estructura de los datos y no requiera suposiciones demasiado rígidas sobre el número de clústeres futuros.
Por qué K-Means no siempre es adecuado para el clustering SEO
K-Means es un algoritmo clásico de clustering que divide los datos en un número de grupos definido de antemano. El número de clústeres se especifica con el parámetro k.
Por ejemplo, si tenemos 10 000 consultas de búsqueda y especificamos k=500, el algoritmo creará 500 centroides y distribuirá cada consulta entre el más cercano en el espacio vectorial.
La principal limitación de este enfoque es que el número de clústeres debe determinarse de antemano. Para un núcleo semántico esto no siempre resulta cómodo: antes de empezar el procesamiento es difícil saber cuántos grupos de intenciones independientes contiene el conjunto—50, 500 o 1 200.
Si el valor de k se elige mal, las consultas relacionadas pueden terminar separadas entre varios grupos. También puede ocurrir lo contrario: consultas cercanas en cuanto a temática pero diferentes en intención pueden acabar agrupadas simplemente porque el algoritmo debe generar el número de clústeres especificado.
Clustering con DBSCAN
Si no se conoce de antemano el número de grupos, puedes utilizar algoritmos de clustering basados en densidad. Una de las opciones más conocidas es DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
A diferencia de K-Means, DBSCAN no requiere especificar de antemano el número de clústeres. El algoritmo busca zonas del espacio vectorial en las que los objetos están suficientemente cerca entre sí y las convierte en grupos.
El comportamiento de DBSCAN está determinado por dos parámetros principales:
eps(épsilon/distancia): la distancia máxima entre puntos a la que se consideran vecinos. En nuestro caso, es el umbral de similitud coseno de los vectores.min_samples: el número mínimo de vecinos necesario para formar un clúster completo.
DBSCAN toma la primera consulta aleatoria. Si hay min_samples consultas adicionales dentro de un radio eps, se forma el núcleo de un clúster. El algoritmo empieza a expandirse en todas direcciones, incorporando nuevos vecinos hasta que se agota la densidad.
El parámetro eps puede compararse aproximadamente con el nivel de rigidez del clustering:
Un
epsmenor corresponde a una agrupación más estricta. Solo las consultas con representaciones vectoriales muy similares acabarán en el mismo clúster, por lo que normalmente habrá más grupos y serán más compactos.Un
epsmayor hace que las condiciones para unir consultas sean más flexibles. Los clústeres serán más grandes y podrán incluir una semántica más amplia, pero también aumenta el riesgo de combinar consultas con intenciones diferentes.
Otra propiedad útil de DBSCAN es su capacidad para detectar ruido. Si una consulta no se encuentra en una zona suficientemente densa del espacio vectorial, el algoritmo no intenta forzarla dentro de uno de los clústeres existentes, sino que la marca como Outlier. Puedes exportar estas consultas a un archivo independiente para revisarlas manualmente, en lugar de perjudicar las landing pages que ya están limpias.
Al mismo tiempo, DBSCAN es sensible a la elección de eps: un único umbral no siempre funciona bien con datos en los que algunos grupos están muy concentrados y otros mucho más dispersos.
En estos casos puedes usar HDBSCAN, una evolución jerárquica del enfoque basado en densidad. Es capaz de encontrar clústeres con diferentes densidades y adaptar automáticamente el parámetro eps donde las consultas están más agrupadas o, por el contrario, más dispersas.
Escribimos el script de clustering
Extraigamos nuestros vectores de la base de datos local de ChromaDB y pasémoslos por DBSCAN mediante la biblioteca scikit-learn:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Conectando con la base de datos vectorial...")
client = chromadb.PersistentClient(path="./semantic_db")

# Extraemos la colección con los vectores (indica tu propio nombre)
collection = client.get_collection(name="search_queries")

# Extraemos todos los textos de las consultas y sus vectores matemáticos
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Consultas extraídas de la base de datos: {len(documents)}")

# ==========================================
# CLUSTERING (DBSCAN)
# ==========================================
print("⏳ 2. Iniciando el algoritmo DBSCAN...")

# AJUSTES:
# eps = 0.15 (Distancia coseno permitida. Cuanto menor sea, más estrictos serán los clústeres);
# min_samples = 2 (Mínimo de 2 consultas para crear un grupo);
# metric="cosine" (Indicamos explícitamente que medimos los ángulos entre vectores y no la distancia lineal).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Ejecutamos la agrupación
labels = dbscan.fit_predict(embeddings)

# ==========================================
# RESULTADOS
# ==========================================
# El algoritmo asignó a cada consulta un número de grupo (0, 1, 2...).
# Si una consulta se considera ruido (Outlier), recibe la etiqueta -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== RESULTADOS DE LA AGRUPACIÓN ===")
for cluster_id, docs in clusters.items():
    print(f"\n Clúster #{cluster_id} (Consultas: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Valores atípicos/Ruido (Consultas: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Conectando con la base de datos vectorial...")
client = chromadb.PersistentClient(path="./semantic_db")

# Extraemos la colección con los vectores (indica tu propio nombre)
collection = client.get_collection(name="search_queries")

# Extraemos todos los textos de las consultas y sus vectores matemáticos
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Consultas extraídas de la base de datos: {len(documents)}")

# ==========================================
# CLUSTERING (DBSCAN)
# ==========================================
print("⏳ 2. Iniciando el algoritmo DBSCAN...")

# AJUSTES:
# eps = 0.15 (Distancia coseno permitida. Cuanto menor sea, más estrictos serán los clústeres);
# min_samples = 2 (Mínimo de 2 consultas para crear un grupo);
# metric="cosine" (Indicamos explícitamente que medimos los ángulos entre vectores y no la distancia lineal).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Ejecutamos la agrupación
labels = dbscan.fit_predict(embeddings)

# ==========================================
# RESULTADOS
# ==========================================
# El algoritmo asignó a cada consulta un número de grupo (0, 1, 2...).
# Si una consulta se considera ruido (Outlier), recibe la etiqueta -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== RESULTADOS DE LA AGRUPACIÓN ===")
for cluster_id, docs in clusters.items():
    print(f"\n Clúster #{cluster_id} (Consultas: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Valores atípicos/Ruido (Consultas: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
En el ejemplo anterior se utiliza un modelo local, pero al trabajar con modelos de embeddings comerciales, el valor de eps puede requerir ajustes adicionales. En particular, un umbral de 0.15 adecuado para un modelo puede hacer que, con otra configuración, una parte importante de las consultas se una en un único clúster grande o se clasifique incorrectamente como ruido.
Por eso, al cambiar de modelo, es necesario ajustar eps por separado, teniendo en cuenta la distribución de las distancias entre los vectores y la calidad real de los grupos obtenidos.
Clustering híbrido para separar intenciones de búsqueda
El clustering puede basarse únicamente en vectores de embeddings, pero en la práctica esto suele ser insuficiente. La similitud semántica no siempre significa que coincida la intención de búsqueda.
Por ejemplo, las consultas “comprar un navegador antidetección” y “qué es un navegador antidetección” están muy relacionadas temáticamente. El modelo de embeddings reconoce correctamente que ambas frases se refieren al mismo objeto, por lo que la distancia entre sus vectores será pequeña. Como resultado, DBSCAN probablemente colocará estas consultas en el mismo clúster.
Desde el punto de vista SEO, sin embargo, esto no es deseable porque la intención es diferente. La primera implica una landing page comercial, mientras que la segunda implica contenido informativo.
Veámoslo con un pequeño conjunto de prueba:
queries = [
    # Informativas
    "para qué sirven los navegadores antidetección",
    "qué es un navegador antidetección",
    "cómo funcionan los navegadores antidetección",
    "comparar navegadores antidetección",

    # Comerciales
    "comprar un navegador antidetección",
    "comprar proxies para un navegador antidetección",
    "prueba de un navegador antidetección",

    # Descarga
    "descargar octo browser navegador antidetección",
    "octo browser navegador antidetección descargar",
    "octo navegador antidetección descargar",

    # Consultas de otra temática
    "reseña ford everest 2024",
    "comprar ford everest de segunda mano",

    # Ruido
    "tiempo en pattaya en mayo",
    "receta de sopa tom yum"
]
queries = [
    # Informativas
    "para qué sirven los navegadores antidetección",
    "qué es un navegador antidetección",
    "cómo funcionan los navegadores antidetección",
    "comparar navegadores antidetección",

    # Comerciales
    "comprar un navegador antidetección",
    "comprar proxies para un navegador antidetección",
    "prueba de un navegador antidetección",

    # Descarga
    "descargar octo browser navegador antidetección",
    "octo browser navegador antidetección descargar",
    "octo navegador antidetección descargar",

    # Consultas de otra temática
    "reseña ford everest 2024",
    "comprar ford everest de segunda mano",

    # Ruido
    "tiempo en pattaya en mayo",
    "receta de sopa tom yum"
]
Al hacer clustering únicamente por similitud vectorial, las consultas relacionadas con navegadores antidetección pueden acabar en el mismo grupo a pesar de sus diferencias de intención.
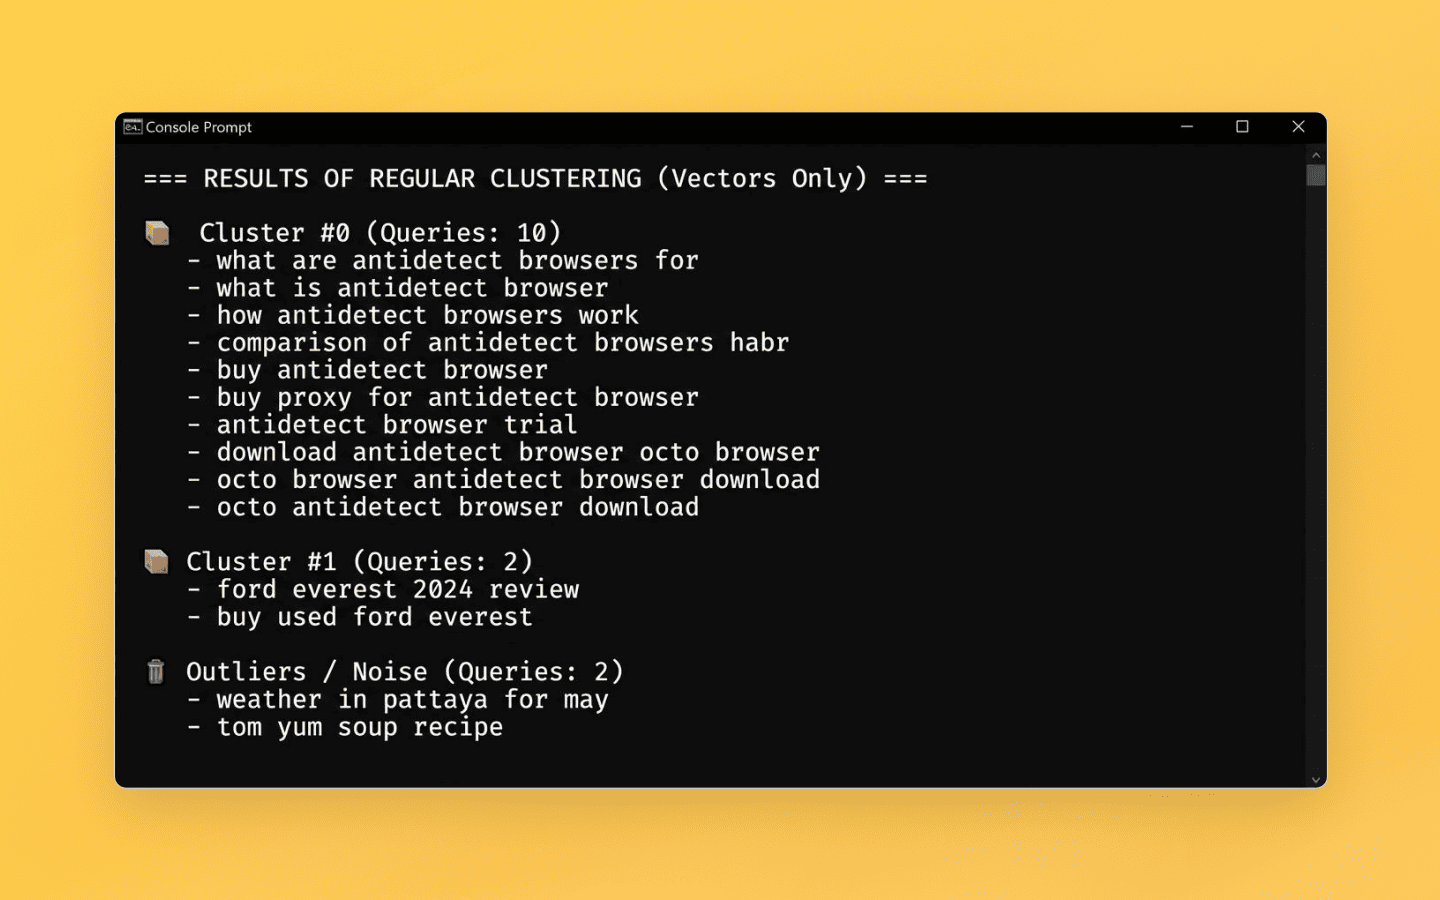
En esta etapa, el navegador antidetección vuelve a formar parte del pipeline, pero ya no para recopilar datos semánticos, sino para obtener datos de SERP. Para cada consulta hay que recopilar los resultados de búsqueda y después utilizar la intersección de las URLs como una señal adicional para el clustering.
Cuando hay un gran número de consultas, esta recopilación puede distribuirse cómodamente entre perfiles de navegador aislados, por ejemplo, usando Octo Browser junto con Playwright o Puppeteer.

Para cada consulta se recopilan las 10 primeras URLs de los resultados de búsqueda. Después, antes de ejecutar DBSCAN, se comparan los resultados de las frases semánticamente similares. Si dos consultas no tienen URLs en común o su número está por debajo del umbral establecido, la distancia entre los vectores correspondientes se incrementa artificialmente.
De este modo, los embeddings se utilizan para encontrar consultas semánticamente similares, mientras que la SERP actúa como una restricción adicional y ayuda a evitar que se agrupen frases con diferentes intenciones de búsqueda.
Después de añadir los datos de los resultados de búsqueda, el conjunto de prueba que hemos usado antes se distribuye de otra manera:
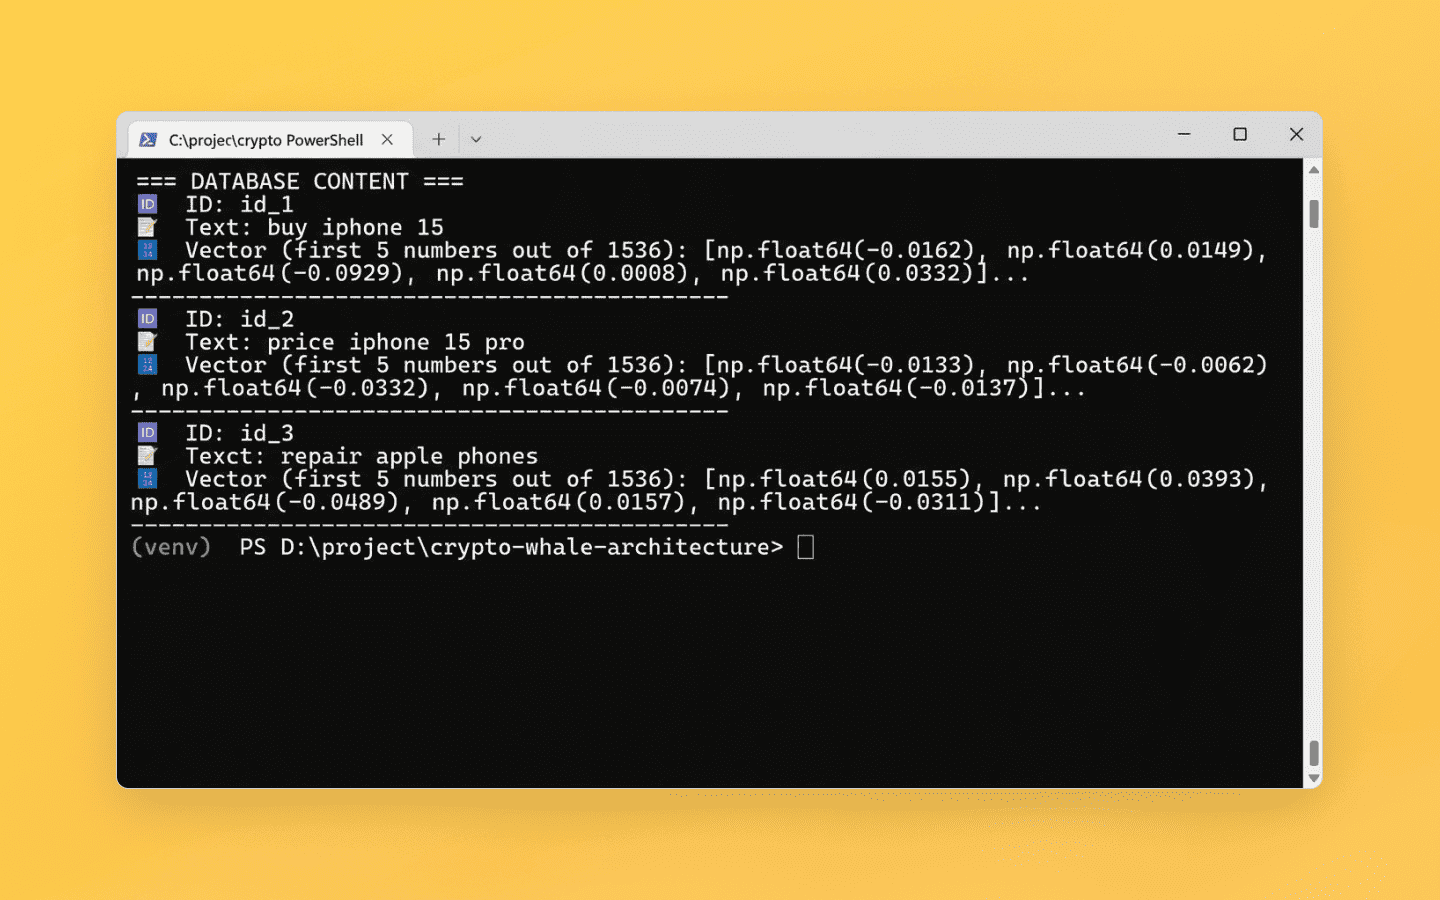
El número de clústeres aumenta y los propios grupos se ajustan mejor a la intención de búsqueda prevista de las consultas.
Postprocesamiento de resultados y actualización de datos
Después de formar los clústeres queda una tarea práctica más: asignar un nombre claro a cada grupo. Números como “Clúster #42” son cómodos para el algoritmo, pero aportan muy poca información a un especialista SEO, editor o redactor de contenidos.
Naming automático de clústeres con un LLM
Cuando el trabajo se hace manualmente, el especialista tiene que revisar el contenido de cada grupo, determinar la intención principal y formular el nombre de la futura página o contenido. Si hay varios cientos de clústeres, esta etapa requiere mucho tiempo.
Esta parte del proceso puede automatizarse con un LLM. Al modelo se le pasa una lista de consultas de un clúster, después determina la intención general y genera un título adecuado. Puedes utilizar modelos en la nube o soluciones locales, por ejemplo Ollama.
Es importante definir de antemano un formato de respuesta estricto. Si simplemente le pides al modelo que invente un nombre, junto con el título puedes obtener explicaciones y comentarios adicionales. Por eso, en el prompt del sistema es mejor indicar explícitamente que la salida debe contener únicamente el título, sin texto adicional:
from openai import OpenAI

# 1. INICIALIZACIÓN Y CLAVE
# Introduce aquí tu clave API real
client_ai = OpenAI(api_key="sk-TU_CLAVE_DE_OPENAI")

# 2. NUESTROS DATOS (resultado del clustering híbrido)
clusters = {
    0: [
        "para qué sirven los navegadores antidetección",
        "qué es un navegador antidetección",
        "cómo funcionan los navegadores antidetección",
        "comparar navegadores antidetección"
    ],
    1: [
        "comprar un navegador antidetección",
        "comprar proxies para un navegador antidetección",
        "prueba de un navegador antidetección"
    ],
    2: [
        "descargar octo browser navegador antidetección",
        "Octo browser navegador antidetección descargar",
        "Octo navegador antidetección descargar"
    ]
}

# Prompt del sistema (definimos las reglas para el modelo)
prompt = """Eres un especialista en SEO experto. Analiza el siguiente grupo de consultas de búsqueda. Determina la intención principal del usuario y genera un único título H1 relevante para una futura página de categoría o artículo. Devuelve ÚNICAMENTE el título, sin ningún texto adicional, citas ni explicaciones."""

print("⏳ Enviando los clústeres a GPT-4o-mini para el naming automático...\n")

# 3. Recorremos todos los clústeres
for cluster_id, queries in clusters.items():
    # Enviamos las consultas del clúster actual a la API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Combinamos las consultas en un solo texto
        ],
        temperature=0.3
    )

    # Obtenemos la respuesta
    h1_title = response.choices[0].message.content

    # Mostramos el resultado en la consola
    print(f"Clúster #{cluster_id}")
    print(f"Frases: {', '.join(queries)}")
    print(f"H1 generado: {h1_title}\n")
from openai import OpenAI

# 1. INICIALIZACIÓN Y CLAVE
# Introduce aquí tu clave API real
client_ai = OpenAI(api_key="sk-TU_CLAVE_DE_OPENAI")

# 2. NUESTROS DATOS (resultado del clustering híbrido)
clusters = {
    0: [
        "para qué sirven los navegadores antidetección",
        "qué es un navegador antidetección",
        "cómo funcionan los navegadores antidetección",
        "comparar navegadores antidetección"
    ],
    1: [
        "comprar un navegador antidetección",
        "comprar proxies para un navegador antidetección",
        "prueba de un navegador antidetección"
    ],
    2: [
        "descargar octo browser navegador antidetección",
        "Octo browser navegador antidetección descargar",
        "Octo navegador antidetección descargar"
    ]
}

# Prompt del sistema (definimos las reglas para el modelo)
prompt = """Eres un especialista en SEO experto. Analiza el siguiente grupo de consultas de búsqueda. Determina la intención principal del usuario y genera un único título H1 relevante para una futura página de categoría o artículo. Devuelve ÚNICAMENTE el título, sin ningún texto adicional, citas ni explicaciones."""

print("⏳ Enviando los clústeres a GPT-4o-mini para el naming automático...\n")

# 3. Recorremos todos los clústeres
for cluster_id, queries in clusters.items():
    # Enviamos las consultas del clúster actual a la API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Combinamos las consultas en un solo texto
        ],
        temperature=0.3
    )

    # Obtenemos la respuesta
    h1_title = response.choices[0].message.content

    # Mostramos el resultado en la consola
    print(f"Clúster #{cluster_id}")
    print(f"Frases: {', '.join(queries)}")
    print(f"H1 generado: {h1_title}\n")
Para el conjunto de prueba, el resultado puede ser el siguiente:
Clúster #0
   Frases: para qué sirven los navegadores antidetección, qué es un navegador antidetección, cómo funcionan los navegadores antidetección
   H1 generado: Para qué sirven los navegadores antidetección

Clúster #1
   Frases: comprar un navegador antidetección, comprar proxies para un navegador antidetección, prueba de un navegador antidetección
   H1 generado: Los mejores navegadores antidetección y proxies para una navegación segura

Clúster #2
   Frases: descargar el navegador antidetección Octo Browser, Octo Browser navegador antidetección descargar, descargar el navegador antidetección Octo
   H1 generado: Descargar el navegador antidetección Octo Browser
Clúster #0
   Frases: para qué sirven los navegadores antidetección, qué es un navegador antidetección, cómo funcionan los navegadores antidetección
   H1 generado: Para qué sirven los navegadores antidetección

Clúster #1
   Frases: comprar un navegador antidetección, comprar proxies para un navegador antidetección, prueba de un navegador antidetección
   H1 generado: Los mejores navegadores antidetección y proxies para una navegación segura

Clúster #2
   Frases: descargar el navegador antidetección Octo Browser, Octo Browser navegador antidetección descargar, descargar el navegador antidetección Octo
   H1 generado: Descargar el navegador antidetección Octo Browser
En un proyecto real, el número de clústeres será mucho mayor, por lo que no resulta práctico almacenar los datos originales directamente en el código. Normalmente, los clústeres se cargan desde un archivo o una base de datos, y los nombres generados se escriben de nuevo en la tabla para continuar trabajando con ellos.
En esta etapa, el LLM no participa en el propio clustering — se utiliza únicamente para el postprocesamiento de los grupos ya formados. Esto permite automatizar la parte rutinaria del trabajo y obtener una estructura clara del núcleo semántico sin tener que asignar manualmente un nombre a cada clúster.
Añadir nuevas consultas
Otra ventaja de almacenar los embeddings en ChromaDB es que puedes trabajar con nuevos datos sin volver a buscar manualmente los vecinos más cercanos en todo el conjunto.
Después de obtener una nueva porción de datos semánticos, las consultas siguen el mismo pipeline: limpieza, vectorización y adición a ChromaDB. Para cada nuevo embedding puedes encontrar las consultas existentes más cercanas y evaluar la distancia hasta ellas.
Si los vecinos encontrados pertenecen a un clúster existente estable y cumplen el umbral de similitud establecido, la nueva consulta puede añadirse a ese grupo. Si no existe un clúster adecuado, la consulta queda como candidata para formar un nuevo grupo o se envía a un procesamiento adicional.
Este enfoque permite utilizar la base de datos vectorial acumulada como índice para procesar nuevas consultas y evita realizar una búsqueda por pares completa en todo el núcleo semántico cada vez que se actualiza.
Conclusión
Crear tu propio pipeline basado en modelos de embeddings, almacenamiento vectorial y algoritmos de clustering requiere tiempo para configurarlo, probarlo y ajustar sus parámetros. Sin embargo, una vez hecho, obtienes un sistema que puedes adaptar a un tema concreto, un volumen de datos determinado y los requisitos específicos del proyecto.
Las principales ventajas de este enfoque son:
Menor dependencia de servicios especializados. No necesitas un servicio SEO independiente con planes fijos y límites de volumen para realizar el clustering. Las principales limitaciones pasan a tu propia infraestructura: recursos de cómputo, memoria y espacio en disco.
Control de la lógica del clustering. Puedes elegir el modelo de embeddings, configurar
eps, tener en cuenta los datos de SERP y cambiar las reglas para combinar consultas según la tarea.Control sobre los datos. Al utilizar modelos y almacenamiento locales, los datos semánticos permanecen dentro de tu propia infraestructura y no se envían a APIs de terceros.
El principal valor de esta solución no está en sustituir por completo las herramientas SEO existentes, sino en poder crear tu propio pipeline controlable. Utiliza Octo Browser para la recopilación automatizada de datos semánticos y SERP y realiza el resto del procesamiento localmente con embeddings, ChromaDB y algoritmos de clustering.
Una vez que hayas construido este proceso y lo hayas ajustado cuidadosamente con datos reales, dejará de ser un script puntual y se convertirá en una herramienta de trabajo que puedes reutilizar y escalar a medida que crece tu núcleo semántico.
Mantén tu anonimato en línea con Octo Browser. Tu huella digital real no se puede rastrear.
¿Te gustaría probar Octo Browser con descuento?
Usa el código promocional OCTOBLOG para obtener un 30% de descuento en cualquier suscripción. Esta oferta es válida solo para nuevos usuarios.
Recopilación de datos semánticos
Existen varios enfoques para recopilar datos semánticos, pero el proceso básico suele seguir el mismo esquema: primero se crea un conjunto inicial de consultas mediante servicios como Google Ads Keyword Planner y otras herramientas que proporcionan datos sobre el volumen de búsquedas del tema correspondiente.
Después, el conjunto inicial se amplía con consultas relacionadas, sugerencias de búsqueda y otras fuentes de datos semánticos. Anteriormente, Key Collector se utilizaba con frecuencia para este tipo de tareas, pero hoy en día a menudo es necesario combinar varias herramientas o utilizar scripts propios para recopilar los datos.
Uso de herramientas de automatización para recopilar datos semánticos
Si las soluciones comerciales no se ajustan a tu presupuesto, necesidades funcionales o limitaciones, puedes automatizar por tu cuenta parte del proceso de recopilación semántica. Por ejemplo, para obtener sugerencias de búsqueda y otros datos de interfaces web, puedes utilizar navegadores headless basados en Puppeteer o Playwright.
Si recopilas datos semánticos en un gran número de sesiones paralelas, necesitas gestionar de forma segura los perfiles del navegador y sus entornos. Para eso puedes utilizar un navegador antidetección como Octo Browser para aislar sesiones, gestionar los parámetros de los perfiles y conectar diferentes tipos de proxies. Esto simplifica la infraestructura de scraping y reduce la cantidad de configuración manual necesaria para cada instancia independiente del navegador.
La principal dificultad al recopilar datos a gran escala son las restricciones de los motores de búsqueda. Las solicitudes automatizadas pueden activar rate limits, CAPTCHAs, u otros mecanismos de protección, por lo que al diseñar este tipo de pipeline debes tener en cuenta la estabilidad de las sesiones, la frecuencia de las solicitudes y la gestión de bloqueos temporales.
Al trabajar con automatización del navegador, también es importante controlar parámetros del entorno como el User-Agent, el tamaño de la ventana, la configuración regional, WebGL y otras características de la sesión del navegador. Puedes hacerlo con tu propia configuración de Puppeteer o Playwright, o utilizar soluciones de navegador especializadas que permiten crear perfiles aislados con diferentes parámetros del entorno.
Otra tarea independiente es organizar la infraestructura de red. Para la recopilación de datos distribuida pueden utilizarse proxies de diferentes tipos: de centros de datos, residenciales o móviles. La elección depende del volumen de solicitudes y de los requisitos de estabilidad, velocidad y coste. Los proxies de centros de datos suelen ser más baratos y rápidos, pero en algunos escenarios están sujetos a restricciones con mayor frecuencia. Las direcciones residenciales y móviles suelen ser más resistentes, pero son más caras y tienen un menor ancho de banda.
Una vez finalizada la recopilación principal, puedes complementar la lista final de consultas con datos procedentes de bases semánticas externas. El resultado debe ser el conjunto de consultas más completo posible, que después puede pasar a las etapas de limpieza, normalización y clustering.
Limpieza de datos antes de la vectorización
Después de recopilar los datos semánticos tendrás un archivo con decenas de miles de consultas de búsqueda. A primera vista parece que ya se puede pasar a la etapa de vectorización y clustering, pero la calidad del resultado depende en gran medida de la preparación previa de los datos.
En esta etapa, las bibliotecas Pandas y NumPy son útiles para limpiar y normalizar el conjunto de datos de entrada. Una lista de consultas sin procesar casi siempre contiene duplicados, caracteres innecesarios, basura técnica, frases irrelevantes y otros artefactos generados durante el scraping y la combinación de varias fuentes.
Para el modelo de embeddings, estas cadenas se convertirán igualmente en vectores, pero esto generará una carga computacional innecesaria y puede empeorar la estructura de los clústeres finales. Por eso, antes de la vectorización conviene convertir los datos a un formato uniforme y predecible.
Las principales etapas de preparación de los datos son las siguientes:
Eliminación de basura técnica. Se eliminan etiquetas HTML, espacios innecesarios, caracteres invisibles, emojis y otros elementos que puedan haber llegado a los datos durante el scraping.
Deduplicación global. Al combinar consultas de varias fuentes, las coincidencias son prácticamente inevitables. No tiene sentido vectorizar varias veces cadenas idénticas, por lo que es mejor eliminar los duplicados completos de antemano.
Filtrado por palabras clave excluidas. En esta etapa puedes excluir consultas que contengan topónimos irrelevantes, marcadores no deseados o palabras que no correspondan a los objetivos del proyecto. Por ejemplo, para la semántica comercial pueden ser consultas con palabras como «gratis», «torrent» y modificadores similares.
Reducir las palabras a su forma de diccionario (lematización) es opcional. Los modelos modernos entienden bien las diferentes formas de una misma palabra. También reconocen que “comprar iPhone” y “quiero comprar un iPhone” son prácticamente la misma consulta. Por eso no es necesario modificar las palabras deliberadamente antes del procesamiento. Sin embargo, un preprocesamiento sencillo puede ayudar a encontrar consultas similares y reducir el volumen de datos.
Como resultado, debes obtener un conjunto limpio y filtrado de consultas únicas sin ruido técnico evidente. Después puedes pasar los datos a la siguiente etapa: convertir el texto en representaciones vectoriales.
Vectorización de consultas de búsqueda
El clustering vectorial se diferencia de la comparación clásica de cadenas porque no trabaja con coincidencias exactas de palabras, sino con su representación semántica. Cada consulta de búsqueda se convierte en un vector numérico (un embedding) que codifica sus características semánticas.
Para ello se utilizan modelos de embeddings especializados. Primero, el texto se convierte en tokens y, después, el modelo genera un vector con una dimensionalidad fija. Como resultado, las consultas semánticamente similares se sitúan más cerca unas de otras en el espacio vectorial.
Por ejemplo, las frases “comprar iPhone 15” y “precio iPhone 15 Pro” tendrán vectores más próximos que “comprar iPhone 15” y “reparación de teléfonos Apple”. Esta propiedad permite utilizar algoritmos de clustering para agrupar las consultas.
Soluciones comerciales (OpenAI, Claude)
Para la vectorización puedes utilizar tanto APIs en la nube como modelos locales. La elección depende del volumen de datos, los requisitos de calidad, la infraestructura disponible y el coste de procesamiento asumible.
Las APIs comerciales son cómodas porque no requieren desplegar el modelo localmente y permiten empezar el proceso rápidamente. El proveedor se encarga de la infraestructura, las actualizaciones de los modelos y el escalado de los recursos de cómputo.
Para volúmenes de datos pequeños y medianos, esta es una de las opciones más sencillas. Sin embargo, al procesar cientos de miles o millones de consultas debes tener en cuenta el coste de la API, los límites de solicitudes y el rendimiento.
Además, trabajar con APIs requiere una arquitectura tolerante a fallos (evitar los límites de la API usando múltiples cuentas, rotación de claves y solicitudes asíncronas con aiohttp).
Puedes probar por tu cuenta cómo funcionan las redes neuronales comerciales con consultas mediante este código:
import os
from openai import OpenAI

# Inicializar el cliente
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Nuestro conjunto de datos sin procesar
queries = ["comprar iphone 15", "precio iphone 15 pro", "reparación de teléfonos apple"]

# 1. Vectorizamos las consultas mediante OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# Como resultado obtenemos vectores multidimensionales listos para usar
embeddings = [data.embedding for data in response.data]
Modelos locales del ecosistema de Hugging Face
Una alternativa a las APIs comerciales son los modelos abiertos de embeddings que se ejecutan localmente. Para tareas multilingües puedes utilizar, por ejemplo, jinaai/jina-embeddings-v3 o Alibaba-NLP/gte-multilingual-large, que no requieren pagar por cada generación.
from sentence_transformers import SentenceTransformer

print("⏳ 1. Cargando el modelo BGE-m3 estable...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["comprar iphone 15", "precio iphone 15 pro", "reparación de teléfonos apple"]

print(f"⏳ 2. Vectorizando {len(queries)} consultas...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ ¡Listo! Veamos el resultado:")
print(f"📊 Dimensiones de los datos: {embeddings.shape}")
print("🔍 Vector para la frase 'comprar iphone 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... y {len(embeddings[0]) - 5} números más.")
La principal ventaja de los modelos locales es que todo el procesamiento permanece dentro de tu propia infraestructura. Procesas las consultas de búsqueda sin enviarlas a una API de terceros y, una vez cargado el modelo, puedes vectorizarlas sin pagar por cada solicitud.
Trabajar con modelos locales suele resultar más rentable: permiten realizar la vectorización sin pagar por cada llamada a la API. Sin embargo, requieren una cantidad considerable de espacio en disco: junto con los pesos y la caché, los archivos pueden ocupar varios gigabytes. Si ya no necesitas un modelo, después de terminar tu trabajo conviene eliminar sus archivos locales y limpiar la caché.
Almacenamiento y búsqueda de representaciones vectoriales
Después de la vectorización, cada consulta de búsqueda está representada como un vector de embeddings. La siguiente pregunta es dónde almacenar estos datos y cómo encontrar de forma eficiente consultas semánticamente similares.
Para conjuntos de datos pequeños, los vectores pueden permanecer en memoria, por ejemplo, en matrices de NumPy o estructuras de Pandas. Si solo tienes unos pocos miles de consultas, normalmente es suficiente para experimentos y procesamiento local.
A medida que aumenta el dataset, la situación cambia. Si comparas cada vector directamente con todos los demás, el número de operaciones crece de forma cuadrática. Para decenas o cientos de miles de consultas, este enfoque se vuelve rápidamente costoso tanto en tiempo de cálculo como en memoria.
Este problema se resuelve mediante bases de datos vectoriales. Están optimizadas específicamente para estas tareas y admiten algoritmos de búsqueda aproximada de vecinos más cercanos (en particular, HNSW). Los índices integrados permiten evitar la comparación directa de todos los vectores entre sí y ofrecen búsquedas prácticamente instantáneas de las frases más similares incluso entre millones de registros.
Para este tipo de tareas existen varias soluciones populares: Pinecone, Qdrant, PostgreSQL con la extensión pgvector y otras. En nuestro ejemplo utilizaremos ChromaDB. Es adecuada para experimentos locales: funciona sin un servidor independiente, guarda los datos en disco y se integra fácilmente con código Python.
Guardemos los embeddings obtenidos en la etapa anterior y comprobemos cómo funciona la búsqueda semántica:
import chromadb

# 1. Inicializamos la base de datos local (creará la carpeta semantic_db)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Creamos la colección
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Cargamos nuestros vectores y textos de las consultas
collection.add(
    embeddings=embeddings.tolist(), # vectores de nuestro modelo local BGE-m3
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ ¡Datos guardados en la base de datos!\n")

# ==========================================
# MAGIA DE LA BÚSQUEDA: comprobamos cómo entiende el significado la base de datos
# ==========================================
test_phrase = "cuánto cuesta un iphone nuevo"
print(f"Buscando en la base de datos la frase: '{test_phrase}'")

# Convertimos la frase de prueba en un vector utilizando el mismo modelo
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Pedimos a la base de datos que encuentre las dos opciones más similares
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Consulta más cercana: {results['documents'][0][0]} (Distancia: {results['distances'][0][0]:.4f})")
print(f"Segunda más cercana: {results['documents'][0][1]} (Distancia: {results['distances'][0][1]:.4f})")
Elección del algoritmo de clustering
Después de obtener los vectores de embeddings puedes pasar a la siguiente etapa: agrupar las consultas de búsqueda. En este punto es importante elegir un algoritmo que se adapte a la estructura de los datos y no requiera suposiciones demasiado rígidas sobre el número de clústeres futuros.
Por qué K-Means no siempre es adecuado para el clustering SEO
K-Means es un algoritmo clásico de clustering que divide los datos en un número de grupos definido de antemano. El número de clústeres se especifica con el parámetro k.
Por ejemplo, si tenemos 10 000 consultas de búsqueda y especificamos k=500, el algoritmo creará 500 centroides y distribuirá cada consulta entre el más cercano en el espacio vectorial.
La principal limitación de este enfoque es que el número de clústeres debe determinarse de antemano. Para un núcleo semántico esto no siempre resulta cómodo: antes de empezar el procesamiento es difícil saber cuántos grupos de intenciones independientes contiene el conjunto—50, 500 o 1 200.
Si el valor de k se elige mal, las consultas relacionadas pueden terminar separadas entre varios grupos. También puede ocurrir lo contrario: consultas cercanas en cuanto a temática pero diferentes en intención pueden acabar agrupadas simplemente porque el algoritmo debe generar el número de clústeres especificado.
Clustering con DBSCAN
Si no se conoce de antemano el número de grupos, puedes utilizar algoritmos de clustering basados en densidad. Una de las opciones más conocidas es DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
A diferencia de K-Means, DBSCAN no requiere especificar de antemano el número de clústeres. El algoritmo busca zonas del espacio vectorial en las que los objetos están suficientemente cerca entre sí y las convierte en grupos.
El comportamiento de DBSCAN está determinado por dos parámetros principales:
eps(épsilon/distancia): la distancia máxima entre puntos a la que se consideran vecinos. En nuestro caso, es el umbral de similitud coseno de los vectores.min_samples: el número mínimo de vecinos necesario para formar un clúster completo.
DBSCAN toma la primera consulta aleatoria. Si hay min_samples consultas adicionales dentro de un radio eps, se forma el núcleo de un clúster. El algoritmo empieza a expandirse en todas direcciones, incorporando nuevos vecinos hasta que se agota la densidad.
El parámetro eps puede compararse aproximadamente con el nivel de rigidez del clustering:
Un
epsmenor corresponde a una agrupación más estricta. Solo las consultas con representaciones vectoriales muy similares acabarán en el mismo clúster, por lo que normalmente habrá más grupos y serán más compactos.Un
epsmayor hace que las condiciones para unir consultas sean más flexibles. Los clústeres serán más grandes y podrán incluir una semántica más amplia, pero también aumenta el riesgo de combinar consultas con intenciones diferentes.
Otra propiedad útil de DBSCAN es su capacidad para detectar ruido. Si una consulta no se encuentra en una zona suficientemente densa del espacio vectorial, el algoritmo no intenta forzarla dentro de uno de los clústeres existentes, sino que la marca como Outlier. Puedes exportar estas consultas a un archivo independiente para revisarlas manualmente, en lugar de perjudicar las landing pages que ya están limpias.
Al mismo tiempo, DBSCAN es sensible a la elección de eps: un único umbral no siempre funciona bien con datos en los que algunos grupos están muy concentrados y otros mucho más dispersos.
En estos casos puedes usar HDBSCAN, una evolución jerárquica del enfoque basado en densidad. Es capaz de encontrar clústeres con diferentes densidades y adaptar automáticamente el parámetro eps donde las consultas están más agrupadas o, por el contrario, más dispersas.
Escribimos el script de clustering
Extraigamos nuestros vectores de la base de datos local de ChromaDB y pasémoslos por DBSCAN mediante la biblioteca scikit-learn:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Conectando con la base de datos vectorial...")
client = chromadb.PersistentClient(path="./semantic_db")

# Extraemos la colección con los vectores (indica tu propio nombre)
collection = client.get_collection(name="search_queries")

# Extraemos todos los textos de las consultas y sus vectores matemáticos
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Consultas extraídas de la base de datos: {len(documents)}")

# ==========================================
# CLUSTERING (DBSCAN)
# ==========================================
print("⏳ 2. Iniciando el algoritmo DBSCAN...")

# AJUSTES:
# eps = 0.15 (Distancia coseno permitida. Cuanto menor sea, más estrictos serán los clústeres);
# min_samples = 2 (Mínimo de 2 consultas para crear un grupo);
# metric="cosine" (Indicamos explícitamente que medimos los ángulos entre vectores y no la distancia lineal).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Ejecutamos la agrupación
labels = dbscan.fit_predict(embeddings)

# ==========================================
# RESULTADOS
# ==========================================
# El algoritmo asignó a cada consulta un número de grupo (0, 1, 2...).
# Si una consulta se considera ruido (Outlier), recibe la etiqueta -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== RESULTADOS DE LA AGRUPACIÓN ===")
for cluster_id, docs in clusters.items():
    print(f"\n Clúster #{cluster_id} (Consultas: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Valores atípicos/Ruido (Consultas: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
En el ejemplo anterior se utiliza un modelo local, pero al trabajar con modelos de embeddings comerciales, el valor de eps puede requerir ajustes adicionales. En particular, un umbral de 0.15 adecuado para un modelo puede hacer que, con otra configuración, una parte importante de las consultas se una en un único clúster grande o se clasifique incorrectamente como ruido.
Por eso, al cambiar de modelo, es necesario ajustar eps por separado, teniendo en cuenta la distribución de las distancias entre los vectores y la calidad real de los grupos obtenidos.
Clustering híbrido para separar intenciones de búsqueda
El clustering puede basarse únicamente en vectores de embeddings, pero en la práctica esto suele ser insuficiente. La similitud semántica no siempre significa que coincida la intención de búsqueda.
Por ejemplo, las consultas “comprar un navegador antidetección” y “qué es un navegador antidetección” están muy relacionadas temáticamente. El modelo de embeddings reconoce correctamente que ambas frases se refieren al mismo objeto, por lo que la distancia entre sus vectores será pequeña. Como resultado, DBSCAN probablemente colocará estas consultas en el mismo clúster.
Desde el punto de vista SEO, sin embargo, esto no es deseable porque la intención es diferente. La primera implica una landing page comercial, mientras que la segunda implica contenido informativo.
Veámoslo con un pequeño conjunto de prueba:
queries = [
    # Informativas
    "para qué sirven los navegadores antidetección",
    "qué es un navegador antidetección",
    "cómo funcionan los navegadores antidetección",
    "comparar navegadores antidetección",

    # Comerciales
    "comprar un navegador antidetección",
    "comprar proxies para un navegador antidetección",
    "prueba de un navegador antidetección",

    # Descarga
    "descargar octo browser navegador antidetección",
    "octo browser navegador antidetección descargar",
    "octo navegador antidetección descargar",

    # Consultas de otra temática
    "reseña ford everest 2024",
    "comprar ford everest de segunda mano",

    # Ruido
    "tiempo en pattaya en mayo",
    "receta de sopa tom yum"
]
Al hacer clustering únicamente por similitud vectorial, las consultas relacionadas con navegadores antidetección pueden acabar en el mismo grupo a pesar de sus diferencias de intención.
En esta etapa, el navegador antidetección vuelve a formar parte del pipeline, pero ya no para recopilar datos semánticos, sino para obtener datos de SERP. Para cada consulta hay que recopilar los resultados de búsqueda y después utilizar la intersección de las URLs como una señal adicional para el clustering.
Cuando hay un gran número de consultas, esta recopilación puede distribuirse cómodamente entre perfiles de navegador aislados, por ejemplo, usando Octo Browser junto con Playwright o Puppeteer.
Para cada consulta se recopilan las 10 primeras URLs de los resultados de búsqueda. Después, antes de ejecutar DBSCAN, se comparan los resultados de las frases semánticamente similares. Si dos consultas no tienen URLs en común o su número está por debajo del umbral establecido, la distancia entre los vectores correspondientes se incrementa artificialmente.
De este modo, los embeddings se utilizan para encontrar consultas semánticamente similares, mientras que la SERP actúa como una restricción adicional y ayuda a evitar que se agrupen frases con diferentes intenciones de búsqueda.
Después de añadir los datos de los resultados de búsqueda, el conjunto de prueba que hemos usado antes se distribuye de otra manera:
El número de clústeres aumenta y los propios grupos se ajustan mejor a la intención de búsqueda prevista de las consultas.
Postprocesamiento de resultados y actualización de datos
Después de formar los clústeres queda una tarea práctica más: asignar un nombre claro a cada grupo. Números como “Clúster #42” son cómodos para el algoritmo, pero aportan muy poca información a un especialista SEO, editor o redactor de contenidos.
Naming automático de clústeres con un LLM
Cuando el trabajo se hace manualmente, el especialista tiene que revisar el contenido de cada grupo, determinar la intención principal y formular el nombre de la futura página o contenido. Si hay varios cientos de clústeres, esta etapa requiere mucho tiempo.
Esta parte del proceso puede automatizarse con un LLM. Al modelo se le pasa una lista de consultas de un clúster, después determina la intención general y genera un título adecuado. Puedes utilizar modelos en la nube o soluciones locales, por ejemplo Ollama.
Es importante definir de antemano un formato de respuesta estricto. Si simplemente le pides al modelo que invente un nombre, junto con el título puedes obtener explicaciones y comentarios adicionales. Por eso, en el prompt del sistema es mejor indicar explícitamente que la salida debe contener únicamente el título, sin texto adicional:
from openai import OpenAI

# 1. INICIALIZACIÓN Y CLAVE
# Introduce aquí tu clave API real
client_ai = OpenAI(api_key="sk-TU_CLAVE_DE_OPENAI")

# 2. NUESTROS DATOS (resultado del clustering híbrido)
clusters = {
    0: [
        "para qué sirven los navegadores antidetección",
        "qué es un navegador antidetección",
        "cómo funcionan los navegadores antidetección",
        "comparar navegadores antidetección"
    ],
    1: [
        "comprar un navegador antidetección",
        "comprar proxies para un navegador antidetección",
        "prueba de un navegador antidetección"
    ],
    2: [
        "descargar octo browser navegador antidetección",
        "Octo browser navegador antidetección descargar",
        "Octo navegador antidetección descargar"
    ]
}

# Prompt del sistema (definimos las reglas para el modelo)
prompt = """Eres un especialista en SEO experto. Analiza el siguiente grupo de consultas de búsqueda. Determina la intención principal del usuario y genera un único título H1 relevante para una futura página de categoría o artículo. Devuelve ÚNICAMENTE el título, sin ningún texto adicional, citas ni explicaciones."""

print("⏳ Enviando los clústeres a GPT-4o-mini para el naming automático...\n")

# 3. Recorremos todos los clústeres
for cluster_id, queries in clusters.items():
    # Enviamos las consultas del clúster actual a la API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Combinamos las consultas en un solo texto
        ],
        temperature=0.3
    )

    # Obtenemos la respuesta
    h1_title = response.choices[0].message.content

    # Mostramos el resultado en la consola
    print(f"Clúster #{cluster_id}")
    print(f"Frases: {', '.join(queries)}")
    print(f"H1 generado: {h1_title}\n")
Para el conjunto de prueba, el resultado puede ser el siguiente:
Clúster #0
   Frases: para qué sirven los navegadores antidetección, qué es un navegador antidetección, cómo funcionan los navegadores antidetección
   H1 generado: Para qué sirven los navegadores antidetección

Clúster #1
   Frases: comprar un navegador antidetección, comprar proxies para un navegador antidetección, prueba de un navegador antidetección
   H1 generado: Los mejores navegadores antidetección y proxies para una navegación segura

Clúster #2
   Frases: descargar el navegador antidetección Octo Browser, Octo Browser navegador antidetección descargar, descargar el navegador antidetección Octo
   H1 generado: Descargar el navegador antidetección Octo Browser
En un proyecto real, el número de clústeres será mucho mayor, por lo que no resulta práctico almacenar los datos originales directamente en el código. Normalmente, los clústeres se cargan desde un archivo o una base de datos, y los nombres generados se escriben de nuevo en la tabla para continuar trabajando con ellos.
En esta etapa, el LLM no participa en el propio clustering — se utiliza únicamente para el postprocesamiento de los grupos ya formados. Esto permite automatizar la parte rutinaria del trabajo y obtener una estructura clara del núcleo semántico sin tener que asignar manualmente un nombre a cada clúster.
Añadir nuevas consultas
Otra ventaja de almacenar los embeddings en ChromaDB es que puedes trabajar con nuevos datos sin volver a buscar manualmente los vecinos más cercanos en todo el conjunto.
Después de obtener una nueva porción de datos semánticos, las consultas siguen el mismo pipeline: limpieza, vectorización y adición a ChromaDB. Para cada nuevo embedding puedes encontrar las consultas existentes más cercanas y evaluar la distancia hasta ellas.
Si los vecinos encontrados pertenecen a un clúster existente estable y cumplen el umbral de similitud establecido, la nueva consulta puede añadirse a ese grupo. Si no existe un clúster adecuado, la consulta queda como candidata para formar un nuevo grupo o se envía a un procesamiento adicional.
Este enfoque permite utilizar la base de datos vectorial acumulada como índice para procesar nuevas consultas y evita realizar una búsqueda por pares completa en todo el núcleo semántico cada vez que se actualiza.
Conclusión
Crear tu propio pipeline basado en modelos de embeddings, almacenamiento vectorial y algoritmos de clustering requiere tiempo para configurarlo, probarlo y ajustar sus parámetros. Sin embargo, una vez hecho, obtienes un sistema que puedes adaptar a un tema concreto, un volumen de datos determinado y los requisitos específicos del proyecto.
Las principales ventajas de este enfoque son:
Menor dependencia de servicios especializados. No necesitas un servicio SEO independiente con planes fijos y límites de volumen para realizar el clustering. Las principales limitaciones pasan a tu propia infraestructura: recursos de cómputo, memoria y espacio en disco.
Control de la lógica del clustering. Puedes elegir el modelo de embeddings, configurar
eps, tener en cuenta los datos de SERP y cambiar las reglas para combinar consultas según la tarea.Control sobre los datos. Al utilizar modelos y almacenamiento locales, los datos semánticos permanecen dentro de tu propia infraestructura y no se envían a APIs de terceros.
El principal valor de esta solución no está en sustituir por completo las herramientas SEO existentes, sino en poder crear tu propio pipeline controlable. Utiliza Octo Browser para la recopilación automatizada de datos semánticos y SERP y realiza el resto del procesamiento localmente con embeddings, ChromaDB y algoritmos de clustering.
Una vez que hayas construido este proceso y lo hayas ajustado cuidadosamente con datos reales, dejará de ser un script puntual y se convertirá en una herramienta de trabajo que puedes reutilizar y escalar a medida que crece tu núcleo semántico.
Mantente al día de las últimas noticias sobre Octo Browser
Al hacer clic en el botón, aceptas nuestra Política de privacidad.
Mantente al día de las últimas noticias sobre Octo Browser
Al hacer clic en el botón, aceptas nuestra Política de privacidad.
Mantente al día de las últimas noticias sobre Octo Browser
Al hacer clic en el botón, aceptas nuestra Política de privacidad.
Únete a Octo Browser ahora
O contacta al servicio al cliente en cualquier momento si tienes alguna pregunta.
Únete a Octo Browser ahora
O contacta al servicio al cliente en cualquier momento si tienes alguna pregunta.
Únete a Octo Browser ahora
O contacta al servicio al cliente en cualquier momento si tienes alguna pregunta.