Векторная кластеризация поисковых запросов: строим свою систему на ChromaDB, Embeddings и Python


Markus_automation
Expert in data parsing and automation
Кластеризация — один из самых трудоемких этапов работы с семантикой. Собрать и очистить пул запросов относительно просто, а вот правильно распределить тысячи ключей по кластерам (группам) с одинаковым поисковым интентом уже значительно сложнее.
Программы-кластеризаторы, вроде Rush Analytics, Key.so и Key Collector, упрощают задачу, но имеют ограничения по объему, настройкам и качеству результатов. Особенно это заметно в сложных нишах, где автоматические алгоритмы могут объединять запросы с разным интентом или разделять близкие по смыслу фразы.
Нейросетевой подход позволяет решить эту задачу иначе. Вместо сравнения отдельных слов и лексических совпадений запросы преобразуются в многомерные векторы — embeddings. Их можно сравнивать по семантической близости и на этой основе автоматически формировать кластеры.
В этой статье разберем, как построить собственный масштабируемый пайплайн кластеризации на локальном компьютере или сервере — от автоматизированного сбора семантики и SERP-данных с помощью антидетект-браузера до векторизации, группировки и постобработки результатов.
Содержание
Сохраняйте анонимность с Octo Browser, ведь отследить ваш реальный цифровой отпечаток невозможно.
Хотите попробовать Octo Browser со скидкой?
По промокоду OCTOBLOG получите 30% скидку на любую подписку. Предложение действительно только для новых пользователей.
Сбор семантики
На этапе сбора семантики можно использовать несколько подходов, однако базовый процесс обычно строится по одной схеме: сначала формируется исходный пул запросов через сервисы вроде Google Ads Keyword Planner и других инструментов, предоставляющих данные о популярности поисковых запросов в нужной тематике.
После этого исходный набор расширяется за счет связанных запросов, поисковых подсказок и дополнительных источников семантики. Ранее для подобных задач часто использовался Key Collector, однако сегодня на практике нередко приходится комбинировать несколько инструментов либо использовать собственные скрипты для сбора данных.
Использование инструментов автоматизации для сбора семантики
Если коммерческие решения не подходят по стоимости, функциональности или ограничениям, сбор части семантики можно автоматизировать самостоятельно. Например, для получения поисковых подсказок и других данных из веб-интерфейсов можно использовать headless-браузеры на базе Puppeteer или Playwright.
Если вы собираете семантику на большом количестве параллельных сессий, вам нужно безопасно управлять браузерными профилями и их окружением. Здесь можно использовать антидетект-браузер, например Octo Browser, чтобы разделять сессии, управлять параметрами профилей и подключать разные прокси. Это упрощает инфраструктуру парсинга и снижает количество ручной настройки на уровне каждого отдельного браузерного экземпляра.
Основная сложность при массовом сборе данных заключается в ограничениях со стороны поисковых систем. Автоматизированные запросы могут попадать под rate limit, CAPTCHA или другие механизмы защиты, поэтому при проектировании такого пайплайна необходимо учитывать стабильность сессий, частоту запросов и обработку временных блокировок.
При работе через браузерную автоматизацию также важно контролировать параметры окружения: User-Agent, размер окна, локаль, WebGL и другие характеристики браузерной сессии. Для этого можно использовать собственную конфигурацию Puppeteer или Playwright либо специализированные браузерные решения, которые позволяют создавать изолированные профили с разными параметрами окружения.
Отдельная задача — организация сетевой инфраструктуры. Для распределенного сбора данных могут использоваться прокси разных типов: серверные, резидентные или мобильные. Выбор зависит от объема запросов, требований к стабильности, скорости и стоимости. Серверные прокси обычно дешевле и быстрее, однако в некоторых сценариях чаще попадают под ограничения. Резидентные и мобильные адреса, как правило, устойчивее, но обходятся дороже и имеют меньшую пропускную способность.
После завершения основного сбора вы можете дополнить итоговый список запросов данными из внешних баз семантики. На выходе должен получиться максимально полный набор запросов, который затем можно передавать на этап очистки, нормализации и дальнейшей кластеризации.
Очистка данных перед векторизацией
После сбора семантики вы получите файл с десятками тысяч поисковых запросов. На первый взгляд его уже можно передавать на этап векторизации и кластеризации, однако качество результата во многом зависит от предварительной подготовки данных.
На этом этапе удобно использовать библиотеки Pandas и NumPy для очистки и нормализации входного набора. Сырой список запросов почти всегда содержит дубли, лишние символы, технический мусор, нерелевантные фразы и другие артефакты, появившиеся в процессе парсинга и объединения нескольких источников.
Для embedding-модели такие строки все равно будут преобразованы в векторы, но это создаст лишнюю вычислительную нагрузку и может ухудшить структуру итоговых кластеров. Поэтому перед векторизацией данные желательно привести к единому и предсказуемому формату.
Основные этапы подготовки выглядят следующим образом:
Очистка от технического мусора. Удаляются HTML-теги, лишние пробелы, невидимые символы, эмодзи и другие элементы, которые могли попасть в данные при парсинге.
Глобальная дедупликация. При объединении запросов из нескольких источников пересечения практически неизбежны. Повторно векторизовать идентичные строки нет смысла, поэтому полные дубли лучше удалить заранее.
Фильтрация по стоп-словам. На этом этапе можно исключить запросы с нерелевантной топонимикой, нежелательными маркерами или словами, не соответствующими задаче проекта. Например, для коммерческой семантики это могут быть запросы со словами «бесплатно», «торрент» и аналогичными модификаторами.
Приводить слова к словарной форме (лемме) — необязательно. Современные модели хорошо понимают разные формы одного слова. Например, они видят, что «купить айфон» и «куплю айфон» — почти один и тот же запрос. Поэтому специально менять слова перед обработкой не нужно. Но простая предварительная обработка может помочь найти похожие запросы и уменьшить объем данных.
В результате должен получиться очищенный и отфильтрованный набор уникальных запросов без очевидного технического шума. После этого данные можно передавать на следующий этап — преобразование текста в векторные представления.
Векторизация поисковых запросов
Векторная кластеризация отличается от классического сравнения строк тем, что работает не с точными совпадениями слов, а с их семантическим представлением. Каждый поисковый запрос преобразуется в числовой вектор — embedding, который кодирует его смысловые характеристики.
Для этого используются специализированные embedding-модели. Текст сначала разбивается на токены, после чего модель формирует вектор фиксированной размерности. В результате семантически близкие запросы располагаются ближе друг к другу в векторном пространстве.
Например, фразы «купить айфон 15» и «цена iphone 15 pro» будут иметь более близкие векторы, чем «купить айфон 15» и «ремонт телефонов apple». Именно это свойство в дальнейшем позволяет использовать алгоритмы кластеризации для группировки запросов.
Коммерческие решения (OpenAI, Claude)
Для векторизации можно использовать как облачные API, так и локальные модели. Выбор зависит от объема данных, требований к качеству, доступной инфраструктуры и допустимой стоимости обработки.
Коммерческие API удобны тем, что не требуют локального развертывания модели и позволяют быстро начать работу. Провайдер берет на себя инфраструктуру, обновление моделей и масштабирование вычислений.
При небольших и средних объемах данных это один из наиболее простых вариантов. Однако при обработке сотен тысяч или миллионов запросов необходимо учитывать стоимость API, ограничения на количество запросов и пропускную способность.
К тому же при работе с API требуется использование отказоустойчивой архитектуры (обход лимитов API с помощью мультиаккаунтинга, ротация ключей и применение асинхронных запросов через aiohttp).
Вы можете самостоятельно протестировать, как коммерческие нейросети работают с ключами, с помощью этого кода.
import os
from openai import OpenAI

# Инициализация клиента
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Наш сырой датасет
queries = ["купить айфон 15", "цена iphone 15 pro", "ремонт телефонов apple"]

# 1. Векторизуем запросы через OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# На выходе получаем готовые многомерные векторы
embeddings = [data.embedding for data in response.data]
import os
from openai import OpenAI

# Инициализация клиента
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Наш сырой датасет
queries = ["купить айфон 15", "цена iphone 15 pro", "ремонт телефонов apple"]

# 1. Векторизуем запросы через OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# На выходе получаем готовые многомерные векторы
embeddings = [data.embedding for data in response.data]
Локальные модели из экосистемы Hugging Face
Альтернативой коммерческим API могут быть открытые embedding-модели, которые запускаются локально. Для мультиязычных задач можно использовать, например, jinaai/jina-embeddings-v3 или Alibaba-NLP/gte-multilingual-large, которые не требуют затрат на генерацию.
from sentence_transformers import SentenceTransformer

print("⏳ 1. Загрузка стабильной модели BGE-m3...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["купить айфон 15", "цена iphone 15 pro", "ремонт телефонов apple"]

print(f"⏳ 2. Векторизуем {len(queries)} запросов...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Готово! Давайте посмотрим на результат:")
print(f"📊 Размерность данных: {embeddings.shape}")
print("🔍 Вектор для фразы 'купить айфон 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... и еще {len(embeddings[0]) - 5} чисел.")
from sentence_transformers import SentenceTransformer

print("⏳ 1. Загрузка стабильной модели BGE-m3...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["купить айфон 15", "цена iphone 15 pro", "ремонт телефонов apple"]

print(f"⏳ 2. Векторизуем {len(queries)} запросов...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Готово! Давайте посмотрим на результат:")
print(f"📊 Размерность данных: {embeddings.shape}")
print("🔍 Вектор для фразы 'купить айфон 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... и еще {len(embeddings[0]) - 5} чисел.")
Главное преимущество локальных моделей заключается в том, что весь процесс обработки остается внутри собственной инфраструктуры. Вы обрабатываете поисковые запросы без передачи стороннему API, а после загрузки модели можете векторизовать их без оплаты каждого запроса.
Работать с локальными моделями часто оказывается выгоднее: они позволяют выполнять векторизацию без оплаты каждого обращения к API. Но при этом требуют заметного объема дискового пространства: вместе с весами и кэшем могут загружаться файлы размером в несколько гигабайт. Если модель больше не нужна, после завершения работы стоит удалить ее локальные файлы и очистить кэш.
Хранение и поиск векторных представлений
После векторизации каждый поисковый запрос представлен в виде embedding-вектора. Следующий вопрос — где хранить эти данные и как эффективно находить семантически близкие запросы.
Для небольших наборов данных векторы можно оставить в памяти, например в массивах NumPy или структурах Pandas. Если запросов всего несколько тысяч, этого обычно достаточно для экспериментов и локальной обработки.
С ростом датасета ситуация меняется. Если сравнивать каждый вектор со всеми остальными напрямую, количество операций растет квадратично. Для десятков и сотен тысяч запросов такой подход быстро становится ресурсоемким как по времени вычислений, так и по использованию памяти.
Эта проблема решается через векторные базы данных. Они оптимизированы специально под такие задачи и поддерживают алгоритмы приближенного поиска ближайших соседей (в частности, алгоритм HNSW). Встроенные индексы позволяют не сравнивать все векторы друг с другом напрямую, а обеспечивают практически мгновенный поиск самых похожих фраз даже среди миллионов записей.
Для таких задач существует несколько популярных решений: Pinecone, Qdrant, PostgreSQL с расширением pgvector и другие. В нашем примере будем использовать ChromaDB. Она хорошо подходит для локальных экспериментов: запускается без отдельного сервера, сохраняет данные на диск и легко интегрируется с Python-кодом.
Сохраним embeddings, полученные на предыдущем этапе, и проверим, как работает смысловой поиск:
import chromadb

# 1. Инициализация локальной базы (создаст папку semantic_db)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Создаем коллекцию
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Загружаем наши векторы и тексты запросов
collection.add(
    embeddings=embeddings.tolist(), # векторы от нашей локальной модели BGE-m3
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Данные сохранены в БД!\n")

# ==========================================
# МАГИЯ ПОИСКА: Проверяем, как база понимает смысл
# ==========================================
test_phrase = "сколько стоит новый iphone"
print(f"Ищем в базе фразу: '{test_phrase}'")

# Превращаем тестовую фразу в вектор той же моделью
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Просим базу найти два самых похожих варианта
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Ближайший запрос: {results['documents'][0][0]} (Дистанция: {results['distances'][0][0]:.4f})")
print(f"Второй по близости: {results['documents'][0][1]} (Дистанция: {results['distances'][0][1]:.4f})")
import chromadb

# 1. Инициализация локальной базы (создаст папку semantic_db)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Создаем коллекцию
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Загружаем наши векторы и тексты запросов
collection.add(
    embeddings=embeddings.tolist(), # векторы от нашей локальной модели BGE-m3
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Данные сохранены в БД!\n")

# ==========================================
# МАГИЯ ПОИСКА: Проверяем, как база понимает смысл
# ==========================================
test_phrase = "сколько стоит новый iphone"
print(f"Ищем в базе фразу: '{test_phrase}'")

# Превращаем тестовую фразу в вектор той же моделью
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Просим базу найти два самых похожих варианта
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Ближайший запрос: {results['documents'][0][0]} (Дистанция: {results['distances'][0][0]:.4f})")
print(f"Второй по близости: {results['documents'][0][1]} (Дистанция: {results['distances'][0][1]:.4f})")
Выбор алгоритма кластеризации
После получения embedding-векторов можно переходить к следующему этапу — группировке поисковых запросов. На этом шаге важно выбрать алгоритм, который соответствует структуре данных и не требует слишком жестких предположений о количестве будущих кластеров.
Почему K-Means не всегда подходит для SEO-кластеризации
K-Means — классический алгоритм кластеризации, который разбивает данные на заранее заданное количество групп. Количество кластеров задается параметром k.
Например, если у нас есть 10 000 поисковых запросов и мы укажем k=500, алгоритм сформирует 500 центроидов и распределит каждый запрос по ближайшему из них в векторном пространстве.
Основное ограничение такого подхода заключается в том, что количество кластеров необходимо определить заранее. Для семантического ядра это не всегда удобно: до начала обработки сложно понять, сколько самостоятельных групп интентов содержится в наборе — 50, 500 или 1 200.
Если значение k выбрано неудачно, связанные запросы могут оказаться разделены между несколькими группами. Возможна и обратная ситуация, когда близкие по тематике, но различающиеся по интенту запросы объединяются только потому, что алгоритм должен сформировать заданное количество кластеров.
Кластеризация с помощью DBSCAN
Если количество групп заранее неизвестно, можно использовать алгоритмы кластеризации на основе плотности. Один из наиболее известных вариантов — DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
В отличие от K-Means, DBSCAN не требует заранее задавать количество кластеров. Алгоритм ищет области в пространстве векторов, где объекты расположены достаточно близко друг к другу, и формирует из них группы.
Поведение DBSCAN определяется двумя основными параметрами:
eps(эпсилон/дистанция): максимальное расстояние между точками, при котором они считаются соседями. В нашем случае это порог косинусного сходства векторов.min_samples: минимальное количество соседей, чтобы образовать полноценный кластер.
DBSCAN берет первый случайный запрос. Если в радиусе eps от него есть min_samples других запросов, образуется ядро кластера. Алгоритм начинает расти во все стороны, захватывая новых соседей, пока плотность не иссякнет.
Параметр eps можно условно сравнить с настройкой жесткости кластеризации:
Меньший
epsсоответствует более строгой группировке. В один кластер будут попадать только очень близкие по векторному представлению запросы, поэтому групп обычно получается больше, а сами они становятся компактнее.Больший
epsделает условия объединения мягче. Кластеры становятся крупнее и могут включать более широкую семантику, но одновременно возрастает риск объединения запросов с различающимся интентом.
Еще одно полезное свойство DBSCAN — возможность выделять шум. Если запрос не находится в достаточно плотной области векторного пространства, алгоритм не пытается принудительно отнести его к одному из существующих кластеров, а помечает их как Outliers. Вы можете выгрузить их в отдельный файл для ручной проверки, вместо того чтобы портить чистые посадочные страницы.
При этом DBSCAN чувствителен к выбору eps: единый порог не всегда хорошо работает с данными, в которых одни группы расположены очень плотно, а другие значительно более разрежены.
В таких случаях можно рассмотреть HDBSCAN — иерархическое развитие плотностного подхода. Он умеет находить кластеры разной плотности, самостоятельно подстраивая параметр eps там, где запросы лежат кучнее или, наоборот, более разреженно.
Пишем скрипт кластеризации
Давайте извлечем наши векторы из локальной базы ChromaDB и прогоним их через DBSCAN с помощью библиотеки scikit-learn:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Подключаемся к векторной базе...")
client = chromadb.PersistentClient(path="./semantic_db")

# Извлекаем коллекцию с векторами (укажите свое название)
collection = client.get_collection(name="search_queries")

# Извлекаем все тексты запросов и их математические векторы
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Извлечено запросов из базы: {len(documents)}")

# ==========================================
# КЛАСТЕРИЗАЦИЯ (DBSCAN)
# ==========================================
print("⏳ 2. Запускаем алгоритм DBSCAN...")

# НАСТРОЙКИ:
# eps = 0.15 (Допустимое косинусное расстояние. Чем меньше, тем жестче кластеры);
# min_samples = 2 (Минимум 2 запроса для создания группы);
# metric="cosine" (Обязательно указываем, что измеряем углы между векторами, а не линейное расстояние).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Запускаем группировку
labels = dbscan.fit_predict(embeddings)

# ==========================================
# ВЫВОД РЕЗУЛЬТАТОВ
# ==========================================
# Алгоритм присвоил каждому запросу номер группы (0, 1, 2...).
# Если запрос признан мусорным (Outlier), он получает метку -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== РЕЗУЛЬТАТЫ ГРУППИРОВКИ ===")
for cluster_id, docs in clusters.items():
    print(f"\n Кластер #{cluster_id} (Запросов: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Выбросы/Шум (Запросов: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Подключаемся к векторной базе...")
client = chromadb.PersistentClient(path="./semantic_db")

# Извлекаем коллекцию с векторами (укажите свое название)
collection = client.get_collection(name="search_queries")

# Извлекаем все тексты запросов и их математические векторы
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Извлечено запросов из базы: {len(documents)}")

# ==========================================
# КЛАСТЕРИЗАЦИЯ (DBSCAN)
# ==========================================
print("⏳ 2. Запускаем алгоритм DBSCAN...")

# НАСТРОЙКИ:
# eps = 0.15 (Допустимое косинусное расстояние. Чем меньше, тем жестче кластеры);
# min_samples = 2 (Минимум 2 запроса для создания группы);
# metric="cosine" (Обязательно указываем, что измеряем углы между векторами, а не линейное расстояние).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Запускаем группировку
labels = dbscan.fit_predict(embeddings)

# ==========================================
# ВЫВОД РЕЗУЛЬТАТОВ
# ==========================================
# Алгоритм присвоил каждому запросу номер группы (0, 1, 2...).
# Если запрос признан мусорным (Outlier), он получает метку -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== РЕЗУЛЬТАТЫ ГРУППИРОВКИ ===")
for cluster_id, docs in clusters.items():
    print(f"\n Кластер #{cluster_id} (Запросов: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Выбросы/Шум (Запросов: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
В примере выше используется локальная модель, однако при работе с коммерческими embedding-моделями значение eps может потребовать дополнительной настройки. В частности, порог 0.15, подходящий для одной модели, в другой конфигурации может привести к тому, что значительная часть запросов объединится в один крупный кластер или будет некорректно отнесена к шуму.
Поэтому при смене модели значение eps необходимо подбирать отдельно, ориентируясь на распределение расстояний между векторами и фактическое качество получаемых групп.
Гибридная кластеризация для разделения поискового интента
Кластеризацию можно строить только на основе embedding-векторов, однако на практике этого часто недостаточно. Семантическая близость не всегда означает совпадение поискового интента.
Например, запросы «купить антидетект-браузер» и «что такое антидетект-браузер» тематически очень близки. Embedding-модель корректно распознает, что обе фразы относятся к одному объекту, поэтому расстояние между их векторами будет небольшим. В результате DBSCAN с высокой вероятностью отнесет такие запросы к одному кластеру.
С точки зрения SEO это нежелательно, поскольку интент у запросов различается. Первый предполагает коммерческую посадочную страницу, второй — информационный материал.
Покажем это на небольшом тестовом наборе:
queries = [
    # Информационные
    "зачем нужны антидетект-браузеры",
    "что такое антидетект-браузер",
    "работа антидетект-браузеров",
    "сравнение антидетект-браузеров habr",

    # Коммерческие
    "купить антидетект-браузер",
    "купить прокси для антидетект-браузера",
    "антидетект-браузер триал",

    # Скачивание
    "скачать антидетект-браузер octo browser",
    "octo browser антидетект-браузер скачать",
    "octo антидетект-браузер скачать",

    # Запросы другой тематики
    "обзор ford everest 2024",
    "купить ford everest с пробегом",

    # Шум
    "погода в паттайе на май",
    "рецепт супа том ям"
]
queries = [
    # Информационные
    "зачем нужны антидетект-браузеры",
    "что такое антидетект-браузер",
    "работа антидетект-браузеров",
    "сравнение антидетект-браузеров habr",

    # Коммерческие
    "купить антидетект-браузер",
    "купить прокси для антидетект-браузера",
    "антидетект-браузер триал",

    # Скачивание
    "скачать антидетект-браузер octo browser",
    "octo browser антидетект-браузер скачать",
    "octo антидетект-браузер скачать",

    # Запросы другой тематики
    "обзор ford everest 2024",
    "купить ford everest с пробегом",

    # Шум
    "погода в паттайе на май",
    "рецепт супа том ям"
]
При кластеризации только по векторной близости запросы, связанные с антидетект-браузерами, могут оказаться в одной группе, несмотря на различия в интенте.
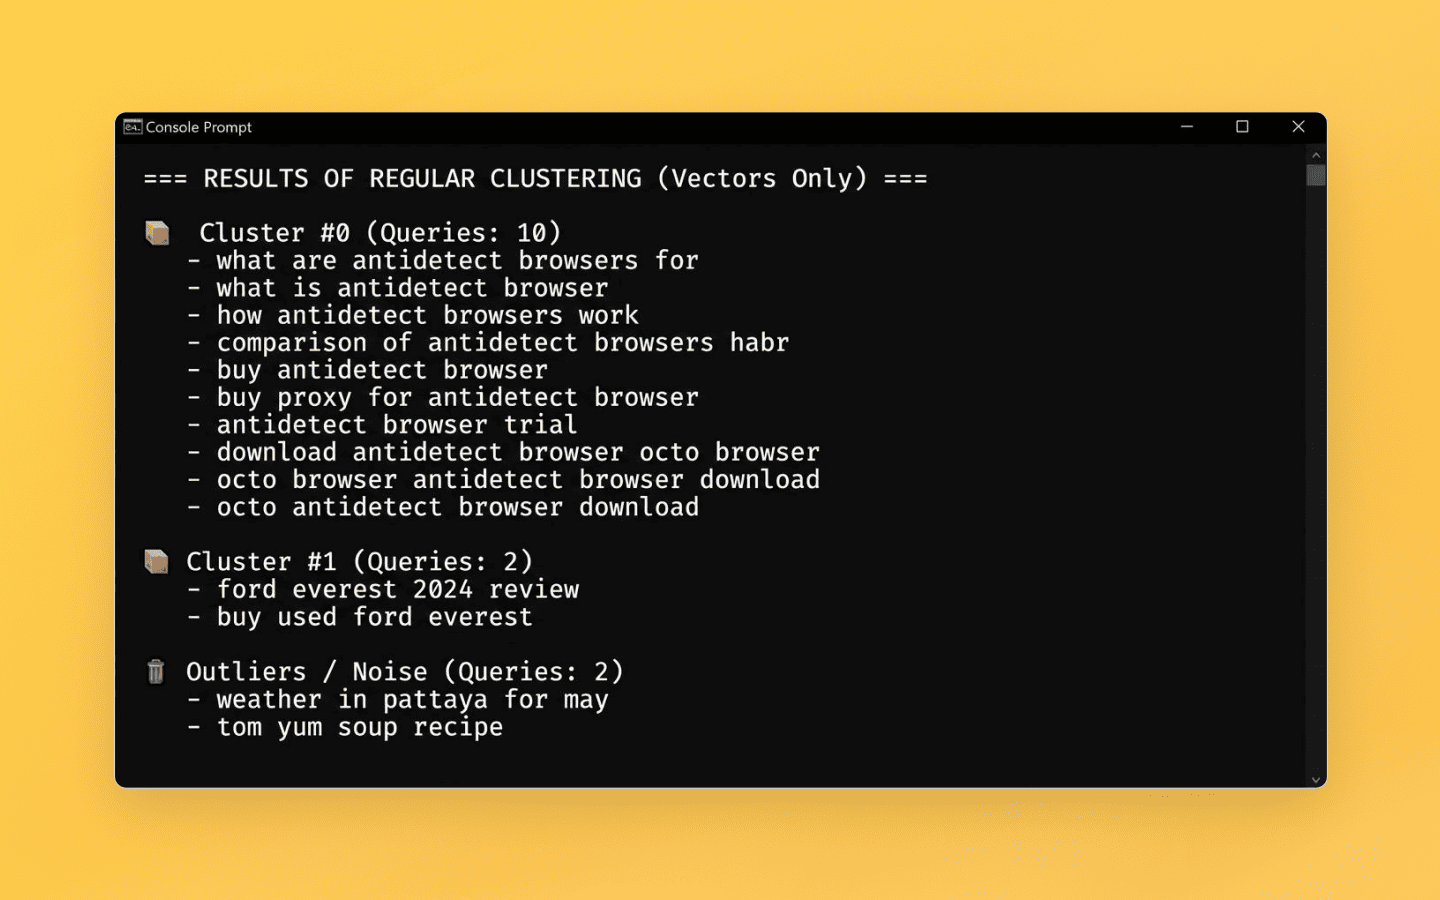
На этом этапе антидетект-браузер снова становится частью пайплайна, но уже не для сбора семантики, а для получения SERP-данных. По каждому запросу необходимо собрать результаты поисковой выдачи, а затем использовать пересечение URL как дополнительный сигнал при кластеризации.
При большом количестве запросов такой сбор удобно распределять между изолированными браузерными профилями, например через Octo Browser в связке с Playwright или Puppeteer.

Для каждого запроса собирается топ-10 URL из поисковой выдачи. Затем перед запуском DBSCAN сравниваются результаты для семантически близких фраз. Если у двух запросов отсутствуют общие URL либо их количество ниже заданного порога, расстояние между соответствующими векторами искусственно увеличивается.
Таким образом, embeddings используются для поиска семантически близких запросов, а SERP выступает дополнительным ограничением и помогает не объединять фразы с различающимся поисковым интентом.
После добавления данных поисковой выдачи тестовый набор из предыдущего примера распределяется иначе:
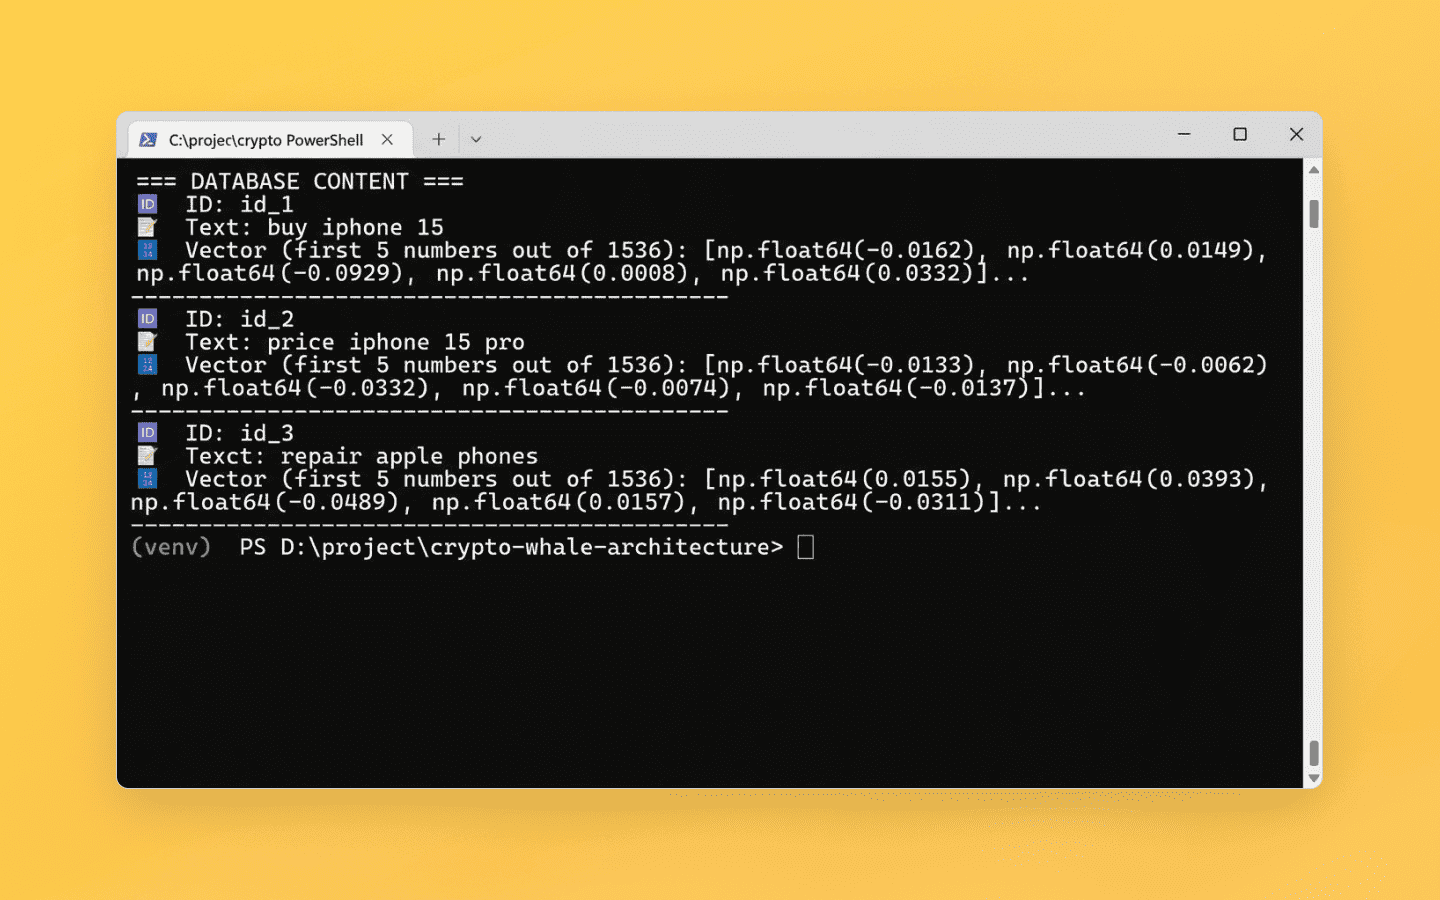
Количество кластеров увеличивается, а сами группы лучше соответствуют предполагаемому интенту запросов.
Постобработка результатов и обновление данных
После формирования кластеров остается еще одна практическая задача — присвоить каждой группе понятное название. Номера вида «Кластер # 42» удобны для алгоритма, но мало что говорят SEO-специалисту, редактору или автору контента.
Автоматический нейминг кластеров с помощью LLM
При ручной работе специалисту приходится просматривать содержимое каждой группы, определять основной интент и формулировать название будущей страницы или материала. Если кластеров несколько сотен, этот этап занимает значительное время.
Эту часть процесса можно автоматизировать с помощью LLM. На вход модели передается список запросов из одного кластера, после чего она определяет общий интент и формирует подходящий заголовок. Для этого можно использовать как облачные модели, так и локальные решения, запускаемые, например, через Ollama.
Важно заранее задать модели строгий формат ответа. Если просто попросить ее придумать название, вместе с заголовком можно получить дополнительные пояснения и комментарии. Поэтому в системном промпте лучше явно указать, что на выходе должен быть только заголовок без дополнительного текста:
from openai import OpenAI

# 1. ИНИЦИАЛИЗАЦИЯ И КЛЮЧ
# Вставьте сюда ваш реальный ключ API
client_ai = OpenAI(api_key="sk-ВАШ_КЛЮЧ_ОТ_OPENAI")

# 2. НАШИ ДАННЫЕ (Результат гибридной кластеризации)
clusters = {
    0: [
        "зачем нужны антидетект-браузеры",
        "что такое антидетект-браузер",
        "работа антидетект-браузеров",
        "сравнение антидетект-браузеров habr"
    ],
    1: [
        "купить антидетект-браузер",
        "купить прокси для антидетект-браузера",
        "антидетект-браузер триал"
    ],
    2: [
        "скачать антидетект-браузер octo browser",
        "Octo browser антидетект-браузер скачать",
        "Octo антидетект-браузер скачать"
    ]
}

# Системный промпт (задаем правила для нейросети)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Отправляем кластеры на автонейминг в GPT-4o-mini...\n")

# 3. Проходимся по всем кластерам
for cluster_id, queries in clusters.items():
    # Отправляем запросы текущего кластера в API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Объединяем запросы в один текст
        ],
        temperature=0.3
    )

    # Получаем ответ
    h1_title = response.choices[0].message.content

    # Выводим результат в консоль
    print(f"Кластер #{cluster_id}")
    print(f"Фразы: {', '.join(queries)}")
    print(f"Сгенерированный H1: {h1_title}\n")
from openai import OpenAI

# 1. ИНИЦИАЛИЗАЦИЯ И КЛЮЧ
# Вставьте сюда ваш реальный ключ API
client_ai = OpenAI(api_key="sk-ВАШ_КЛЮЧ_ОТ_OPENAI")

# 2. НАШИ ДАННЫЕ (Результат гибридной кластеризации)
clusters = {
    0: [
        "зачем нужны антидетект-браузеры",
        "что такое антидетект-браузер",
        "работа антидетект-браузеров",
        "сравнение антидетект-браузеров habr"
    ],
    1: [
        "купить антидетект-браузер",
        "купить прокси для антидетект-браузера",
        "антидетект-браузер триал"
    ],
    2: [
        "скачать антидетект-браузер octo browser",
        "Octo browser антидетект-браузер скачать",
        "Octo антидетект-браузер скачать"
    ]
}

# Системный промпт (задаем правила для нейросети)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Отправляем кластеры на автонейминг в GPT-4o-mini...\n")

# 3. Проходимся по всем кластерам
for cluster_id, queries in clusters.items():
    # Отправляем запросы текущего кластера в API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Объединяем запросы в один текст
        ],
        temperature=0.3
    )

    # Получаем ответ
    h1_title = response.choices[0].message.content

    # Выводим результат в консоль
    print(f"Кластер #{cluster_id}")
    print(f"Фразы: {', '.join(queries)}")
    print(f"Сгенерированный H1: {h1_title}\n")
Для тестового набора результат может выглядеть следующим образом:
Кластер #0
   Фразы: зачем нужны антидетект-браузеры, что такое антидетект- браузер, работа антидетект-браузеров
   Сгенерированный H1: Для чего нужны антидетект-браузеры

Кластер #1
   Фразы: купить антидетект-браузер, купить прокси для антидетект- браузера, антидетект-браузер триал
   Сгенерированный H1: Лучшие антидетект-браузеры и прокси для безопасного серфинга

Кластер #2
   Фразы: скачать антидетект-браузер octo browser, Octo browser антидетект-браузер скачать, Octo антидетект-браузер скачать
   Сгенерированный H1: Скачать антидетект-браузер Octo Browser
Кластер #0
   Фразы: зачем нужны антидетект-браузеры, что такое антидетект- браузер, работа антидетект-браузеров
   Сгенерированный H1: Для чего нужны антидетект-браузеры

Кластер #1
   Фразы: купить антидетект-браузер, купить прокси для антидетект- браузера, антидетект-браузер триал
   Сгенерированный H1: Лучшие антидетект-браузеры и прокси для безопасного серфинга

Кластер #2
   Фразы: скачать антидетект-браузер octo browser, Octo browser антидетект-браузер скачать, Octo антидетект-браузер скачать
   Сгенерированный H1: Скачать антидетект-браузер Octo Browser
В реальном проекте количество кластеров будет значительно больше, поэтому хранить исходные данные непосредственно в коде нецелесообразно. Обычно кластеры загружаются из файла или базы данных, а сгенерированные названия записываются обратно в таблицу для дальнейшей работы.
На этом этапе LLM не участвует в самой кластеризации — она используется только для постобработки уже сформированных групп. Это позволяет автоматизировать рутинную часть работы и получить понятную структуру семантического ядра без ручного нейминга каждого кластера.
Добавление новых запросов
Еще одно преимущество хранения embeddings в ChromaDB — возможность работать с новыми данными без повторного поиска ближайших соседей по всему набору вручную.
После получения новой порции семантики запросы проходят тот же пайплайн: очистку, векторизацию и добавление в ChromaDB. Для каждого нового embedding можно найти ближайшие существующие запросы и оценить расстояние до них.
Если найденные соседи относятся к устойчивому существующему кластеру и удовлетворяют заданному порогу близости, новый запрос можно присоединить к этой группе. Если подходящего кластера нет, запрос остается кандидатом на формирование новой группы или отправляется на дополнительную обработку.
Такой подход позволяет использовать уже накопленную векторную базу как индекс для обработки новых запросов и не выполнять полный попарный поиск по всему семантическому ядру при каждом обновлении.
Заключение
Создание собственного пайплайна на базе embedding-моделей, векторного хранилища и алгоритмов кластеризации требует времени на настройку, тестирование и подбор параметров. Однако после этого вы получаете систему, которую можно адаптировать под конкретную тематику, объем данных и требования проекта.
Основные преимущества такого подхода:
Снижение зависимости от специализированных сервисов. Для кластеризации не требуется отдельный SEO-сервис с фиксированными тарифами и ограничениями по объему. Основные ограничения переносятся на собственную инфраструктуру: вычислительные ресурсы, память и дисковое пространство.
Контроль над логикой кластеризации. Можно самостоятельно выбирать embedding-модель, настраивать
eps, учитывать данные SERP и изменять правила объединения запросов в зависимости от задачи.Контроль над данными. При использовании локальных моделей и локального хранилища семантика остается внутри собственной инфраструктуры и не передается сторонним API.
Главная ценность такого решения — не в полной замене готовых SEO-инструментов, а в возможности собрать собственный управляемый пайплайн. Используйте Octo Browser на этапе автоматизированного сбора семантики и SERP-данных, а дальнейшую обработку выполняйте локально — с помощью embeddings, ChromaDB и алгоритмов кластеризации.
Если один раз выстроить этот процесс и аккуратно настроить его на реальных данных, он превращается из разового скрипта в рабочий инструмент, который можно повторно использовать и масштабировать вместе с ростом семантического ядра.
Сохраняйте анонимность с Octo Browser, ведь отследить ваш реальный цифровой отпечаток невозможно.
Хотите попробовать Octo Browser со скидкой?
По промокоду OCTOBLOG получите 30% скидку на любую подписку. Предложение действительно только для новых пользователей.
Сбор семантики
На этапе сбора семантики можно использовать несколько подходов, однако базовый процесс обычно строится по одной схеме: сначала формируется исходный пул запросов через сервисы вроде Google Ads Keyword Planner и других инструментов, предоставляющих данные о популярности поисковых запросов в нужной тематике.
После этого исходный набор расширяется за счет связанных запросов, поисковых подсказок и дополнительных источников семантики. Ранее для подобных задач часто использовался Key Collector, однако сегодня на практике нередко приходится комбинировать несколько инструментов либо использовать собственные скрипты для сбора данных.
Использование инструментов автоматизации для сбора семантики
Если коммерческие решения не подходят по стоимости, функциональности или ограничениям, сбор части семантики можно автоматизировать самостоятельно. Например, для получения поисковых подсказок и других данных из веб-интерфейсов можно использовать headless-браузеры на базе Puppeteer или Playwright.
Если вы собираете семантику на большом количестве параллельных сессий, вам нужно безопасно управлять браузерными профилями и их окружением. Здесь можно использовать антидетект-браузер, например Octo Browser, чтобы разделять сессии, управлять параметрами профилей и подключать разные прокси. Это упрощает инфраструктуру парсинга и снижает количество ручной настройки на уровне каждого отдельного браузерного экземпляра.
Основная сложность при массовом сборе данных заключается в ограничениях со стороны поисковых систем. Автоматизированные запросы могут попадать под rate limit, CAPTCHA или другие механизмы защиты, поэтому при проектировании такого пайплайна необходимо учитывать стабильность сессий, частоту запросов и обработку временных блокировок.
При работе через браузерную автоматизацию также важно контролировать параметры окружения: User-Agent, размер окна, локаль, WebGL и другие характеристики браузерной сессии. Для этого можно использовать собственную конфигурацию Puppeteer или Playwright либо специализированные браузерные решения, которые позволяют создавать изолированные профили с разными параметрами окружения.
Отдельная задача — организация сетевой инфраструктуры. Для распределенного сбора данных могут использоваться прокси разных типов: серверные, резидентные или мобильные. Выбор зависит от объема запросов, требований к стабильности, скорости и стоимости. Серверные прокси обычно дешевле и быстрее, однако в некоторых сценариях чаще попадают под ограничения. Резидентные и мобильные адреса, как правило, устойчивее, но обходятся дороже и имеют меньшую пропускную способность.
После завершения основного сбора вы можете дополнить итоговый список запросов данными из внешних баз семантики. На выходе должен получиться максимально полный набор запросов, который затем можно передавать на этап очистки, нормализации и дальнейшей кластеризации.
Очистка данных перед векторизацией
После сбора семантики вы получите файл с десятками тысяч поисковых запросов. На первый взгляд его уже можно передавать на этап векторизации и кластеризации, однако качество результата во многом зависит от предварительной подготовки данных.
На этом этапе удобно использовать библиотеки Pandas и NumPy для очистки и нормализации входного набора. Сырой список запросов почти всегда содержит дубли, лишние символы, технический мусор, нерелевантные фразы и другие артефакты, появившиеся в процессе парсинга и объединения нескольких источников.
Для embedding-модели такие строки все равно будут преобразованы в векторы, но это создаст лишнюю вычислительную нагрузку и может ухудшить структуру итоговых кластеров. Поэтому перед векторизацией данные желательно привести к единому и предсказуемому формату.
Основные этапы подготовки выглядят следующим образом:
Очистка от технического мусора. Удаляются HTML-теги, лишние пробелы, невидимые символы, эмодзи и другие элементы, которые могли попасть в данные при парсинге.
Глобальная дедупликация. При объединении запросов из нескольких источников пересечения практически неизбежны. Повторно векторизовать идентичные строки нет смысла, поэтому полные дубли лучше удалить заранее.
Фильтрация по стоп-словам. На этом этапе можно исключить запросы с нерелевантной топонимикой, нежелательными маркерами или словами, не соответствующими задаче проекта. Например, для коммерческой семантики это могут быть запросы со словами «бесплатно», «торрент» и аналогичными модификаторами.
Приводить слова к словарной форме (лемме) — необязательно. Современные модели хорошо понимают разные формы одного слова. Например, они видят, что «купить айфон» и «куплю айфон» — почти один и тот же запрос. Поэтому специально менять слова перед обработкой не нужно. Но простая предварительная обработка может помочь найти похожие запросы и уменьшить объем данных.
В результате должен получиться очищенный и отфильтрованный набор уникальных запросов без очевидного технического шума. После этого данные можно передавать на следующий этап — преобразование текста в векторные представления.
Векторизация поисковых запросов
Векторная кластеризация отличается от классического сравнения строк тем, что работает не с точными совпадениями слов, а с их семантическим представлением. Каждый поисковый запрос преобразуется в числовой вектор — embedding, который кодирует его смысловые характеристики.
Для этого используются специализированные embedding-модели. Текст сначала разбивается на токены, после чего модель формирует вектор фиксированной размерности. В результате семантически близкие запросы располагаются ближе друг к другу в векторном пространстве.
Например, фразы «купить айфон 15» и «цена iphone 15 pro» будут иметь более близкие векторы, чем «купить айфон 15» и «ремонт телефонов apple». Именно это свойство в дальнейшем позволяет использовать алгоритмы кластеризации для группировки запросов.
Коммерческие решения (OpenAI, Claude)
Для векторизации можно использовать как облачные API, так и локальные модели. Выбор зависит от объема данных, требований к качеству, доступной инфраструктуры и допустимой стоимости обработки.
Коммерческие API удобны тем, что не требуют локального развертывания модели и позволяют быстро начать работу. Провайдер берет на себя инфраструктуру, обновление моделей и масштабирование вычислений.
При небольших и средних объемах данных это один из наиболее простых вариантов. Однако при обработке сотен тысяч или миллионов запросов необходимо учитывать стоимость API, ограничения на количество запросов и пропускную способность.
К тому же при работе с API требуется использование отказоустойчивой архитектуры (обход лимитов API с помощью мультиаккаунтинга, ротация ключей и применение асинхронных запросов через aiohttp).
Вы можете самостоятельно протестировать, как коммерческие нейросети работают с ключами, с помощью этого кода.
import os
from openai import OpenAI

# Инициализация клиента
client_ai = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# Наш сырой датасет
queries = ["купить айфон 15", "цена iphone 15 pro", "ремонт телефонов apple"]

# 1. Векторизуем запросы через OpenAI
response = client_ai.embeddings.create(
    input=queries,
    model="text-embedding-3-small"
)

# На выходе получаем готовые многомерные векторы
embeddings = [data.embedding for data in response.data]
Локальные модели из экосистемы Hugging Face
Альтернативой коммерческим API могут быть открытые embedding-модели, которые запускаются локально. Для мультиязычных задач можно использовать, например, jinaai/jina-embeddings-v3 или Alibaba-NLP/gte-multilingual-large, которые не требуют затрат на генерацию.
from sentence_transformers import SentenceTransformer

print("⏳ 1. Загрузка стабильной модели BGE-m3...")
model = SentenceTransformer('BAAI/bge-m3')

queries = ["купить айфон 15", "цена iphone 15 pro", "ремонт телефонов apple"]

print(f"⏳ 2. Векторизуем {len(queries)} запросов...")
embeddings = model.encode(queries, normalize_embeddings=True)

print("\n✅ Готово! Давайте посмотрим на результат:")
print(f"📊 Размерность данных: {embeddings.shape}")
print("🔍 Вектор для фразы 'купить айфон 15':")
vector_preview = [round(float(num), 4) for num in embeddings[0][:5]]
print(f"🔢 {vector_preview} ... и еще {len(embeddings[0]) - 5} чисел.")
Главное преимущество локальных моделей заключается в том, что весь процесс обработки остается внутри собственной инфраструктуры. Вы обрабатываете поисковые запросы без передачи стороннему API, а после загрузки модели можете векторизовать их без оплаты каждого запроса.
Работать с локальными моделями часто оказывается выгоднее: они позволяют выполнять векторизацию без оплаты каждого обращения к API. Но при этом требуют заметного объема дискового пространства: вместе с весами и кэшем могут загружаться файлы размером в несколько гигабайт. Если модель больше не нужна, после завершения работы стоит удалить ее локальные файлы и очистить кэш.
Хранение и поиск векторных представлений
После векторизации каждый поисковый запрос представлен в виде embedding-вектора. Следующий вопрос — где хранить эти данные и как эффективно находить семантически близкие запросы.
Для небольших наборов данных векторы можно оставить в памяти, например в массивах NumPy или структурах Pandas. Если запросов всего несколько тысяч, этого обычно достаточно для экспериментов и локальной обработки.
С ростом датасета ситуация меняется. Если сравнивать каждый вектор со всеми остальными напрямую, количество операций растет квадратично. Для десятков и сотен тысяч запросов такой подход быстро становится ресурсоемким как по времени вычислений, так и по использованию памяти.
Эта проблема решается через векторные базы данных. Они оптимизированы специально под такие задачи и поддерживают алгоритмы приближенного поиска ближайших соседей (в частности, алгоритм HNSW). Встроенные индексы позволяют не сравнивать все векторы друг с другом напрямую, а обеспечивают практически мгновенный поиск самых похожих фраз даже среди миллионов записей.
Для таких задач существует несколько популярных решений: Pinecone, Qdrant, PostgreSQL с расширением pgvector и другие. В нашем примере будем использовать ChromaDB. Она хорошо подходит для локальных экспериментов: запускается без отдельного сервера, сохраняет данные на диск и легко интегрируется с Python-кодом.
Сохраним embeddings, полученные на предыдущем этапе, и проверим, как работает смысловой поиск:
import chromadb

# 1. Инициализация локальной базы (создаст папку semantic_db)
client = chromadb.PersistentClient(path="./semantic_db")

# 2. Создаем коллекцию
collection = client.get_or_create_collection(
    name="search_queries",
    metadata={"hnsw:space": "cosine"}
)

# 3. Загружаем наши векторы и тексты запросов
collection.add(
    embeddings=embeddings.tolist(), # векторы от нашей локальной модели BGE-m3
    documents=queries,
    ids=["id_1", "id_2", "id_3"]
)
print("✅ Данные сохранены в БД!\n")

# ==========================================
# МАГИЯ ПОИСКА: Проверяем, как база понимает смысл
# ==========================================
test_phrase = "сколько стоит новый iphone"
print(f"Ищем в базе фразу: '{test_phrase}'")

# Превращаем тестовую фразу в вектор той же моделью
test_embedding = model.encode([test_phrase], normalize_embeddings=True)

# Просим базу найти два самых похожих варианта
results = collection.query(
    query_embeddings=test_embedding.tolist(),
    n_results=2
)

print(f"Ближайший запрос: {results['documents'][0][0]} (Дистанция: {results['distances'][0][0]:.4f})")
print(f"Второй по близости: {results['documents'][0][1]} (Дистанция: {results['distances'][0][1]:.4f})")
Выбор алгоритма кластеризации
После получения embedding-векторов можно переходить к следующему этапу — группировке поисковых запросов. На этом шаге важно выбрать алгоритм, который соответствует структуре данных и не требует слишком жестких предположений о количестве будущих кластеров.
Почему K-Means не всегда подходит для SEO-кластеризации
K-Means — классический алгоритм кластеризации, который разбивает данные на заранее заданное количество групп. Количество кластеров задается параметром k.
Например, если у нас есть 10 000 поисковых запросов и мы укажем k=500, алгоритм сформирует 500 центроидов и распределит каждый запрос по ближайшему из них в векторном пространстве.
Основное ограничение такого подхода заключается в том, что количество кластеров необходимо определить заранее. Для семантического ядра это не всегда удобно: до начала обработки сложно понять, сколько самостоятельных групп интентов содержится в наборе — 50, 500 или 1 200.
Если значение k выбрано неудачно, связанные запросы могут оказаться разделены между несколькими группами. Возможна и обратная ситуация, когда близкие по тематике, но различающиеся по интенту запросы объединяются только потому, что алгоритм должен сформировать заданное количество кластеров.
Кластеризация с помощью DBSCAN
Если количество групп заранее неизвестно, можно использовать алгоритмы кластеризации на основе плотности. Один из наиболее известных вариантов — DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
В отличие от K-Means, DBSCAN не требует заранее задавать количество кластеров. Алгоритм ищет области в пространстве векторов, где объекты расположены достаточно близко друг к другу, и формирует из них группы.
Поведение DBSCAN определяется двумя основными параметрами:
eps(эпсилон/дистанция): максимальное расстояние между точками, при котором они считаются соседями. В нашем случае это порог косинусного сходства векторов.min_samples: минимальное количество соседей, чтобы образовать полноценный кластер.
DBSCAN берет первый случайный запрос. Если в радиусе eps от него есть min_samples других запросов, образуется ядро кластера. Алгоритм начинает расти во все стороны, захватывая новых соседей, пока плотность не иссякнет.
Параметр eps можно условно сравнить с настройкой жесткости кластеризации:
Меньший
epsсоответствует более строгой группировке. В один кластер будут попадать только очень близкие по векторному представлению запросы, поэтому групп обычно получается больше, а сами они становятся компактнее.Больший
epsделает условия объединения мягче. Кластеры становятся крупнее и могут включать более широкую семантику, но одновременно возрастает риск объединения запросов с различающимся интентом.
Еще одно полезное свойство DBSCAN — возможность выделять шум. Если запрос не находится в достаточно плотной области векторного пространства, алгоритм не пытается принудительно отнести его к одному из существующих кластеров, а помечает их как Outliers. Вы можете выгрузить их в отдельный файл для ручной проверки, вместо того чтобы портить чистые посадочные страницы.
При этом DBSCAN чувствителен к выбору eps: единый порог не всегда хорошо работает с данными, в которых одни группы расположены очень плотно, а другие значительно более разрежены.
В таких случаях можно рассмотреть HDBSCAN — иерархическое развитие плотностного подхода. Он умеет находить кластеры разной плотности, самостоятельно подстраивая параметр eps там, где запросы лежат кучнее или, наоборот, более разреженно.
Пишем скрипт кластеризации
Давайте извлечем наши векторы из локальной базы ChromaDB и прогоним их через DBSCAN с помощью библиотеки scikit-learn:
import chromadb
import numpy as np
from sklearn.cluster import DBSCAN

print("⏳ 1. Подключаемся к векторной базе...")
client = chromadb.PersistentClient(path="./semantic_db")

# Извлекаем коллекцию с векторами (укажите свое название)
collection = client.get_collection(name="search_queries")

# Извлекаем все тексты запросов и их математические векторы
data = collection.get(include=["documents", "embeddings"])
documents = data["documents"]
embeddings = np.array(data["embeddings"])

print(f"✅ Извлечено запросов из базы: {len(documents)}")

# ==========================================
# КЛАСТЕРИЗАЦИЯ (DBSCAN)
# ==========================================
print("⏳ 2. Запускаем алгоритм DBSCAN...")

# НАСТРОЙКИ:
# eps = 0.15 (Допустимое косинусное расстояние. Чем меньше, тем жестче кластеры);
# min_samples = 2 (Минимум 2 запроса для создания группы);
# metric="cosine" (Обязательно указываем, что измеряем углы между векторами, а не линейное расстояние).
dbscan = DBSCAN(eps=0.15, min_samples=2, metric="cosine")

# Запускаем группировку
labels = dbscan.fit_predict(embeddings)

# ==========================================
# ВЫВОД РЕЗУЛЬТАТОВ
# ==========================================
# Алгоритм присвоил каждому запросу номер группы (0, 1, 2...).
# Если запрос признан мусорным (Outlier), он получает метку -1.

clusters = {}
outliers = []

for doc, label in zip(documents, labels):
    if label == -1:
        outliers.append(doc)
    else:
        if label not in clusters:
            clusters[label] = []
        clusters[label].append(doc)

print("=== РЕЗУЛЬТАТЫ ГРУППИРОВКИ ===")
for cluster_id, docs in clusters.items():
    print(f"\n Кластер #{cluster_id} (Запросов: {len(docs)})")
    for d in docs:
        print(f"  - {d}")

if outliers:
    print(f"\n Выбросы/Шум (Запросов: {len(outliers)})")
    for out in outliers:
        print(f"  - {out}")
В примере выше используется локальная модель, однако при работе с коммерческими embedding-моделями значение eps может потребовать дополнительной настройки. В частности, порог 0.15, подходящий для одной модели, в другой конфигурации может привести к тому, что значительная часть запросов объединится в один крупный кластер или будет некорректно отнесена к шуму.
Поэтому при смене модели значение eps необходимо подбирать отдельно, ориентируясь на распределение расстояний между векторами и фактическое качество получаемых групп.
Гибридная кластеризация для разделения поискового интента
Кластеризацию можно строить только на основе embedding-векторов, однако на практике этого часто недостаточно. Семантическая близость не всегда означает совпадение поискового интента.
Например, запросы «купить антидетект-браузер» и «что такое антидетект-браузер» тематически очень близки. Embedding-модель корректно распознает, что обе фразы относятся к одному объекту, поэтому расстояние между их векторами будет небольшим. В результате DBSCAN с высокой вероятностью отнесет такие запросы к одному кластеру.
С точки зрения SEO это нежелательно, поскольку интент у запросов различается. Первый предполагает коммерческую посадочную страницу, второй — информационный материал.
Покажем это на небольшом тестовом наборе:
queries = [
    # Информационные
    "зачем нужны антидетект-браузеры",
    "что такое антидетект-браузер",
    "работа антидетект-браузеров",
    "сравнение антидетект-браузеров habr",

    # Коммерческие
    "купить антидетект-браузер",
    "купить прокси для антидетект-браузера",
    "антидетект-браузер триал",

    # Скачивание
    "скачать антидетект-браузер octo browser",
    "octo browser антидетект-браузер скачать",
    "octo антидетект-браузер скачать",

    # Запросы другой тематики
    "обзор ford everest 2024",
    "купить ford everest с пробегом",

    # Шум
    "погода в паттайе на май",
    "рецепт супа том ям"
]
При кластеризации только по векторной близости запросы, связанные с антидетект-браузерами, могут оказаться в одной группе, несмотря на различия в интенте.
На этом этапе антидетект-браузер снова становится частью пайплайна, но уже не для сбора семантики, а для получения SERP-данных. По каждому запросу необходимо собрать результаты поисковой выдачи, а затем использовать пересечение URL как дополнительный сигнал при кластеризации.
При большом количестве запросов такой сбор удобно распределять между изолированными браузерными профилями, например через Octo Browser в связке с Playwright или Puppeteer.
Для каждого запроса собирается топ-10 URL из поисковой выдачи. Затем перед запуском DBSCAN сравниваются результаты для семантически близких фраз. Если у двух запросов отсутствуют общие URL либо их количество ниже заданного порога, расстояние между соответствующими векторами искусственно увеличивается.
Таким образом, embeddings используются для поиска семантически близких запросов, а SERP выступает дополнительным ограничением и помогает не объединять фразы с различающимся поисковым интентом.
После добавления данных поисковой выдачи тестовый набор из предыдущего примера распределяется иначе:
Количество кластеров увеличивается, а сами группы лучше соответствуют предполагаемому интенту запросов.
Постобработка результатов и обновление данных
После формирования кластеров остается еще одна практическая задача — присвоить каждой группе понятное название. Номера вида «Кластер # 42» удобны для алгоритма, но мало что говорят SEO-специалисту, редактору или автору контента.
Автоматический нейминг кластеров с помощью LLM
При ручной работе специалисту приходится просматривать содержимое каждой группы, определять основной интент и формулировать название будущей страницы или материала. Если кластеров несколько сотен, этот этап занимает значительное время.
Эту часть процесса можно автоматизировать с помощью LLM. На вход модели передается список запросов из одного кластера, после чего она определяет общий интент и формирует подходящий заголовок. Для этого можно использовать как облачные модели, так и локальные решения, запускаемые, например, через Ollama.
Важно заранее задать модели строгий формат ответа. Если просто попросить ее придумать название, вместе с заголовком можно получить дополнительные пояснения и комментарии. Поэтому в системном промпте лучше явно указать, что на выходе должен быть только заголовок без дополнительного текста:
from openai import OpenAI

# 1. ИНИЦИАЛИЗАЦИЯ И КЛЮЧ
# Вставьте сюда ваш реальный ключ API
client_ai = OpenAI(api_key="sk-ВАШ_КЛЮЧ_ОТ_OPENAI")

# 2. НАШИ ДАННЫЕ (Результат гибридной кластеризации)
clusters = {
    0: [
        "зачем нужны антидетект-браузеры",
        "что такое антидетект-браузер",
        "работа антидетект-браузеров",
        "сравнение антидетект-браузеров habr"
    ],
    1: [
        "купить антидетект-браузер",
        "купить прокси для антидетект-браузера",
        "антидетект-браузер триал"
    ],
    2: [
        "скачать антидетект-браузер octo browser",
        "Octo browser антидетект-браузер скачать",
        "Octo антидетект-браузер скачать"
    ]
}

# Системный промпт (задаем правила для нейросети)
prompt = """You are an expert SEO specialist. Analyze the following cluster of search queries. Determine the primary user intent and generate one highly relevant H1 title for a future category page or article. Return ONLY the title, without any additional text, quotes or explanations."""

print("⏳ Отправляем кластеры на автонейминг в GPT-4o-mini...\n")

# 3. Проходимся по всем кластерам
for cluster_id, queries in clusters.items():
    # Отправляем запросы текущего кластера в API
    response = client_ai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": prompt},
            {"role": "user", "content": "\n".join(queries)} # Объединяем запросы в один текст
        ],
        temperature=0.3
    )

    # Получаем ответ
    h1_title = response.choices[0].message.content

    # Выводим результат в консоль
    print(f"Кластер #{cluster_id}")
    print(f"Фразы: {', '.join(queries)}")
    print(f"Сгенерированный H1: {h1_title}\n")
Для тестового набора результат может выглядеть следующим образом:
Кластер #0
   Фразы: зачем нужны антидетект-браузеры, что такое антидетект- браузер, работа антидетект-браузеров
   Сгенерированный H1: Для чего нужны антидетект-браузеры

Кластер #1
   Фразы: купить антидетект-браузер, купить прокси для антидетект- браузера, антидетект-браузер триал
   Сгенерированный H1: Лучшие антидетект-браузеры и прокси для безопасного серфинга

Кластер #2
   Фразы: скачать антидетект-браузер octo browser, Octo browser антидетект-браузер скачать, Octo антидетект-браузер скачать
   Сгенерированный H1: Скачать антидетект-браузер Octo Browser
В реальном проекте количество кластеров будет значительно больше, поэтому хранить исходные данные непосредственно в коде нецелесообразно. Обычно кластеры загружаются из файла или базы данных, а сгенерированные названия записываются обратно в таблицу для дальнейшей работы.
На этом этапе LLM не участвует в самой кластеризации — она используется только для постобработки уже сформированных групп. Это позволяет автоматизировать рутинную часть работы и получить понятную структуру семантического ядра без ручного нейминга каждого кластера.
Добавление новых запросов
Еще одно преимущество хранения embeddings в ChromaDB — возможность работать с новыми данными без повторного поиска ближайших соседей по всему набору вручную.
После получения новой порции семантики запросы проходят тот же пайплайн: очистку, векторизацию и добавление в ChromaDB. Для каждого нового embedding можно найти ближайшие существующие запросы и оценить расстояние до них.
Если найденные соседи относятся к устойчивому существующему кластеру и удовлетворяют заданному порогу близости, новый запрос можно присоединить к этой группе. Если подходящего кластера нет, запрос остается кандидатом на формирование новой группы или отправляется на дополнительную обработку.
Такой подход позволяет использовать уже накопленную векторную базу как индекс для обработки новых запросов и не выполнять полный попарный поиск по всему семантическому ядру при каждом обновлении.
Заключение
Создание собственного пайплайна на базе embedding-моделей, векторного хранилища и алгоритмов кластеризации требует времени на настройку, тестирование и подбор параметров. Однако после этого вы получаете систему, которую можно адаптировать под конкретную тематику, объем данных и требования проекта.
Основные преимущества такого подхода:
Снижение зависимости от специализированных сервисов. Для кластеризации не требуется отдельный SEO-сервис с фиксированными тарифами и ограничениями по объему. Основные ограничения переносятся на собственную инфраструктуру: вычислительные ресурсы, память и дисковое пространство.
Контроль над логикой кластеризации. Можно самостоятельно выбирать embedding-модель, настраивать
eps, учитывать данные SERP и изменять правила объединения запросов в зависимости от задачи.Контроль над данными. При использовании локальных моделей и локального хранилища семантика остается внутри собственной инфраструктуры и не передается сторонним API.
Главная ценность такого решения — не в полной замене готовых SEO-инструментов, а в возможности собрать собственный управляемый пайплайн. Используйте Octo Browser на этапе автоматизированного сбора семантики и SERP-данных, а дальнейшую обработку выполняйте локально — с помощью embeddings, ChromaDB и алгоритмов кластеризации.
Если один раз выстроить этот процесс и аккуратно настроить его на реальных данных, он превращается из разового скрипта в рабочий инструмент, который можно повторно использовать и масштабировать вместе с ростом семантического ядра.
Следите за последними новостями Octo Browser
Нажимая кнопку, вы соглашаетесь с нашей политикой конфиденциальности.
Следите за последними новостями Octo Browser
Нажимая кнопку, вы соглашаетесь с нашей политикой конфиденциальности.
Следите за последними новостями Octo Browser
Нажимая кнопку, вы соглашаетесь с нашей политикой конфиденциальности.
Присоединяйтесь к Octo Browser сейчас
Вы можете обращаться за помощью к нашим специалистам службы поддержки в чате в любое время.
Присоединяйтесь к Octo Browser сейчас
Вы можете обращаться за помощью к нашим специалистам службы поддержки в чате в любое время.
Присоединяйтесь к Octo Browser сейчас
Вы можете обращаться за помощью к нашим специалистам службы поддержки в чате в любое время.